
一句话总结:投机解码一次前向会并行验证多个 token,被接受的几个几乎同时到达,所以时间戳会聚成簇。从簇的大小分布能反推出草稿长度和接受率:模拟环境下,抖动 0ms 时反推 k=4、alpha=0.81(真值 0.80);抖动加到 6ms,k 虚高到 8,步长低估三成,方法基本失效。
前阵子有人问我:怎么判断一个 API 到底有没有真开投机解码。
这个问题不好答。服务商说开了,你在外面看不到日志、看不到 GPU 占用、看不到模型配置。能拿到的只有一串 token 到达时间。
但就是这串时间,其实说了不少东西。
一、可观测的只有时间戳,能反推什么
先说清楚场景。你是一个外部调用方,手里只有这些:
- 一条请求发出去
- 服务器开始流式返回
- 每个 token 到达的本地时间戳
其余全是黑盒。
投机解码恰好会在时间戳上留指纹。它的机制是:草稿模型先猜 k 个 token,主模型一次前向并行验证,接受其中连续的若干个。
被接受的这几个 token 是一次算出来的,所以几乎同时吐出。
普通自回归解码不是这样:一个 token 一次前向,间隔均匀。
所以两种模式的时间戳序列长得完全不一样:
| 自回归 | 投机解码 | |
|---|---|---|
| 间隔分布 | 均匀,都接近单步耗时 | 两极:簇内接近 0,簇间等于一步 |
| 能否从时间戳看出 | 看不出内部配置 | 能看出 k 和接受率 |
这就是可反推的基础。
二、先做一遍模拟:造一个已知配置的推理服务
我造了一个服务,参数是 k=4、接受率 0.8、每轮 20ms,让它吐 600 个 token。
关键在一轮到底产出几个:
n = 0
while n < k and rng.random() < alpha:
    n += 1
# 一轮实际产出:全接受就是 k 个;否则 n 个 + target 纠正的 1 个
produced = k if n == k else n + 1
这个细节很容易写错。很多人以为"接受 n 个就产出 n 个",其实当 n<k 时,主模型在验证完末尾那个草稿后会额外吐一个正确的 token,所以这一轮产出 n+1 个。
这个 +1 直接影响后面反解接受率的准确性。 我第一版就写错了,导致反推出来的 alpha 一直偏低 0.14。
把时间戳打出来,交给分析器,分析器只能看到时间数组。
三、聚类:投机解码在时间戳上的指纹
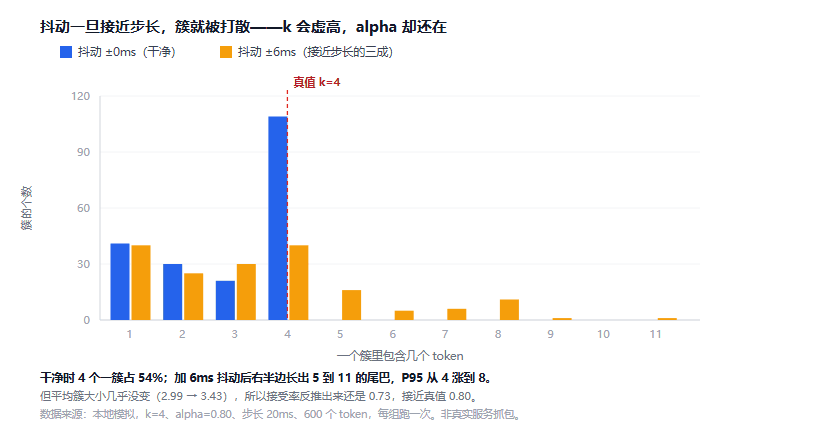
图 1:左边是干净的分布,右边是加了 6ms 抖动之后。尾巴长出来,说明簇被切碎了
分析分两步。
第一步,把时间戳切成簇。
做法是看相邻间隔:间隔小的归为一簇,间隔大的断开。难点在阈值怎么定——抖动会让簇内间隔不再是 0,固定阈值必错。
我用一维 KMeans 把间隔自动分成两类:
def kmeans_1d(vals, iters=40):
    """把间隔分成「簇内」和「簇间」两类,返回两类中心和分界"""
    c1, c2 = min(vals), max(vals)
    for _ in range(iters):
        g1 = [v for v in vals if abs(v - c1) <= abs(v - c2)]
        g2 = [v for v in vals if abs(v - c1) > abs(v - c2)]
        if not g1 or not g2:
            break
        c1, c2 = sum(g1) / len(g1), sum(g2) / len(g2)
    return c1, c2, (c1 + c2) / 2
第二步,从簇大小反解配置。
k 的估计用 P95,不用最大值。原因后面讲。alpha 用二分反解:
def expected_produced(alpha, k):
    """一轮的期望产出:n<k 时产 n+1 个,n=k 时产 k 个"""
    e = 0.0
    for n in range(k):
        e += alpha ** n * (1 - alpha) * (n + 1)
    e += alpha ** k * k
    return e
拿观测到的平均簇大小去拟合这个函数,反解出 alpha。
四、接受率稳,k 不稳,为什么
跑出来的结果有点意外。
| 抖动 | 反推 k | 反推 alpha | 反推步长 | k 误差 | alpha 误差 |
|---|---|---|---|---|---|
| ±0ms | 4 | 0.81 | 20.0ms | 0 | +0.01 |
| ±1ms | 4 | 0.83 | 18.5ms | 0 | +0.03 |
| ±3ms | 4 | 0.80 | 15.9ms | 0 | 0.00 |
| ±6ms | 8 | 0.73 | 13.3ms | +4 | -0.07 |
真值是 k=4、alpha=0.80、步长 20ms。
alpha 一直很稳,k 从 3ms 之后就开始飘。
原因是这两个参数依赖的东西不同:
alpha 依赖平均簇大小。抖动 0ms 时平均 2.99 个/簇,抖动 6ms 时 3.43 个/簇。抖动会让相邻簇粘连,簇数从 201 掉到 175,但平均大小只涨了 15%。所以反解出来的 alpha 还在合理范围。
k 依赖分布尾部的截断位置。干净的时候,簇大小分布是 1:41 2:30 3:21 4:109,到 4 就断了。加了 6ms 抖动之后,右半边长出 5:16 6:5 7:6 8:11 9:1 11:1 的尾巴——那是两个相邻簇粘在一起形成的假大簇。
用最大值估 k,抖动 6ms 时会得到 11。用 P95 才压到 8,还是比真值 4 高一倍。
所以结论是:接受率能从平均值可靠反推,草稿长度得靠分布形状,而分布形状最容易被抖动破坏。
五、抖动到 6ms,就基本失效
我把抖动往上加,看什么时候彻底不行。
| 抖动 | 反推 k | 反推 alpha | 反推步长 | 判断 |
|---|---|---|---|---|
| ±6ms | 9 | 0.76 | 15.3ms | 失效 |
| ±10ms | 11 | 0.79 | 16.8ms | 失效 |
| ±15ms | 11 | 0.81 | 15.8ms | 失效 |
| ±25ms | 12 | 0.81 | 17.1ms | 失效 |
有意思的是:alpha 从头到尾都在 0.76 到 0.81 之间,几乎没偏。 k 和步长全错。
步长的错法很统一:真值 20ms,全被估成 15 到 17ms。原因是 KMeans 把"簇间间隔"和"较大的簇内间隔"混在一类里,中心被拉低。
这个偏差方向要注意:它总是低估,不会高估。 因为混淆只会把簇间间隔和更小的值平均到一起。
所以如果你用这套方法估别人的服务,得到的步长是下限,真实值更大。
六、这套反推方法能用来做什么
三个实际用途。
判断服务商有没有真开投机解码。 看间隔分布是不是两极。如果全是均匀间隔,要么没开,要么开了但接受率极低(每轮只接受 1 个,退化成自回归)。
估自己的部署有没有跑偏。 你明明配了 k=8,反推出来是 4,说明大量轮次在第一两个 token 就被拒绝,接受率远低于预期,该去看草稿模型和主模型的对齐程度。
给推理服务做黑盒回归测试。 改了一版调度策略,token 质量没变但速度变了,用这套方法能看出是接受率变了还是步长变了。这比只看总耗时有信息量。
反过来说,它有三个做不到:
- 反推不出模型大小、参数量
- 反推不出用了几个 GPU
- 反推不出批处理策略(batch 大小对单请求的时间戳影响很小)
站内之前逆过投机解码的收益边界,那篇是从公式反推"要多快需要什么条件",这篇是从观测反推"现在是什么配置"。一个往下推,一个往上推。
还有一篇讲 SpecPilot 怎么让 Agent 自己调这套参数,它优化的是 τ 因子,也就是实际接受数和理论上能接受的最大数之间的差距。这篇的聚类方法正好能量出那个差距——你把反推出来的 k 和 alpha 代进公式,就知道当前配置离上限还有多远。
七、边界
这是模拟,不是真实抓包。 我造了一个已知配置的服务,然后尝试从它的输出反推。真实服务的抖动模式更复杂——不只是高斯噪声,还有 GC、批处理排队、网络重传造成的长尾。
600 个 token 的样本偏小。 簇只有 200 个左右,P95 的估计方差大。要稳定反推 k,样本量可能得上万。
我只测了均匀抖动。 真实网络里,间隔分布是长尾的,偶尔一次 200ms 的停顿会制造一个巨大的假簇,把 P95 直接顶上去。这种场景我没模拟。
"抖动接近步长就失效"这条结论有适用边界。 如果步长本身很长(比如 35ms 以上),同样绝对值的抖动影响就小。第二组交叉验证里,k=8、步长 35ms、抖动 1ms,k 反推成 6(偏低),alpha 反推 0.61(真值 0.60)。所以准确的说法是"抖动与步长的比值决定精度",不是绝对毫秒数。
反过来,这个方法也能被用来对付。 如果服务端想让外部看不出配置,只要在输出端加一点随机延迟就能打乱簇结构。我没测需要加多少延迟才够,但从实验结果看,抖动到步长的三成(6ms/20ms)就足够让 k 和步长都失真。
参考资料
- arXiv - SpecPilot: Autonomous Algorithm Discovery and Systems Optimization for Speculative Decoding
- vLLM - Speculative Decoding 文档
- RFC 6455 - WebSocket 协议(流式传输的基础)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。