
一句话总结:ERNIE-5.5-Flash-Base 用「每 128 个 token 只缓存一条」的压缩注意力,43 层里压了 37 层。我写了个计算器跑不同配置,发现压缩比从 1/128 提到 1/1024(8 倍),总 KV 只从 14.67% 降到 14.09%。但如果多压 3 层(37 到 40),能直接从 85.4% 跳到 92.3%。同样投入,多压一层比提高压缩比有用 11 倍。
看到「每 128 个 token 只存一条」这句话的时候,我第一反应是:省 128 倍。
拿计算器一按,发现不对。省 85%。
差了一个数量级。查了一下原因,发现这里有个很容易被忽略的结构性事实。
一、先写个计算器:压缩注意力的总 KV 怎么算
KV cache 的占用跟层数和 token 数成正比。压缩注意力的做法是:某些层不逐 token 存 KV,而是每 N 个 token 压成一条。
所以总占用可以这么算:
LAYERS = 43

def total_kv(compress_layers, ratio, layers=LAYERS):
    """返回相对「全部层都用普通注意力」的比例(0-1)"""
    f = compress_layers / layers              # 压缩层占比
    return (1 - f) + f / ratio

def save_pct(c, r):
    return (1 - total_kv(c, r)) * 100
两行就完了。核心是 (1 - f) + f / ratio:
(1 - f)是不压缩那部分,原样占着f / ratio是压缩那部分,被压小了
关键在第一项。 它不会因为压缩比变高而变小。
二、ERNIE 的 KV 账:省 85.4%,不是 128 倍
代进它的配置:37 层压缩,比例 1/128。
>>> total_kv(37, 128)
0.1463           # 14.63%

>>> save_pct(37, 128)
85.4             # 省 85.4%
拆开看:
压缩层贡献:(37/43) ÷ 128 = 0.67%
不压缩层贡献:(6/43) = 14.0%
合计:14.63%
那 6 层不压缩的,占了总 KV 的 95.4%。
这组数字和ERNIE 那篇算的是同一笔账,那边给的是结论,这里给的是「换个参数会怎样」。
37 层压缩之后,只剩 4.6%。看起来压缩很成功,但总账上,地板是那 14%。
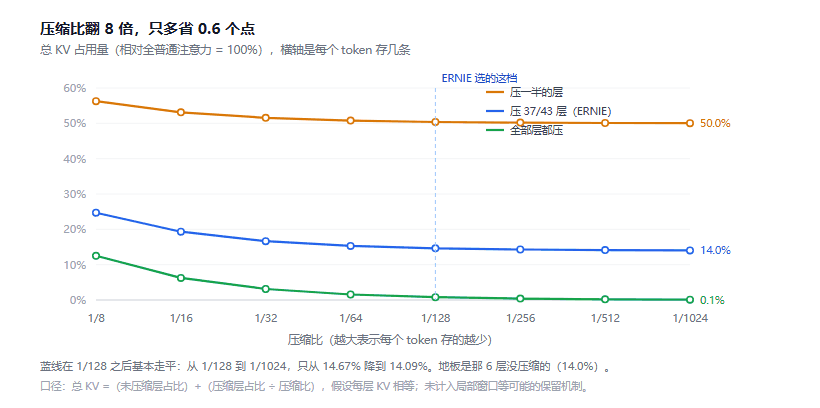
图 1:蓝线在 1/128 之后基本走平,因为地板压不下去
三、压缩比再翻 8 倍,只多 0.6 个点
这是我觉得最值得看的一段。
如果「压得越狠越好」,那把 1/128 提到 1/1024 应该还有大收益。实际算一下:
| 压缩比 | 总 KV | 节省 |
|---|---|---|
| 1/64 | 15.30% | 84.7% |
| 1/128 | 14.63% | 85.4% |
| 1/256 | 14.29% | 85.7% |
| 1/512 | 14.12% | 85.9% |
| 1/1024 | 14.04% | 86.0% |
从 1/128 到 1/1024,压缩比提高 8 倍,节省从 85.4% 到 86.0%,多了 0.6 个百分点。
而压缩比提高 8 倍意味着什么?每个 token 要表达的信息被压成原来的 1/8,信息损失是实打实的。拿 0.6 个点换 8 倍的精度损失,这笔买卖不划算。
这就是边际收益递减的典型形状:曲线在某个点之后变平,再投入就是浪费。
四、多压一层,比提高压缩比有用
换个方向试。不动压缩比,改成多压几层:
| 压几层 | 总 KV | 节省 |
|---|---|---|
| 30/43 | 30.78% | 69.2% |
| 37/43 | 14.63% | 85.4% |
| 40/43 | 7.70% | 92.3% |
| 43/43 | 0.78% | 99.2% |
从 37 层到 40 层,多压 3 层,节省从 85.4% 到 92.3%,多 6.9 个百分点。
对比一下:
压缩比 ×8(128→1024)     → +0.6 个点
多压 3 层(37→40)        → +6.9 个点
同样的工程量,多压一层比提高压缩比有用 11 倍。
这不是巧合,是数学必然:f / ratio 这一项已经被压得很小了,再压它,绝对值变化微乎其微;而 (1 - f) 这一项还没动过,动一点就是实打实的。
五、这个结论能推广到别的结构吗
能,但要看两个数。
第一个数:压缩层占比 f。 f 越小,提高压缩比的收益越低。如果只压了 10% 的层,那 f/ratio 本来就可忽略,怎么调压缩比都没用。
第二个数:压缩比已经到哪了。 如果还在 1/8 这种低压缩比,提到 1/32 收益很明显(从 24.75% 到 16.69%)。到了 1/128 之后才进入平台区。
所以判断方法很简单:算一次 (1-f),那就是你的地板。 地板以上的部分才是可优化的空间。
ERNIE 选 37 层 + 1/128,说明设计者已经算过这笔账——继续压比没意义,剩下的 6 层是故意留的。
我猜那 6 层承担的是需要完整注意力精度的任务(处理首个 token、跨段指代、精确位置)。压了就掉效果,所以宁可留着。
这个「知道在哪里停」的判断,比压缩比本身更能说明工程成熟度。
六、坑清单
1. 别把「压缩比」当成「节省比」。
1/128 的压缩比,节省是 85%,不是 99.2%。两者的差别就是那几层没压缩的。宣传材料上如果直接写「128 倍」,要问清楚分母是什么。
2. 每层 KV 不一定相等。
我的公式假设所有层 KV 一样大。实际模型里,不同层的 head 数、hidden 维度可能不同(比如有的层做 GQA,有的做 MHA)。真实值要用各层的实际配置加权算。
3. 压缩注意力可能保留局部窗口。
很多压缩方案不是「每 128 个 token 只留一条」,而是「局部 128 个 token 精确 + 更早的全部压缩」。如果是这种,实际 KV 会比我算的高,节省更少。我按纯压缩算的,这一条存疑。
4. 1M 上下文的可行性不等于可用性。
即使 KV 压到 15%,1M 上下文还有别的问题:注意力本身的计算量、位置编码的外推、检索精度下降。KV 只解决了「装不下」,没解决「看不准」。 这一点在8GB 跑 128K 那篇里提过:靠卸载能把门槛压下去,但速度掉到不能用。装得下和用得动,中间还隔着一段。
5. 压缩层的梯度传播更复杂。
训练时,压缩操作要能回传梯度。如果压缩是不可微的(比如硬采样),就得用 straight-through 之类的技巧,训练难度会上升。这块我从没实测过,纯属推测。
七、结语
这个计算器一共 10 行,跑完 30 秒,但它回答了一个我从发布稿里看不出来的问题:为什么是 37 层,为什么是 1/128。
答案很简单:再往上加,收益就没了。
工程上大量决策都是这个形状——不是「做到最好」,是「做到拐点」。拐点之前的每一分投入都有回报,拐点之后全是浪费。难点不在执行,在算出拐点在哪。
我这次的收获是一个可以反复用的问法:这个指标的地板是什么? 先算地板,再谈优化。
参考资料
- 快科技 - 百度文心 5.5 Flash Base 正式开源 - 43 层 / 37 层压缩 / 每 128 token 一条的原始口径
- 网易 - 百度文心 5.5 Flash Base 正式开源 - 混合稀疏注意力与多路由专家的补充说明
- vLLM 文档 - PagedAttention - KV cache 分页管理的基础参考,可用于对照压缩方案
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。