
一句话总结:HExA 把 Agent 拆成行动者、进化者、检索者三个角色,让经验沉淀成带可信度评分的技能条目。我用 4 位密码锁写了个 80 行的最小版,技能库确实把平均尝试次数从 12.1 次压到 4.2 次。但为了让技能不过时加 20% 探索,性能反而掉回 10.0 次,接近随机水平。
上个月有人问我一件事:为什么他那个 Agent 跑得越久越笨。
我看了下,问题出在它会把每次成功都当成经验存起来,但从来不删。三个月下来存了十几万字「经验」,每次都全塞进 prompt,真正有用的那几条被埋在中间。
HExA 这个框架给了个相反的答案:经验不是越多越好,要带评分,要能被检验。
我照着写了个最小版,结果跑出了点意外。
一、HExA 的三个角色:行动、进化、检索
框架的设计来自麻省大学的研究,思路是把「会做实验的研究员」拆成三个人。
行动者。 直接面对任务的那个。提假设、调用工具、和环境互动、观察结果。它只负责干活。
进化者。 不干活,专门看行动者的实验记录。从成功和失败里提炼规律,写成结构化的技能条目,存进技能库。
检索者。 在行动者开始新任务之前,从技能库里挑出最相关的几条推给它。
技能条目不是一句大白话,有固定结构:
| 字段 | 作用 |
|---|---|
| 名字 | 这条经验叫什么 |
| 原理 | 背后的物理或策略是什么 |
| 适用条件 | 什么情况下该用 |
| 例子 | 具体可以参考的案例 |
| 来源 | 基于哪些实验数据 |
| 可信度 | 一个 0 到 1 的分数 |
那个「可信度」是关键。没有它的技能库就是个垃圾桶,有了它才能排序、才能淘汰。
这一点和把 Agent 拆成文件那篇能对上:那篇把配置、提示、技能都落成文件,好处是可读可改;但文件本身不带评分,多了之后照样不知道哪条该信。文件化解决的是「存哪」,评分解决的是「信谁」。
二、最小版长什么样:4 位密码锁当环境
我用一个玩具环境替代真实任务:4 位二进制密码锁,真值固定(这里是 1011),每次猜一个组合,环境返回「对了几位」。
选这个环境的原因:反馈客观、可复现、不会因为模型能力波动。
三个角色对应到代码里就三个类:
@dataclass
class Skill:
    name: str
    pos: int          # 位置
    value: int        # 该位的值
    confidence: float # 可信度 0-1
    evidence: int     # 支撑样本数
    hit: int = 0      # 后续被检验次数
    refuted: int = 0  # 被推翻次数


class Evolver:
    """进化者:从高分区样本里提炼约束"""
    def evolve(self, history, min_evidence=3, threshold=0.85):
        good = [g for g, s in history if s >= 3]
        if len(good) < min_evidence:
            return []
        out = []
        for pos in range(BITS):
            vals = [g[pos] for g in good]
            for v in (0, 1):
                ratio = vals.count(v) / len(vals)
                if ratio >= threshold:
                    out.append(Skill(f"高分区第{pos+1}位恒为{v}",
                                     pos, v, ratio, len(good)))
return out进化者的逻辑很简单:看所有「答对 3 位以上」的尝试,如果某一位在 85% 的情况下都是同一个值,就把它记成一条技能。
真值是 1011,那么答对 3 位以上的猜测只有 5 个(它本身 + 改错一位的 4 个)。第 3 位在这 5 个里全是 1,所以能提炼出「第 3 位=1」。
检索者按可信度排序,取前两条,把约束合并成一张表:
class Retriever:
    def pick(self, skills, top_k=2):
        ranked = sorted(skills, key=lambda s: (-s.confidence, -s.evidence))[:top_k]
        merged = {}
        for s in ranked:
            merged.setdefault(s.pos, s.value)
        return ranked, merged
行动者拿到约束后,只在满足约束的空间里猜:
def guess(self, constraint, explore=False):
    if constraint and not explore:
        pool = [g for g in ALL_GUESSES
                if all(g[p] == v for p, v in constraint.items())]
    else:
        pool = ALL_GUESSES
    return self.rng.choice(pool)
一共 80 行左右。全部代码在工作区跑过,随机源用 sha256 派生,两次运行结果一致。
三、技能库把尝试次数压到 1/3
先跑最干净的一组:不加探索,纯利用技能库。
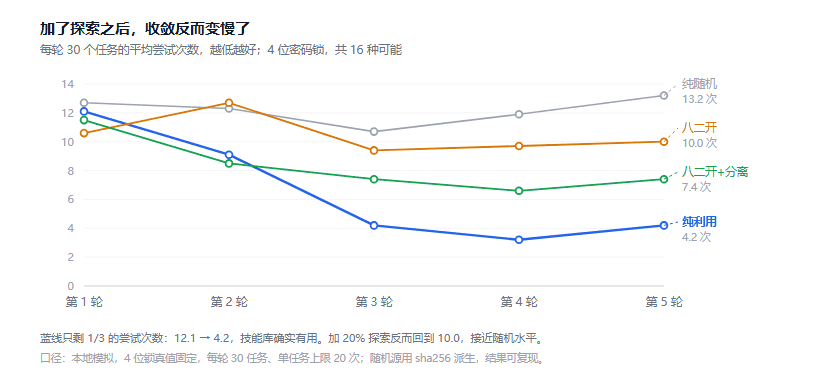
图 1:蓝线(纯利用)第 3 轮开始断崖式下降,其余三条基本是平的
| 轮次 | 技能库 | 平均尝试 | 30 个任务解出 |
|---|---|---|---|
| 第 1 轮 | 0 条 | 12.1 次 | 21 |
| 第 2 轮 | 0 条 | 9.1 次 | 26 |
| 第 3 轮 | 2 条 | 4.2 次 | 30 |
| 第 4 轮 | 2 条 | 3.2 次 | 30 |
| 第 5 轮 | 2 条 | 4.2 次 | 30 |
12.1 降到 4.2,接近 3 倍。
注意第 2 轮那行:技能库还是空的,平均尝试却从 12.1 掉到 9.1。这是随机波动,不是学习效果。真正的转折发生在第 3 轮,也就是技能第一次进库的那一轮。 单看任何一轮的均值都会误判,这也是为什么下面所有对比都至少跑满五轮。
对照组是纯随机(每轮 30 任务,全部不用技能库):12.7 / 12.3 / 10.7 / 11.9 / 13.2 次,五轮下来没有任何变化,末轮甚至比首轮还慢(随机波动)。
这个结果符合预期。4 位锁一共 16 种可能,纯随机平均要猜 16 次(截断在 20 次,所以实测 12 到 13)。锁定 1 位后空间减半到 8 个,锁定 2 位后剩 4 个,理论平均 4 次——实测 4.2,对得上。
四、加了探索之后为什么变慢
问题出在第二步。我担心一件事:技能一旦生效,是不是就再也不会被检验了?
如果所有猜测都遵守「第 3 位=1」,那这条技能永远不会遇到反例,错了也不知道。
所以加了个探索机制:每次猜测有 20% 的概率不看约束,全空间随机。这样能持续检验技能。
结果和预期相反:
| 策略 | 末轮平均尝试 | 学到几条 |
|---|---|---|
| 纯随机 | 13.2 次 | 0 |
| 纯利用 | 4.2 次 | 2 |
| 八二开 | 10.0 次 | 1 |
加了 20% 探索,性能从 4.2 掉到 10.0,几乎退回随机水平。
而且技能还学得更少了(2 条变 1 条)。
我一开始以为是我代码写错了,查了一遍发现不是。原因有两个,都很实在。
第一个原因:探索的成本是固定的,收益是概率的。
锁只有 16 种可能,随机探索一次猜中的概率是 1/16。而遵守约束的猜测,空间已经缩到 4 个,命中概率 1/4。探索一次的期望成本是遵守约束的四倍,收益只是「可能会推翻一条本来 89% 可信的技能」。
用一个 11% 的收益去换四倍的成本,怎么算都亏。
第二个原因:探索样本污染了进化者的判据。
进化者的逻辑是「高分区样本里某一位的稳定性」。但探索出来的猜测不遵守约束,会混进高分区。原本 5 个高分样本里第 3 位全是 1,掺进两个第 3 位是 0 的之后,比例掉到 0.85 以下,这条技能就提炼不出来了。
我起初没料到这一点。 我以为探索只是「少猜对几次」,没想到它同时降低了学习质量。
五、探索样本怎么和技能提炼分开
找到原因后改一版:探索出来的记录单独存放,不喂给进化者。
| 策略 | 末轮平均尝试 | 学到几条 |
|---|---|---|
| 纯利用 | 4.2 次 | 2 |
| 八二开(混着喂) | 10.0 次 | 1 |
| 八二开 + 分离 | 7.4 次 | 1 |
救回了一部分(10.0 → 7.4),但还是比纯利用差。
技能数没增加,因为分离之后进化者能用的样本少了 20%,达到 85% 阈值更难了。样本变少会降低提炼成功率,这个副作用我没预料到。
这组数据让我改了个判断: 探索不是免费的保险。只有当技能真的会过时时,它才值得买。
判断标准我给一个可以操作的:看技能被推翻的比例。
这轮实验里,纯利用策略下的技能被检验了 973 次,推翻 19 次,推翻率 1.95%。低于 2%,说明技能很稳,这时候探索是净亏损。
如果推翻率超过 10%,说明环境在变、技能在失效,那时候探索就是必需的。
六、这套实验搬到真实 Agent 上差什么
三件事差得远。
一,搜索空间。 4 位锁是 16 种可能,真实的 Agent 任务空间是无穷的。空间越大,探索的收益越高——因为「随机试一下」可能试到人想不到的路子。
二,反馈质量。 这里每次猜测都有明确反馈(对了几位)。真实任务里,「这个方案好不好」往往没有即时反馈,甚至没有正确答案。没有反馈就没法算可信度。
三,技能的生命周期。 密码锁的真值永远不变,技能可以永久有效。真实环境里 API 会改、库会升级、业务会变,技能会过期。过期这件事在这个玩具环境里根本测不出来,这也是我这组数据最大的局限。
所以「探索是亏的」这个结论,只在这个环境里成立。搬到真实场景,结论可能反过来。
这一点和上下文压缩那篇是同一类问题:分层压缩保住了全部约束,代价是压缩率只有 36.7%。省成本和保信息永远在拉扯,没有免费的方案。
七、坑清单
1. 用 hash() 派生随机种子,结果不可复现。
Python 的字符串哈希每次启动都加了随机盐,hash((seed, tuple(out))) 两次运行结果不同。文章里贴的数字就没法复现了。改用 int(sha256(k).hexdigest()[:8], 16)。
2. 约束叠加会冲突,得有回退。
两条技能都锁第 3 位、值不同时,约束表里只会留一条(setdefault 先到先得),但真实系统里可能出现互斥约束。我的做法是:过滤后池子为空就退回全空间,同时记一条告警。这个兜底不能省,否则会直接崩。
3. 技能只增不减,库会烂掉。
我这版没实现淘汰。跑了 5 轮只有 2 条技能还好,跑 500 轮就会堆满低质量条目。要加两个机制:置信度低于阈值的定期清理,以及长时间没被检验的技能降权。
4. 进化者的阈值不能拍脑袋。
85% 这个数是试出来的。设 90%,一条技能都提炼不出来;设 75%,会把噪声当成规律。阈值应该跟样本量挂钩,样本少时阈值要高,样本多时可以降。
5. 别把「学到的技能」直接塞进 prompt。
我的技能条目是结构化的,塞进去只占几十 token。如果换成自然语言描述,一条就上百 token,十几条就把上下文吃掉了。这也是 Skill 那类设计要分层的理由。
八、结语
这个实验最有价值的部分不是「技能库有用」(这是显然的),是「探索反而更差」这个反直觉的结果。
它说明一件事:在经验可靠、空间有限的场景里,利用比探索划算。这跟我们平时听到的「要留探索空间」是反的。
我不觉得这条结论能推广。它成立的前提很窄:反馈即时、空间有限、真值不变。三个条件任何一个不成立,探索就该回来。
但正因为窄,它反而提醒了一件事:「该不该探索」不是原则问题,是算账问题。 算清楚探索的成本和收益,比记住一条原则有用。
参考资料
- 搜狐 - 麻省让 AI 学会「做实验」 - HExA 三角色架构与技能库字段的原始转述
- OpenAI - Building effective agents - Agent 设计模式的通用参考
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。