
一句话总结:我给自己的 12 个 Python 脚本写了个引用体检器,查硬编码路径和重复常量。第一版按「字符串长得像不像路径」找,7 处命中里只有 1 处是真的,误报率 86%。第二版改成按「字符串被用来干什么」找,误报清零了,但真问题也漏了,精确率 0%。
上周发文章时踩了个坑:图片全挂了。
查下来是 md2zblog.py 里有个默认值写着 /zb_users/upload/2026/10。10 月的路径,当时是 11 月。
我天天用它,但那天空了一次 --media= 参数,直接吃到了这个过期的默认值。
这件事之后我想写个体检器,把这类问题提前扫出来。结果写了两版,都不太成功,但失败的过程比成功有意思。
一、代码引用体检查什么:三类引用
先定义范围。脚本里的「引用」有这三类:
| 类型 | 例子 | 断了会怎样 |
|---|---|---|
| 硬编码绝对路径 | C:/Users/.../python.exe | 换机器就挂 |
| 跨脚本调用 | subprocess.run([PY, "tools/md2zblog.py"]) | 改名就挂 |
| 重复常量 | 站点 URL 在 3 个文件里各写一遍 | 改域名要动 8 处,必漏 |
第三类不是「断链」,是「未来的断链」。它现在能跑,但改一次要动很多地方,漏一处就出线上事故。
三类里最该先查的是第一类,因为它最隐形:代码能跑,只是跑出了错误结果。
二、第一版按值找:7 处命中,1 处是真的
V1 的思路很直接:用 ast 把每个文件里的字符串常量全捞出来,看谁长得像路径。
PATH_WIN   = re.compile(r"^[A-Za-z]:[/\\][\w./\\\-\u4e00-\u9fa5]+$")
PATH_POSIX = re.compile(r"^/(?:[\w.\-]+/)+[\w.\-]*$")
FILE_LIKE  = re.compile(r"^[\w.\-/\\]+\.(py|md|png|jpg|svg|json|txt|html)$", re.I)

def classify(val):
    v = val.strip()
    if URL_LIKE.match(v):        # http(s):// 开头不当路径
        return None
    if PATH_WIN.match(v) or PATH_POSIX.match(v):
        return "abs_path"
    if FILE_LIKE.match(v):
        return "file"
    return None
命中之后判存在性:绝对路径直接 os.path.exists,裸文件名就在三个位置找(工作区根、脚本同目录、tools/)。
跑 7 个工具脚本,结果是这样:
=== 悬空引用:4 处 ===
  md2zblog.py:24       /zb_users/upload/2026/10   <- 绝对路径不存在
  md2zblog.py:209      .zb.html                   <- 文件没找到
  publish_online.py:103 .zb.html                  <- 文件没找到
  svg2png.py:68        _svgwrap.html              <- 文件没找到
扩大到整个工作区 12 个文件,命中 7 处:
  skill_lint.py:93     SKILL.md       <- 文件没找到
  skill_lint.py:103    SKILL.md       <- 文件没找到
  skill_lint.py:104    SKILL.md       <- 文件没找到
  md2zblog.py:24       /zb_users/upload/2026/10  <- 绝对路径不存在
  md2zblog.py:209      .zb.html       <- 文件没找到
  publish_online.py:103 .zb.html      <- 文件没找到
  svg2png.py:68        _svgwrap.html  <- 文件没找到
我一条条人工看了。
.zb.html两处,是后缀名,不是文件。程序里用md[:-3] + ".zb.html"拼出来_svgwrap.html一处,是tempfile生成的临时文件名SKILL.md三处,是目录里要找的文件名,不是要打开的具体文件/zb_users/upload/2026/10一处,是真的
7 处命中,1 处真实,误报率 86%。
那个真的就是开头那个坑:DEFAULT_MEDIA = "/zb_users/upload/2026/10",写死在文件第 24 行。
三、第二版按用途找:误报清零了,真问题也漏了
误报率 86% 显然不能接受。我想了个改进:别管值长什么样,看它被拿去干什么。
具体规则三条:
- 出现在
open()、os.path.*、subprocess.run()参数里的字符串 - 赋值给名字里带
path/dir/file/root的变量 os.path.join()里以/开头的片段
FILE_OPS = {"open", "join", "exists", "isfile", "isdir",
            "dirname", "abspath", "basename", "run", "Popen", "listdir"}
PATH_HINT = ("path", "dir", "file", "root", "output", "dest")

if isinstance(node, ast.Call):
    name = call_name(node)
    if name in FILE_OPS:
        for arg in node.args:
            if isinstance(arg, ast.Constant) and isinstance(arg.value, str):
                hits.append((arg.lineno, arg.value, f"{name}() 参数"))

if isinstance(node, ast.Assign):
    for t in node.targets:
        if isinstance(t, ast.Name) and any(h in t.id.lower() for h in PATH_HINT):
            if isinstance(node.value, ast.Constant):
                hits.append((node.lineno, node.value.value, f"赋值给 {t.id}"))
跑出来:
=== 命中 2 处 ===
  skill_lint.py:104    「SKILL.md」     来源:join() 参数|目标没找到
  svg2png.py:68        「_svgwrap.html」来源:join() 参数|目标没找到
2 处,全都是误报,精确率 0%。
更糟的是,那个真问题也漏了。
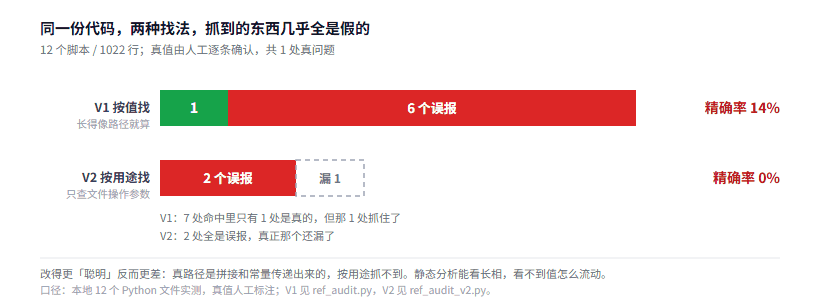
图 1:V1 是「抓到一个真的,顺带 6 个假的」,V2 是「一个真的没抓到,两个假的」
| 版本 | 命中 | 真问题 | 误报 | 漏报 | 精确率 |
|---|---|---|---|---|---|
| V1 按值 | 7 | 1 | 6 | 0 | 14% |
| V2 按用途 | 2 | 0 | 2 | 1 | 0% |
改得更「聪明」,两个指标都变差了。
四、静态分析为什么抓不住真路径
原因说穿了很简单:真路径不是字面量,是算出来的。
那个过期默认值长这样:
DEFAULT_MEDIA = "/zb_users/upload/2026/10"     # 第 24 行,定义
...
site, media = DEFAULT_SITE, DEFAULT_MEDIA      # 第 200 行,使用
V2 的三条规则,一条都覆盖不到它:
- 它没出现在
open()里(它是 URL 路径,会被拼进 HTML) - 变量名是
DEFAULT_MEDIA,不含 path/dir/file/root(我的PATH_HINT没包含 media) - 它没进
os.path.join()
而 V1 之所以能抓到,纯粹因为它长得像路径。
这就是静态分析的边界:能看「值长什么样」,看不见「值怎么流动」。
想抓流动,得做数据流分析——追踪这个常量被赋给了谁、传给了哪个函数、最终用在哪。这已经不是 lint 的活儿了,得上真正的程序分析工具,成本高一个量级。
我试过补 media 到 PATH_HINT,行为会变成:只要变量名带 media 就当路径查。但项目里叫 media_url、media_type 的变量也会被误判——换一种误报,不是消除误报。
这类「改一个指标就把另一个指标搞坏」的情况,和上下文压缩那篇算的是同一笔账:分层压缩保住了全部约束,代价是压缩率只有 36.7%。没有全都要的选项,只有把代价放在哪的选择。
五、顺手查出的两个真断链
虽然工具不太行,但人工看那 7 条的时候,发现了两个值得修的东西。
第一个:默认值停在了一个月前。
DEFAULT_MEDIA = "/zb_users/upload/2026/10"。现在已经是 11 月了。
这个默认值只在「忘了传 --media=」时生效。而 publish_online.py 每次都传,所以主流程没问题。但 md2zblog.py 单独用(本地站那条备用通道就是这么用的)就会吃到它,所有图片 URL 指向 10 月目录,全部 404。
这不是「现在的 bug」,是「未来的 bug」。 它躺在那里,等着某天有人忘了参数。
第二个:站点 URL 硬编码了 8 处,三种写法。
https://www.zhaixingw.cn                                  4 处
https://www.zhaixingw.cn/zb_users/plugin/zblogMcp/mcp.php  3 处
https://www.zhaixingw.cn/{CATE_ALIAS[cate]}/{tid}.html     1 处
分布在 3 个文件(fix_links_online.py 4 处、publish_online.py 2 处、seo_check.py 2 处)。
换域名那天,要改 8 个地方。 而且第三种是模板拼接,{CATE_ALIAS[cate]} 这种写法在全文搜索里根本搜不到分类目录加编号那种真实 URL(形如 域名/分类/数字.html),最容易漏。
修法很简单:抽一个 SITE 常量到一个 config.py,三个脚本都从那里 import。十五分钟的事。
六、坑清单
1. 后缀名会被当成文件路径。
.zb.html、.svg、.md 这类以点开头的字符串,在「文件」规则下全部命中。必须要求点前面有字符,且整串至少含一个 / 或长度合理,否则一律当后缀。
2. URL 里的路径片段会被当成绝对路径。
/zb_users/upload/2026/10 既是「URL 路径前缀」也是「本地绝对路径的形态」,两者字面上一模一样。我的临时补丁是遇到 /zb_users、/www、/home、/var 开头就跳过本地检查——这是硬编码白名单,换项目就失效。
3. 行号会漂。
ast 给的行号是字符串所在的物理行。如果一个长字符串跨行(三引号),行号指向起始行,人工核对时会找错位置。
4. 别把清单当错误清单。
这是最重要的一条。工具输出的是「待查清单」,不是「错误清单」。 我这次 7 条命中里 6 条要人看一眼才知道是假的,这个人工成本跑不掉。
把误报当错误直接改,会改坏代码。比如把 .zb.html 改成 .html,整个发布流程就崩了。
5. 漏报比误报危险。
误报你要多看两眼,漏报你根本不知道它存在。V2 精确率 0% 但漏了真问题,比 V1 更不可靠——因为 V1 至少让你看见了那 7 条,你还有机会人工筛。V2 只给你 2 条,你以为查完了。
这一点和扫 83 个 Skill 那次是同一个教训:那次七成有问题的结论靠的是「先全量扫、再按类型拆」,如果一上来就把规则收窄到「只报确定的问题」,那些断链根本不会出现在报告里。
七、结语
两版都不算成功,但结论挺清楚:
用 lint 查断链,只能当天花板很低的第一道网。 它能捞出「长得像路径的垃圾」,但真正的路径往往藏在变量和拼接里,恰恰是它看不见的地方。
真正管用的做法是另一条路,publish_online.py 里已经在用:在关键节点加硬校验,让错误在运行时炸出来。 比如发布前检查正文里有没有 {S} 这类没替换的模板变量,有就中止。
那个检查是确定性的:它知道「这个字符串必须被替换过」,不需要猜。比静态扫描准得多,因为它有语义。
两者配合才合理:静态扫描负责「没事的时候翻翻旧账」,运行时校验负责「出事的时候拦住」。指望前者当主力,就会像我这次一样,写了两版都白费。
代码留在工作区了,ref_audit.py 是 V1,ref_audit_v2.py 是 V2。想拿去改自己项目的话,建议只保留「重复常量」那部分——它不判存在性,只数次数,几乎不会误报。
参考资料
- Python 文档 - ast 模块 - 语法树节点结构与
ast.walk用法 - Python 文档 - os.path - 路径判定与拼接的标准库参考
- Ruff 文档 - 规则索引 - 成熟 lint 工具怎么划规则边界,可对照本文的取舍
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。