
一句话总结:Anthropic 同一天放出 Claude Fable 5.2 和 Mythos 5.2,底层是同一个模型,差别只在护栏。官方给的三组对比里,两组的核心卖点是「用更少的算力打平或超过」,不是模型更聪明。
11 月 22 日,Anthropic 发布 Claude Fable 5.2 和 Claude Mythos 5.2。两个名字,一个底座。
官方原话写得很直:Fable 和 Mythos 是同一个底层模型,Fable 带更强的网络安全与生物领域护栏,用来挡滥用;Mythos 则放开这些能力,只对通过 Cyber Verification Program 的客户开放。
这条产品逻辑值得单独说:同一个模型,按风险切成两个 SKU,护栏位置决定了谁能用、用多深。
一次发两个名字,卖的是准入资格
把模型能力当成一条连续的线,Fable 是在某个位置截断的版本,Mythos 是不截断的版本。截断的地方在网络安全和生物两块。
对普通开发者来说,这个区分几乎没有感知,日常写代码、分析文档拿到的是同一个底座。对安全研究团队来说,差别很大:Mythos 被官方定位成「网络安全工程最强」,能独立复现已公布 CVE,接入走 CVP 和 Claude Code 的安全扫描链路。
这其实回答了一个老问题:模型越强,厂商怎么卖?答案是分层卖,而不是不给。
跑分要横着读
官方给了一张和自家 Opus 5.5 的对比表。
三处数字最值得看,因为它们同时给了分数和成本。
FrontierCode 2.0 测的是代码改动能不能被开源仓库维护者合并。高 effort 下,Fable 5.2 拿 45.3%,Opus 5.5 最好成绩 45.5%,基本打平;成本大约是后者的一半。
Chartography 测读图表的能力。Fable 5.2 在中 effort 下拿 66.4%,超过 Opus 5.5 在最高 effort 下的 64.4%,成本不到十分之一。
BenchCAD 2.1 测硬件设计,分数 0 到 100。Fable 5.2 拿 83.5,Opus 5.5 是 65.3,上一代 Fable 5.1 只有 44.4。
这三组放在一起看,结论不是「更强」,而是「同等水平的算力花得更少」。Anthropic 上市那两天的价格曲线我也记过一笔,厂商叙事和市场定价经常不同步。
FrontierCode 那组甚至是略输 0.2 个百分点。一个跑分点证明不了全面压过,这个判断在这里依然成立。
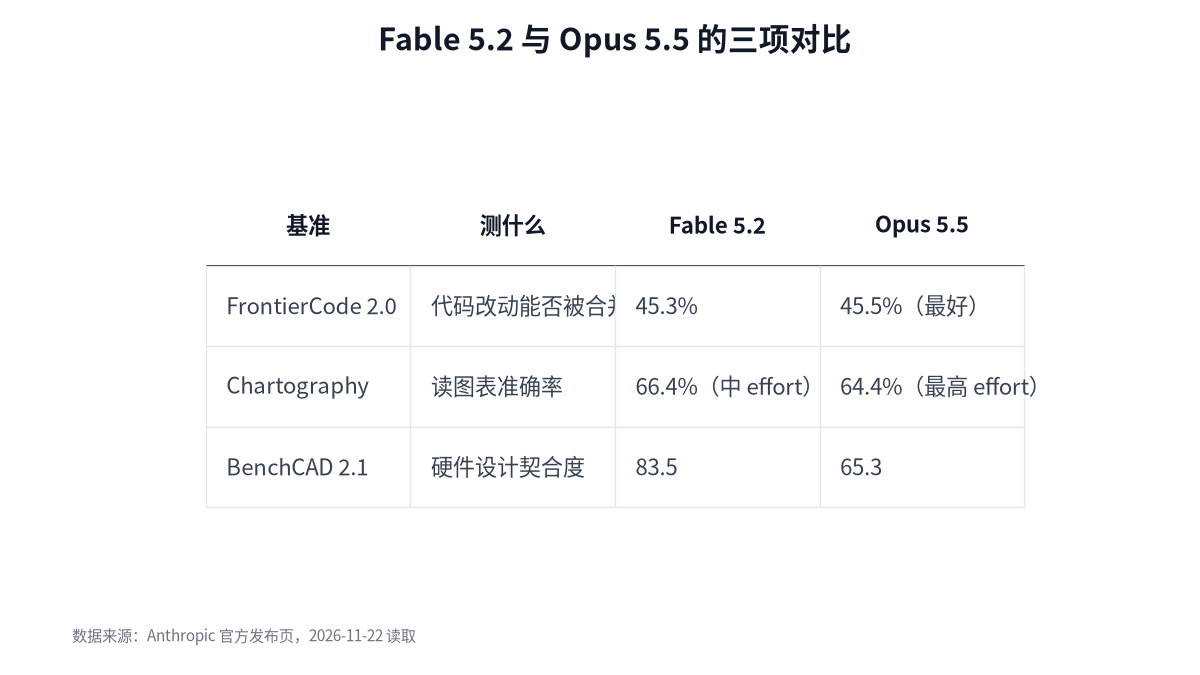
图 1:三组对比里,两组是「用低 effort 打对方高 effort」,比的是成本效率。数据来源:Anthropic 官方发布页,2026-11-22 读取
跑分之外还有速度这一栏。
两个模型都比上一代快:输出速度提升最多 30%,价格更低(原文只说更低,没给常规档的具体数字)。
另外有个可选的 fast mode,把 token 生成速度压到最多 2.5 倍。代价写得很明确:每百万输入 token 16 美元,每百万输出 token 80 美元。
这个价位不适合日常调用。
它对应的是那类「等结果的时间比算力值钱」的场景,比如交互式调试、长时间的 agent 循环。 快模式覆盖 Claude Code、Claude Platform、Google Cloud 上的 Claude、以及 Microsoft Foundry,但不是所有账户都能开。
官方自己报了一个数:90%
发布页里有句话比跑分更有信息量:合并进 Anthropic 核心代码库的改动里,超过 90% 现在由 Claude 写,人负责引导。
后面还跟了一串内部案例。一个工程师让模型从空目录开始设计原型操作系统;另一次让模型跑 10 到 12 小时的安全审计,放出约 170 个审查代理,最后交回报告、修复 PR 和策略文档。
这些是厂商自述,我没法验证。但它至少说明一件事:这些模型被用在自己身上,且用在核心路径上。
护栏放在哪,决定谁能用
Fable 5.2 带分类器,会拦高风险网络行为,包括渗透测试。这条对企业安全团队不算好消息,意味着红队工作还是得走 Mythos 那条线。
另一处变化在防蒸馏。官方说新增了保留 thinking 的机制,防止有人改上下文去套推理过程;还扩大了使用数据窗口监控的 API 能力,宣称把被蒸馏的数据量降了 90% 到 99%。
这个百分比同样是官方口径。方向我信,具体数字我保留。
我拿不准的三件事
第一,交付上限。发布页强调的是「用更少 token 做同样的活」,没给绝对能力的跃升幅度。如果你要的是天花板,这份材料回答不了。
第二,成本比较的口径。所有「一半成本」「十分之一成本」都是每任务成本,不是每 token 价格。任务长度不同,换算出来的账会变。这点我算不出准数,因为没拿到单价全表。
第三,基准的独立性。FrontierCode、BenchCAD、WANDR 这些要么自建、要么深度参与,横向比时只能当参考。
我的判断:这次发布的真正意义在工程侧,两个模型一个底座、按护栏分层、快模式单独定价,都是产品化动作,不是能力跃迁。
FAQ
Q:Fable 5.2 和 Mythos 5.2 有什么区别?
底层同一个模型。Fable 带网络安全与生物领域护栏,Mythos 去掉这层限制,只向通过 CVP 的客户开放。
Q:fast mode 贵多少?
每百万输入 16 美元、输出 80 美元,官方没给和常规档的差价比例,只说常规档比上一代更低。
Q:现在能用吗?
官方说发布当天在所有平台可用,包括 AWS、Google Cloud 和 Azure;快模式不是所有账户都开放。
参考资料
- Anthropic · Introducing Claude Fable 5.2 and Claude Mythos 5.2(跑分、定价、护栏与内部案例的出处)
- Anthropic Newsroom(同期发布的其他公告入口)
口径与核验:跑分 45.3 对 45.5、66.4 对 64.4、83.5 对 65.3、上一代 44.4、快模式 16 与 80 美元、90% 核心代码、170 个审查代理、90% 到 99% 蒸馏降幅、30% 与 2.5 倍这些数字,全部逐条对照 Anthropic 官方发布页,读取时间为 2026-11-22。
常规档的具体价格原文未给,我没有替它补。基准的独立性与每任务成本口径,我标成了存疑,没有按官方叙述转述。厂商自测的结果我未能复现。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。