
一句话总结:Anthropic 让 69 个员工的 AI 代理在内部市集里替人讨价还价,一周成交 186 笔、总额刚过 4000 美元。换更弱的代理,人被压价、成交更少,但事后受访时当事人自己没察觉。
这个实验叫 Project Deal。场地在旧金山办公室,形式像内部跳蚤市场,只有一处不同:所有交易都由 AI 代理完成。
为期一周,69 个代理,500 多件挂出的物品,最后成交 186 笔,总额刚过 4000 美元。
真正有意思的部分不在成交额。他们在同一批人身上偷偷跑了三组对照,换了代理背后的模型。
实验是怎么搭的
市场建在 Slack 里。
一个频道轮转展示代理挂出的物品,代理自己写描述、定价、还价,人只负责一开始授权「我的东西可以卖」。有个代理在描述里写「19 个乒乓球,不多不少正好 19 个,啤酒乒乓和手工项目都合适」。
四组同时开跑:一组是真市场,物品真的会交换;另外三组只做研究用,不实际成交。 先做完问卷,才告诉参与者哪一组是真的。这一步设计得挺讲究,避免人提前知道结果影响判断。
试验里所有代理的模型配置相同,只有对照组改模型:一组用当时的旗舰 Opus 4.5,一组用最小的 Haiku 4.5。
结论一:代理强,人得的多
用更强模型的那批人,客观结果更好。官方给的估计是:Opus 用户平均多成交 2.07 笔(p = 0.001),回归用了人的固定效应。
这个 2.07 是把「同一个人在不同组的表现」拉平之后算出来的,所以不是「爱买卖的人恰好分到 Opus」这种解释。
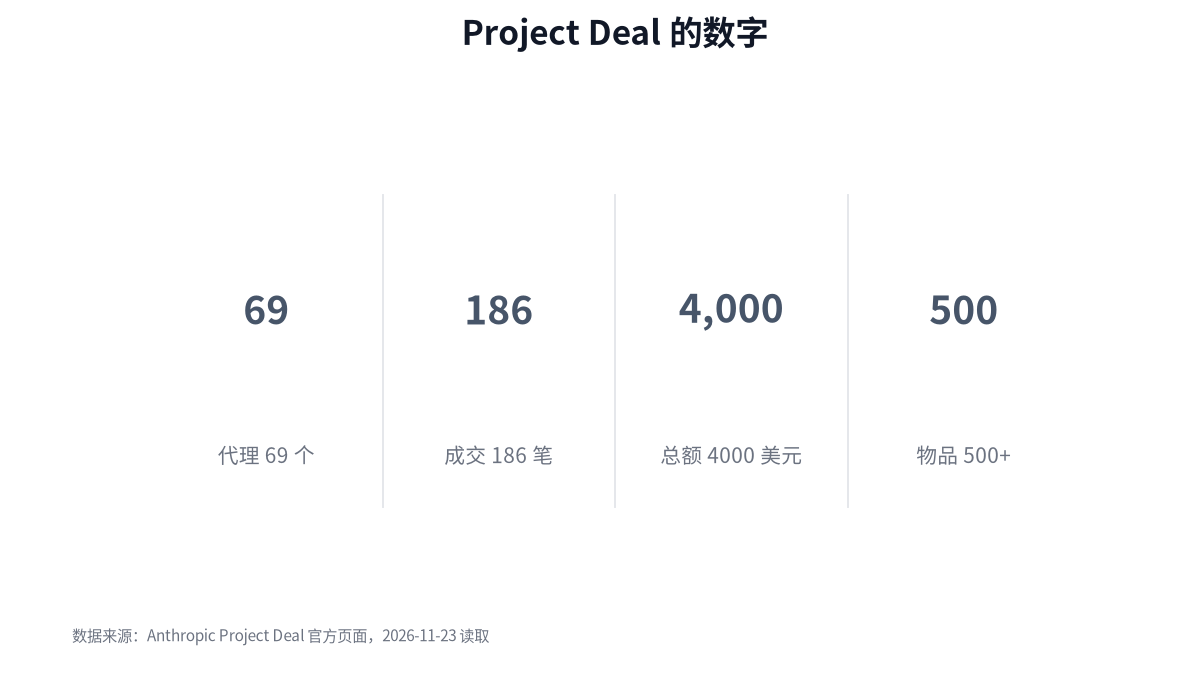
图 1:四组并行里只有 A 组真实成交,另外三组只用于测量模型差异。数据来源:Anthropic Project Deal 官方页面,2026-11-23 读取
结论二:人自己没感觉
问卷里有一道排序题,让人把四组买到的物品捆绑从好到坏排一遍。
61 人开始作答,全部答到这一题,52 人做完。
拿其中 28 人来看,他们在两轮里分别被 Haiku 和 Opus 代表。17 人把 Opus 那轮排得更高,11 人正好相反。
客观结果有差异,主观感受的方向并不一致。官方原文的措辞是「没察觉到自己吃了亏」。 这个分裂比「代理越强越好」更值得记。它意味着用户没法靠体验来判断自己的代理够不够用。
为什么这事和普通用户有关
现在大多数人对 AI 代理的期待还停在「帮我查资料、写东西」。Project Deal 换了个方向:代理替你做决定,而且是在花钱这类事上。
一旦这个场景成立,代理的质量差异会变成财富差异。
强的代理多卖几块钱、少付几块钱,单次看不出来,长期是累积的。
而主观感受补偿不了这个差距。你觉得体验差不多,账上已经差了一截。 我自己对这个趋势的判断是:代理市场的门槛不在技术,在信任和责任。出了问题谁负责,这个没答案之前,规模起不来。
官方自己标的局限
原文写得很清楚:这是试点,参与者是自我选择的,69 人全来自同一间办公室,商品金额都不大。 还有个容易被忽略的细节:四个组里只有一个真实成交,所以「客观结果更好」的估计建立在对照设计上,不是真实交易记录。
金额小也是个边界。4000 美元总额摊到 186 笔,单笔二三十美元。这个量级下,人对价格的敏感度本来就低,换成买房买车,结论未必成立。
我的两点保留
第一,样本。69 人、一家公司、一周,还都是科技公司员工,外部效度存疑。他们的议价习惯、对 AI 的接受度,和普通人不一样。
第二,模型的代际。实验用的是 Opus 4.5 对 Haiku 4.5,两代之间差了一整档。Anthropic 上市那两天我记过它的产品节奏,这次的差距可能主要来自规模差异,而不是代理能力本身的设计。
能确认的是方向:代理质量影响交易结果,且用户察觉不到。单个指标证明不了全面优势这句话反过来也成立,这里一个实验也证明不了普遍规律,但足够提示。
如果要自己试
这个实验的可复制性其实不差。
小团队内部做个物品交换,让代理代拍,记录成交价,跑两周就能看出模型差异的方向。
关键在对照:同一批人、同一批物品,随机分配代理强弱,人不知道分组。没这个设计,测出来的是「谁更会卖」,不是「代理有多强」。
成本不高,一周时间加几十件闲置物品。想验证代理值不值钱的人,这个比跑分表有说服力。
FAQ
Q:186 笔成交、4000 美元,说明什么?
说明代理能完成议价这类多轮交易。金额小,只能证明可行性,不能证明规模化。
Q:为什么说人察觉不到差距?
28 人里 17 人把 Opus 那轮排得更高、11 人相反,主观排序和客观结果不一致,官方措辞是没察觉吃亏。
Q:这个实验能复制吗?
能。小团队内部做交换市场,随机分配代理强弱、人不知情,跑两周就能看出方向。
参考资料
- Anthropic · Project Deal(实验设计、成交数据、问卷排序与回归估计的出处)
- Anthropic Newsroom(同期公告入口)
口径与核验:69 个代理、186 笔成交、4000 美元、500 多件物品、四组并行、2.07 笔与 p = 0.001、61 人作答、52 人完成、28 人里 17 比 11 的排序、Opus 4.5 与 Haiku 4.5 的对照设置,全部取自 Anthropic 官方 Project Deal 页面,读取于 2026-11-23。
非官方内容只有我自己加的两点保留和一个复制方案,已标明是我的判断。原文没有给参与者议价习惯的画像,我没有替它补。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。