
一句话总结:Architect Labs 放出一颗叫 Frostbite 的通用 CPU,指令集、微架构、RTL、验证、GDS 全由 AI 系统自己迭代出来。官方给的 8.77 倍是「每单位面积性能」,对比基准是自家的 TCPU,且全部是流片之前的估算。
11 月 20 日,Architect Labs 发布 Frostbite。按他们的说法,这是一颗从零设计的通用处理器,新指令集,整条链路没有人类架构师画框图。
这个说法很重。过去两年「AI 设计芯片」大多停在布局布线、宏单元选择这一层,指令集和微架构始终是人定的。 Frostbite 把这条边界往前挪了一格:ISA、编译器、RTL、验证、GDS,都由同一套 AI 系统串起来迭代。
它凭什么能自动设计
关键在底层的计算模型。Frostbite 不是冯诺依曼结构,走的是交互网(interaction nets):程序被表示成节点组成的图,计算靠改写相连的节点对完成,每一步都只发生在局部。
这个性质对硬件很友好。主流语言编译到普通 CPU 上,程序各部分的依赖关系被藏起来了,谁都能读写谁;交互网把依赖显式画在图上,并行不需要人去找。
有意思的是交互网不是新东西,官方自己说它已经存在 35 年以上,只是一直没证明能落到生产。 这套形式化也决定了 AI 能插手:因为每一步都是局部改写,规格可以被形式化描述,AI 生成的 RTL 能被机器证明。
官方用了 ASL 写规格,用 Lean 给它那 31 个模块写契约。
迭代方式:一群代理同时改
官方描述的流程是多代理并行探索,并非「AI 一次性生成」:先定工作负载集,再让代理综合论文和现有基准、写 Python 模型去比较高层架构想法,选出候选之后做软件模型,再往下到 RTL。
中间有个细节值得记:Arcmodel 与 RTL 被反复对齐。官方说全芯片的 Arcmodel 仿真比 RTL 快 660 倍,所以对齐之后,后续迭代才能在可接受的时间内跑完。
这套做法的成本结构,和传统流片完全相反。传统是人力贵、迭代慢;这里是算力贵、迭代快。
先看清分母:每单位面积
官方先测单核,拿一个 Frostbite 四核组和 TCPU 比,理由是两者面积相近。跨全部工作负载平均 8.77 倍。这个分母是面积,不是核心数,也不是频率。
能效那组更保守
第二,能效那组更保守。25 个工作负载合起来,每瓦性能几何平均 4.59 倍:其中 10 个搜索集负载 6.02 倍,15 个留出负载 3.83 倍。
第三,全部是流片前数字。官方明确说了是 pre-silicon power numbers,没有实物。
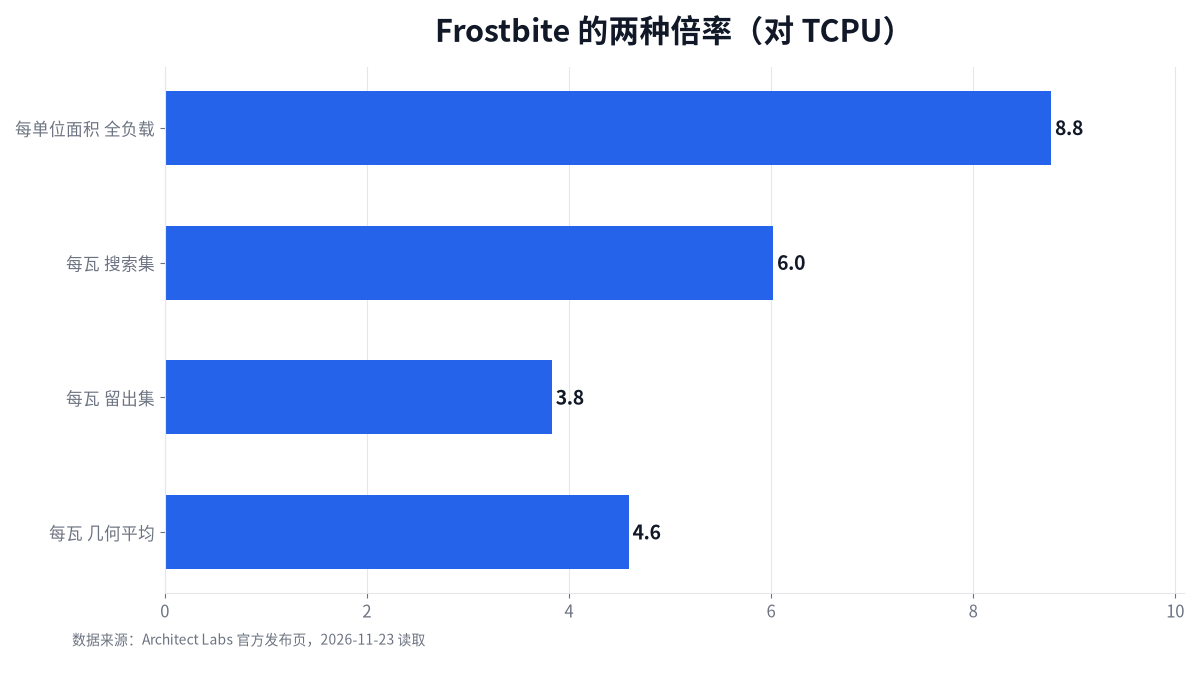
图 1:搜索集与留出集的差距是这张图最该看的地方——调过的 6.02 倍,没调过的 3.83 倍。数据来源:Architect Labs 官方发布页,2026-11-23 读取
搜索集 6.02、留出集 3.83,这个落差说明一件事:代理在那 10 个负载上做了针对性调优。留出集的 3.83 倍更接近「泛化能力」的真实水平,但依然是 pre-silicon。
另外 TCPU 是什么,官方材料里只是当作对比基线出现,没给详细定义。我没法确认它是同代产品还是自家上一代设计,这会影响 8.77 的解读。
省的电从哪来
官方拆了一张能耗图。扣掉时钟分布这一项(TCPU 占 49%,Frostbite 四核占 41%),TCPU 有 57% 的电花在内存,27% 花在取指译码发射;Frostbite 把内存压到 38%,取指译码发射压到 6%。
代价是片上网络和调度器:这一项在 Frostbite 上占 26%。 这个交换很好理解。交互网把并行暴露出来,就得花力气搬运和调度;省下的是访存和指令流。这笔账来自结构,不来自制程红利。
这件事的分量在哪
我的判断:这次真正的信号不是数字,而是流程。人写 PDF 交接给实现团队、验证团队,这套硅谷用了四十年;Frostbite 把中间那层文档换成了形式化规格,让 AI 直接读写。
这一步能成立,依赖的是 ASL 加 Lean 这套可证明的规格语言。没有它,AI 生成的 RTL 没人敢信。
但也要看到前提:交互网这种结构天生适合形式化,换到主流 x86 或 ARM 生态,同样的方法未必迁移得动。显存怎么算那篇里我提过一句,算力账要按上限算,这里也一样:8.77 倍是上限附近的数,不是普遍水平。
我没法确认的部分
没有硅,就没有实测功耗和频率,8.77 倍和 4.59 倍都基于模型仿真。官方在文里也反复用「estimated」这类词。
面积对比的公平性我算不了。他们说「面积相近」,但没给两边的具体面积数字,所以每单位面积这个分母是否对齐,我验证不了。
还有一点:25 个工作负载是自选的,其中包括卡尔曼滤波、PCA、有限元、LU 求解、LZ4 解压。这些偏数值和数据处理,恰好适合交互网的局部改写特性。英伟达那波下跌之后,硬件叙事都容易被放大,这个背景也值得放在心里。
结论我这样下:这是一份可信的流程演示,不是一个可对照的产品参数。前者已经很难,后者还早。
FAQ
Q:Frostbite 是能买到的芯片吗?
不是。它是流片前的设计,所有性能与能效数据都来自模型仿真,没有实物。
Q:8.77 倍是综合性能,还是某一项?
是每单位面积性能,跨全部工作负载的平均值。每瓦那组单独算,几何平均 4.59 倍。
Q:交互网是什么?
一种把程序表示成节点图、靠局部改写推进计算的模型,存在超过 35 年。Frostbite 用它换来了天然的并行性。
参考资料
- Architect Labs · Introducing Frostbite(ISA、流程、基准与能耗数据出处)
- Hacker News 讨论(该条在 11 月 20 日进入首页,674 分,社区质疑集中在基准定义)
口径与核验:8.77 倍每单位面积、4.59 倍每瓦几何平均、6.02 倍与 3.83 倍的搜索集与留出集拆分、660 倍仿真提速、31 个模块、25 个工作负载、能耗分布 49%/41%/57%/38%/27%/6%/26%、35 年这些数字,逐条对照官方发布页,读取于 2026-11-23。
pre-silicon 的表述来自官方原文。TCPU 的定义、两边面积的具体数值、以及基准是否为同代产品,官方未给,我列为存疑,没有补全。HN 分数为我抓取当日页面的显示值。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。