
一句话总结:Kimi K2.7 Code 是 1T 总参数、32B 激活的 MoE 编码模型,官方直接发了原生 INT4 权重,聚合显存 640GB。8 张 H200 能跑,4 张 MI300X 也能跑。消费级只有一条路:Unsloth 的 1.8bit GGUF 加内存卸载,单张 24GB 卡能启动,速度掉到个位数 tok/s。按公开租金折算,自己跑每百万 token 的机器成本是 API 的几十倍。
有个读者问我,他有台 4090,能不能自己跑 Kimi 的编码模型,省点 API 费。
我说你先看它的权重有多大。
他查完回了一句:640G。
然后就没再问了。
这个反应是对的。「开源权重」和「能自己跑」之间隔着的不是技术,是显存。
一、Kimi K2.7 Code 是什么:1T 参数、32B 激活
先把规格摆清楚。这模型是 Moonshot 2026 年 6 月 12 日发的,属于 Kimi K2.6 的编码向迭代。
| 项目 | 规格 |
|---|---|
| 总参数 | 1 万亿(1T) |
| 激活参数 | 320 亿(32B)/ 每 token |
| 专家数 | 384 |
| 注意力 | MLA(Multi-head Latent Attention) |
| 上下文 | 256K |
| 权重格式 | 原生 INT4(官方自己量化的) |
| 许可 | Modified MIT |
| 相对上一代 | 同等质量下思考 token 少约 30% |
两个细节值得单独说。
「原生 INT4」这件事很关键。 大部分厂商发 BF16 权重,让用户自己量化——量化过程会掉精度,而且各家工具链的实现不一样。Moonshot 自己把 INT4 版本做出来,等于把这一步的责任揽了,也让 vLLM、SGLang、KTransformers 有统一的优化目标。
「32B 激活」是它敢叫 1T 的原因。 MoE 架构下,每个 token 只走部分专家,所以计算量按 32B 算,显存按 1T 算。这就是 MoE 的核心矛盾:省算力,不省显存。
二、640GB 显存是怎么算出来的
640GB 这个数有点意思,它不是简单的 4bit × 1T。
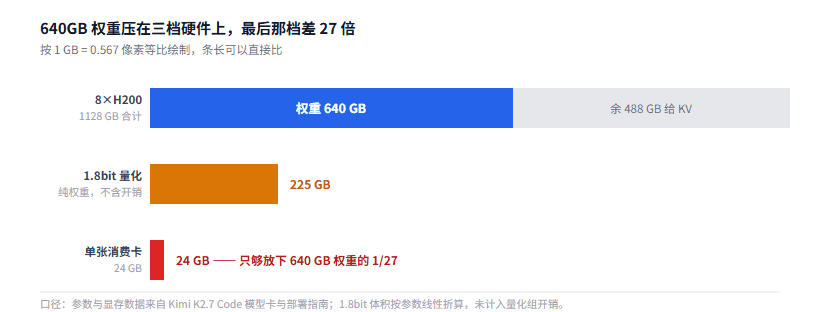
图 1:等比例绘制。第三行那个红色小方块,就是一张消费卡的全部显存
算一下:
1T 参数,纯 4bit 理论体积 = 1000e9 × 4 / 8 / 1e9 = 500 GB
官方给的聚合显存 = 640 GB
多出来 140 GB,占 28%
折算成每参数 = 640 × 8 / 1000 = 5.12 bit
为什么是 5.12 bit 而不是 4 bit? 因为不是所有参数都能压到 4 位:
- 嵌入层(词表映射)通常保持 8bit 或 16bit,压太狠会掉语义
- 量化需要缩放因子(scale)和零点(zero point),这些是额外开销
- 输出层同理
这 28% 就是这些「压不下去的部分」。任何声称「4bit 模型只有 X GB」的说法,都要问一句含不含这些开销。
再算 8 张 H200 装不装得下:
8 × 141 GB(HBM3e)= 1128 GB
权重 640 GB 占 56.7%
剩 488 GB 给 KV cache 和激活
每张卡平均分 80 GB 权重
56.7% 这个比例其实挺宽松。真正的瓶颈不在权重,在 KV cache——256K 上下文开满的时候,KV 能吃掉剩下的一大半。
三、官方验证过的显存配置清单
这份清单值得存下来,因为它告诉你「什么卡能跑」:
| 平台 | 配置 | 说明 |
|---|---|---|
| NVIDIA H200 | 8 张,TP=8 | INT4 主力方案 |
| NVIDIA B300 | 8 张,TP=8 | 更新一代 |
| NVIDIA GB300 | 4 张,TP=4 | 单卡显存更大 |
| AMD MI300X / MI325X | 4 张,TP=4 | 官方验证过的 AMD 路线 |
| AMD MI350X / MI355X | 4 张,TP=4 | 同上 |
注意 AMD 那两行。 4 张 MI300X 就能跑,这比 8 张 H200 的门槛低——不是硬件更强,是单卡显存大(MI300X 192GB)。
另外官方提了一个细节:如果跑 FP8 而不是 INT4,8 张 H200 SXM5 的 1128GB 里权重会吃掉约 1TB,只剩 128GB 给 KV cache。这个余量在 256K 上下文、小 batch 下刚好够,但要提并发就不行了。
这就是为什么原生 INT4 重要。 FP8 下权重占 90.8%,几乎没给 KV 留空间;INT4 下占 56.7%,才谈得上多用户。
四、消费卡唯一的路:1.8bit 量化加内存卸载
回到开头那个读者的问题。24GB 的 4090 能不能跑?
不能按正常方式跑。算一下就清楚:
640 GB 权重 / 24 GB 显存 = 差 27 倍
即使压到 1.8bit:1000e9 × 1.8 / 8 / 1e9 = 225 GB,还是差 9.4 倍
降到 1.8bit 也不够。 这不是精度问题,是物理装不下。
唯一的办法是官方指南里那条:Unsloth 的 1.8bit GGUF,把专家层全部卸载到系统内存,显存只留当前激活的那部分。
代价:
- 需要 24GB 显存 加 256GB 以上系统内存
- 速度掉到个位数 tok/s
- 每次换专家都要从内存搬权重到显存,PCIe 带宽成瓶颈
个位数 tok/s 是什么概念?你打一行代码,等它补全的时间够你手写完。
所以这条路只适合两种人:验证模型行为、或者做隐私测试。 想靠它省 API 费,纯属自我安慰。
量化档位怎么影响显存,27B 那篇算过更细的表:Q4 到 Q8 每档的实际占用和适用显存区间。那篇的结论在这里同样成立——降精度能省空间,但省不出一个数量级。
五、许可:Modified MIT 那条附加条款
许可这块比想象中宽松。
主体是 MIT——可商用、可修改、可部署、不收费。只加了一条:
如果你的产品月活超过 1 亿,或者月收入超过 2000 万美元,必须在界面上显著显示「Kimi K2」。
这个门槛基本等于没有门槛。 独立开发者和正常规模的公司都碰不到。对比 Llama 那套社区许可(有月活限制、有命名要求、有再分发限制),这个干净得多。
不过有一点要提醒:这条款约束的是「用这个模型做产品」。如果你把模型权重再分发,MIT 允许,但要保留版权声明。
六、自托管这笔账值不值得算
这是我最想说清楚的一点。
按公开报价的常见区间(每卡每小时 2 到 4 美元),租一台 8×H200:
$2/卡/时 × 8 = $16/时
$4/卡/时 × 8 = $32/时
按单用户 30 tok/s 估:
1 小时产出 = 30 × 3600 = 108,000 token
$16/时  → 每百万 token $148
$32/时  → 每百万 token $296
对比 API:Kimi 系列的价格在每百万 token 几元到几十元人民币的量级。
按单用户算,自己跑贵 50 到 100 倍。
这个对比要打个折:8 卡机器可以并发处理多个请求,批处理吞吐远高于 30 tok/s。如果跑到 500 tok/s,成本降到每百万 $30 到 $60,差距缩到 5 到 10 倍。
但即使缩到 5 倍,自托管还是不划算——除非你有 API 给不了的东西:
- 数据不能出内网(金融、医疗、政企)
- 要保证 SLA,不能受对方限流影响
- 要做深度定制(改 tokenizer、改推理逻辑)
- 长期大规模使用,且自己有机房
这四条里没有一条是「省钱」。省钱这个理由在 1T 级模型上根本不成立。
gpt-oss 那篇算过小模型的账:20b 版本 16GB 内存就能跑,那个规模自托管才可能省钱。到了 1T 这个量级,规模效应完全站在云端那边。
七、常见问题
1T 参数是真的吗?
真的。但要注意「总参数」和「激活参数」是两回事。每个 token 只激活 32B,所以计算量相当于一个 32B 模型,显存占用相当于 1T。买硬件的时候按 1T 算,估延迟的时候按 32B 算。
INT4 会掉多少质量?
官方发的是原生 INT4,不是用户自己转的,理论上掉得少。但具体掉多少,官方指南里没给对照数据。这个我没法判断,存疑。
能在 macOS 上跑吗?
24GB 统一内存的 Mac 也不够(需要 225GB 起)。M3 Ultra 那种 512GB 统一内存的机器理论上能装,但没有官方验证的配置,速度也不保证。
和 K2.6 比该选哪个?
K2.7 Code 主打编码,官方说同等质量下思考 token 少 30%。如果你的用途是写代码,选 K2.7;如果是通用对话,K2.6 可能够用且更便宜。
租机器试一次要多少钱?
按 $2/卡/时算,8 卡一小时 $16。跑一轮基准测试大概要几个小时,一百美元以内能试完。这比自己算「要不要买卡」快得多——先租一次,跑完你就知道自己需不需要了。
这个模型适合什么样的团队?
有明确数据合规要求、且有 GPU 运维能力的团队。个人开发者和小团队,用 API 更现实。
八、结语
640GB 这个数字,比任何跑分都更能说明一件事:开源权重不等于人人可跑。
它是给「有 8 张卡的人」开源的,不是给「有 1 张卡的人」。这个区分在中文语境里经常被模糊掉——一看到「开源」「可商用」,就以为能装在自己电脑上。
我这次的判断很简单:先用 API,等到 API 满足不了需求了,再考虑自托管。 顺序反过来的人,多半会在租机器上花掉比 API 费更多的钱,然后得到一个更慢的系统。
参考资料
- DEV Community - Kimi K2.7 Code Local Setup 2026: vLLM, SGLang, GGUF - 本文参数、显存、硬件配置与消费级方案的主要来源
- Kimi K2.7 Code 模型卡(Hugging Face) - 权重、许可与官方配置的原始出处
- Unsloth 文档 - 1.8bit GGUF 量化方案的说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。