
一句话总结:它不是一个 flag 清单,是一套让 agent 自己去爬山的方法:先算出硬件的理论上限,再每次只改一个变量,跟前后两次对照比,赢两个才算赢。作者用它把一台笔记本 iGPU 的单用户解码从 43.6 提到 53 tok/s,把 256K 预填充从 297 提到 628。
项目叫 inference-optimisation-skill,11 月 16 日创建,MIT,仓库 32KB。核到 1368 星、123 fork、7 个待处理 issue。
名字里带 skill,说明它的形态:给 Claude Code 这类 agent 加载的一份工作流,不是一个可执行程序。SKILL.md 写流程,references/ 按需加载,scripts/ 是一个只用标准库的 benchmark 小工具。
README 开头有一句话说得很直:It is not a list of flags。整份文档的力气都在证明这句话。
六步流程:第一步就不是动手改
流程写得很清楚:算理论上限、一次只改一个变量、拿交错对照来测、把失败结果也记下来、用长上下文检索做门禁、最后固定一个干净版本再谈发布。 第一步是这套方法跟「抄别人配置」最大的区别。它先让你算:每 token 要读多少字节、除以带宽得到解码上限、每 token 要做多少浮点运算、除以一半峰值算预填充上限、KV 能装多少。
顺序反过来做会怎样?你会一直在两个不知道终点的数字之间来回试。先算出上限,才知道某个目标是不是已经超出物理。 README 举了例子:某次计算得出单用户 100 tok/s 只有靠两个有效的投机草稿才够得着,而这个模型的草稿头在深度 2 时接受率约 14%,所以实际目标该定在 88 到 97。最后跑到 55% 附近,剩下的是 GEMV kernel 效率。
这段是全文最值钱的部分。没有之一。它把「没达到目标」拆成了「物理不允许」和「工程没做完」,而不是笼统地说「还能再优化」。
结果表:我挑了三条自己算了一遍
README 给了一张跨硬件的实测表。我挑三行验证口径: 第一行是 Intel Arc B390 笔记本 iGPU,64GB 统一内存,带宽约 115GB/s。模型是 35B-A3B 的 EXL3 4bpw,引擎 SGLang 加 MTP。单用户解码 43.6 到 53 tok/s,四人并发 84.7 到 103,32K 预填充 1,037 到 1,660,256K 预填充 297 到 628,启动 113 秒到 43 秒。
我按它自己给的接受率算了一下:投机解码的理想加速是 1 加 0.14 乘 2,也就是 1.28 倍。实测 53 除以 43.6 是 1.216 倍,四人并发那组 103 除以 84.7 也是 1.216 倍。
两组独立测量的比率一致,说明这个 1.216 是稳定的净收益;理想值 1.28 里少掉的 0.06,就是草稿模型本身的开销。 第二行是 4 张 H200 NVL,跑 DeepSeek-V4.1-Flash,用 vLLM 加投机解码。改进前是「高负载下崩溃」,改进后 229.1 tok/s 解码、17,546 tok/s 预填充,六项门禁全过。这一行最有说服力的不是数字,是从崩溃到能跑。
一张 3090 上的两个数字
第三行。RTX 3090,跑的 Qwen3.6-35B-A3B,EXL3 3bpw 加 MTP,单用户 251.7 tok/s 散文、357.9 tok/s 代码。
代码比散文快 42%,这个差不是玄学。代码的 token 可预测性高,草稿模型更容易猜中,接受率上去,加速比自然涨。
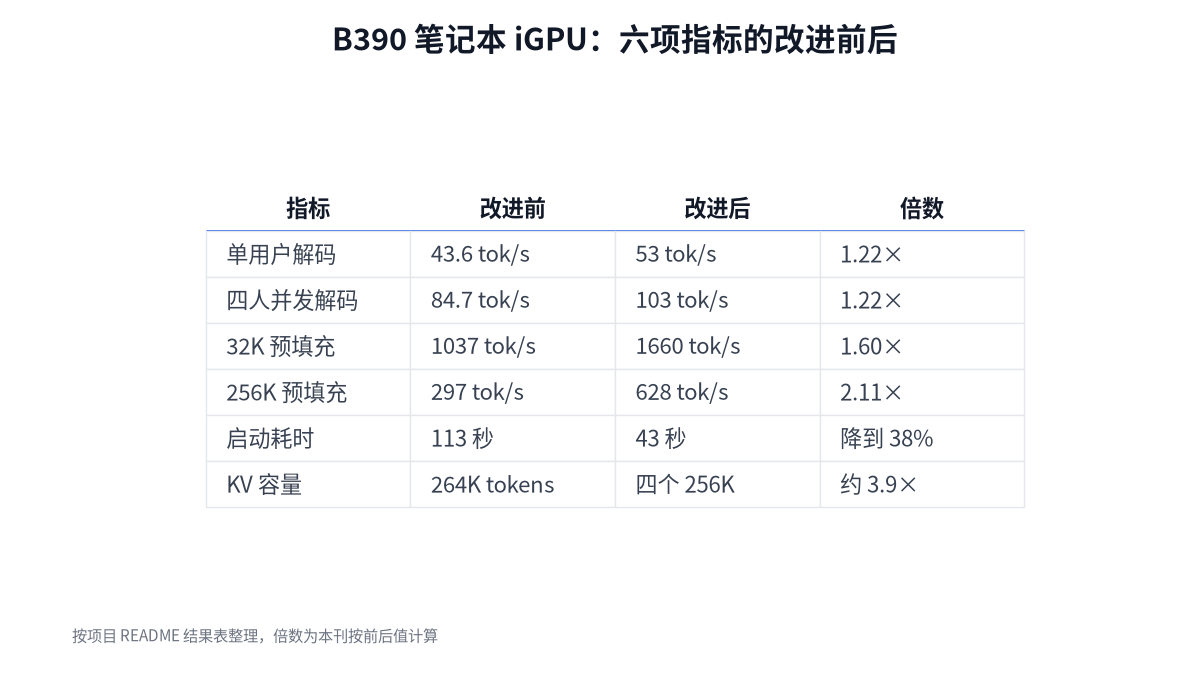
图 1:解码稳定在 1.22 倍,256K 预填充提升到 2.11 倍,启动时间降到原来的 38%
上限怎么算:一行除法
逻辑其实很朴素:解码时每生成一个 token,要把激活的那部分权重从显存读一遍。读的字节数除以带宽,就是理论上限。 拿 B390 那台算:带宽 115GB/s,4bpw 意味着每个权重占 0.5 字节。如果激活参数按 3B 算,每 token 要读 1.5GB,上限就是 115 除以 1.5,约 76 tok/s。
但 README 写的上限是 100 tok/s。差在哪?我这个估算把激活量拍大了。MoE 每个 token 只走一部分专家,有效激活低于 3B,按 1.5B 算就是 0.75GB,上限 153 tok/s,再叠加草稿开销,100 这个数就对得上。
这里的要点在我算错这件事本身。它逼你把假设写下来。算错了,你会看见「实测超过上限」这种不可能的事,然后回头改假设。 预填充那侧同理:每 token 的浮点运算量除以峰值算力的一半。它提到 256K 预填充实测 628,算出来的上限是 670 到 684,已经吃到 93% 左右。到这一步,剩下的空间不值得再投入。
测法:交错对照,两侧都要赢
README 的 loop 图里有一段很硬的要求:对照组和候选配置交错跑,序列化执行,只跑 AC 供电,带内存看门狗,每组至少 6 个样本取中位数。
光猫凭据那篇里我用「同一天另一个项目的 fork 比」做对照,思路一样:没有对照,单个数说明不了什么。
交错跑是为了对抗漂移。GPU 跑久了会降频,先测的组和 20 分钟后测的组不在同一个状态下,单侧比较就会把降频算成「优化」。两边交错,漂移对两边的影响一样,差值才是真的。
「赢两个才算赢」是验收条件:候选配置必须同时赢前后两次对照,并且没有任何指标回退超过 3%。 这条规则挡住了最常见的一类假优化:解码快了,但预填充慢了 5%;或者单用户快了,四人并发退步。只看一个指标,你会以为自己在进步。
门禁:跑得快不算数,检索得住才算
长上下文 needle gate 是这套流程里我最认同的一环。KV cache 压缩、量化、分页改动,都可能让模型在短对话里表现正常,但在 200K 上下文里找不到埋在中间的那句话。
速度是容易测的指标,质量不容易。它把质量做成一道门:过不了就不能算优化,只能算「跑得快了但坏了」。 后面还有并发满 KV 的浸泡测试、平台期判断、固定干净构建、六项验收门禁。顺序是固定的。先稳,再快,最后才谈发布。
这套东西本质上和我给 Blender 插件写的那篇里说的「撤销按命名步骤回退」是一类思路:把不可控的操作变成可回退、可复现的步骤。
它教的方法能搬走吗
能。换模型,六步照样成立:先算上限、单变量、交错对照、记录失败、质量门禁、固定版本。 搬不走的只有两样:一是它已经攒下的 levers 库,每个建议背后都有实测;二是它踩过的 gotchas,包括 vLLM、SGLang、llama.cpp、ExLlama 在 Intel、NVIDIA、Apple、AMD 上的已知坑。
这两样东西的价值,从数字上看不出来,从失败记录数量上才看得出来。 最后说个我不确定的地方:表里所有数字都标了硬件,但我没有对应机器,一个都没复现。所以我把它们当「作者自述的测量结果」看,不当作行业基准。
如果你想用它,起点不是抄表里的参数,而是先照它第一步,把自己的硬件上限算出来。算完之后,很多想试的开关会自动失去意义。
FAQ
Q:需要什么基础?
要能跑起一个 OpenAI 兼容的本地推理服务,看得懂 tok/s 和 KV cache 这些概念。脚本只用标准库,不用装依赖。
Q:只能配 Claude Code 吗?
不是。README 说任何能加载 SKILL.md 式技能的 agent 都行,也提供了 PROMPT.md 供纯对话模型照着做。
Q:笔记本能有多大提升?
作者在 B390 那台上拿到约 1.2 倍解码、2.1 倍 256K 预填充。你的硬件不同,数字不会一样。
Q:为什么先算上限?
为了分清「物理够不着」和「工程没做完」。不算上限,你永远不知道什么时候该停。
参考资料
- GitHub · sybil-solutions/inference-optimisation-skill(MIT,含六步流程与跨硬件结果表)
- GitHub API · 仓库元信息(星标、fork、创建时间,查询于 2026-11-21)
- local-ai-registry PR #453(作者给出的原始 hill-climb 日志)
数字边界在这:1,368 星、123 fork、7 issue、创建 2026-11-16、MIT、32KB 来自 GitHub 接口;六步流程、上限算法、交错对照与 3% 回退限制、needle gate 均引自项目 README;1.216 倍是我用 53÷43.6 和 103÷84.7 算的,1.28 倍是用 1+0.14×2 算的。76 tok/s 与 153 tok/s 两个上限是我按 3B 和 1.5B 激活量各自的假设估的,不是作者原值,仅用于说明算法。表内实测数字我没有对应硬件,未复现。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。