
一句话总结:11 月 14 日一天,6 家厂商调了 14 条价格,10 降 4 涨;按一次 agent 任务折算,Qwen3.5-9B 降 38.1%、R1 0528 涨 10.5%,同一批调价的账单差出 48 个百分点。涨价的是缓存,不是输入。
价格变动每天都在发生,媒体通常只写一句「又降价了」。11 月 14 日这批不一样:同一天里,Qwen 把缓存读砍了 37%,DeepSeek 的 V4.1 Flash 1017 把缓存读从 0 抬到 0.01 美元,涨了 233%。一边降一边涨,都发生在 24 小时里。
我把站内那篇 agent 账单拆解的口径搬过来,按 9000 个缓存 token、1000 个新输入、2000 个输出,把每家的调价折算成一次任务的成本。结论跟「降了几条」没什么关系。
14 条调价,4 涨 10 降
先把这一天的变动摆开。读懂AI时代的价格变动流记了 19 条,其中 5 条是输出上限和上下文窗口的调整,真正动价格的是 14 条。
- 涨的 4 条:R1 0528 输入 $0.50→$0.57(+14%)、输出 $2.15→$2.29(+6%);V4.1 Flash 1017 缓存读 $0.00→$0.01(+233%);Particle-1 输入 $0.05→$0.06(+20%)。
- 降的 10 条:Qwen3.5-9B 三项各降 37%–38%;MiMo-V2.5-Pro 缓存读 $0.10→$0,降 96%;GPT-5.6 Sol 四项各降 9%;V4.1 Flash 1017 输入降 75%、输出降 17%。
只看条数,10 比 4,像一轮降价潮。换成账单看,这个印象立刻散掉。
折算成一次任务,差 48 个百分点
口径写清楚:账单 = 缓存 token × 缓存价 + 新输入 token × 输入价 + 输出 token × 输出价,单位是美元每百万 token。9000 / 1000 / 2000 这个比例参考了站内 355 那篇从真实账单拆出来的结构,缓存占 90%,比真实的 93.5% 保守一点。
四家的结果:
| 模型 | 调价前(美分) | 调价后(美分) | 变化 |
|---|---|---|---|
| Qwen3.5-9B | 0.176 | 0.109 | -38.1% |
| MiMo-V2.5-Pro | 0.307 | 0.217 | -29.3% |
| GPT-5.6 Sol | 5.236 | 4.760 | -9.1% |
| R1 0528 | 0.930 | 1.028 | +10.5% |
顺带看一个量级:调价后 GPT-5.6 Sol 一次任务 4.76 美分,Qwen3.5-9B 是 0.109 美分,差 43.7 倍。买贵的模型不是因为单价贵,是因为你愿意为那 43.7 倍的能力付钱。
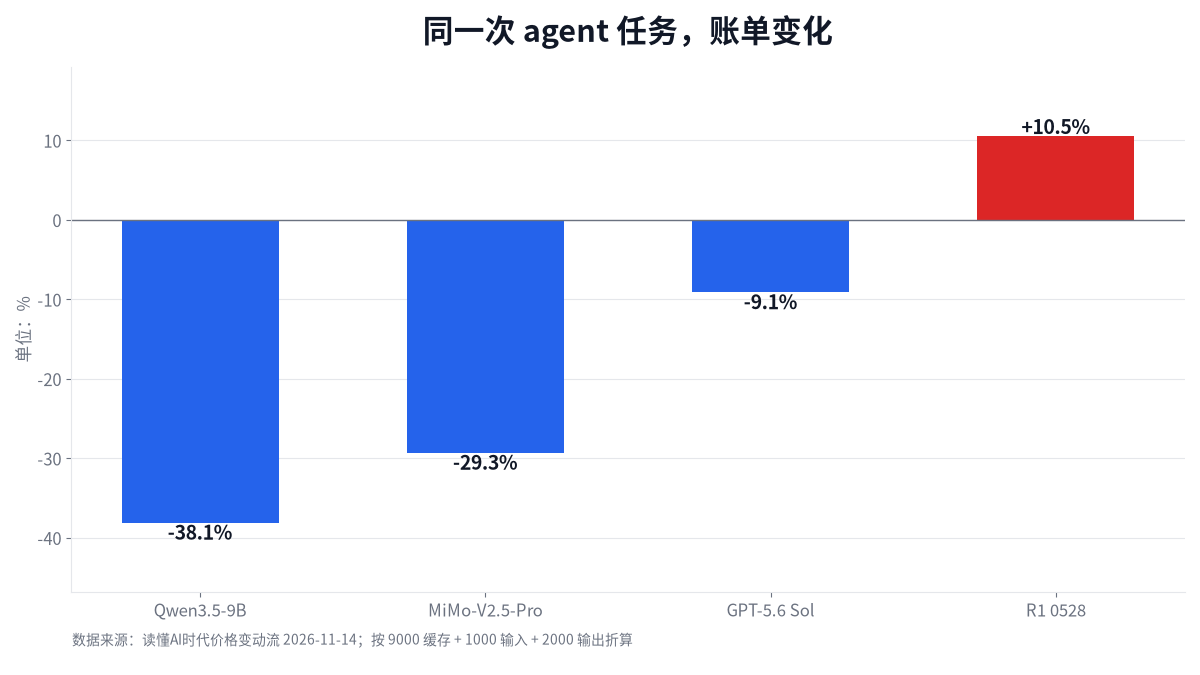
图 1:9000 缓存 + 1000 输入 + 2000 输出,一次任务的账单变化
缓存免费了,账单只降 29%
MiMo 这条最容易被标题写成「缓存免费」。表里记的是降 96%,从 0.10 到 0。可是账单只降了 29.3%。
拆开就明白:调价后一次任务 0.217 美分里,输出占 0.174,是 80%;新输入 0.043,占 20%;缓存那一项是 0。钱主要在输出上,缓存免费只是拿掉了一小块。
Qwen 反过来。它三项一起降,输出价从 0.22 到 0.14,降 37%,缓存和输入也跟着降,所以账单能掉 38.1%。同样是降价,砍在输出上和砍在缓存上,效果差一倍多。
一句话:缓存价便宜,不等于账单便宜。要看这块钱在你的账单里占多少。
这里有个我没算准的地方:我只用了公开牌价,没算并发折扣、批量价和错峰价。真实账单和我这两列差 10% 到 20% 是正常的。
R1 0528 涨 10.5%,一年多花多少
R1 0528 是 5 月的版本,这次输入涨 14%、输出涨 6%,同时把最大输出从 33K 收到 32K。对一个每天跑 1 万次调用的应用,单次成本从 0.0093 涨到 0.01028 美元,一天多 9.8 美元,一个月 294 美元,一年 3577 美元。
这个钱对大部分团队不算大。但对毛利薄的应用是实打实的支出。而同一批调价里,V4.1 Flash 的输入降到了 0.04 美元,是 R1 的十四分之一。
还有一处容易忽略:最大输出从 33K 收到 32K。对长文生成任务是 2.3% 的硬损失,一次写不完就得断成两次,账单反而更高。
我倾向于这么看:老版本涨价,是在把用户往新版本赶。官方没解释,这只是推测。
输入价为什么只是零头
把调价后的三项拆成占比,结论很清楚:
- Qwen3.5-9B:缓存 66%、输入 8%、输出 26%
- GPT-5.6 Sol:缓存 7.6%、输入 8.4%、输出 84%
便宜模型的账单压在缓存上,贵模型的账单压在输出上。输入价两边都只占 8% 上下,没有一次是主角。所以选型时盯着输入价,是最容易被带偏的动作。
输入价是零头。就这么简单。
要问的是自己的负载是哪种:上下文重复多的 agent,缓存价决定账单;长文生成,输出价决定账单。Fable 5.2 那篇碰过同一件事,分数只差 18%,每个任务的成本差 20 倍。
这轮调价在争什么
三条线索。9B 这一层在打价格战,Qwen3.5-9B 三天内调了三次,输入价从 0.17 美元降到 0.09 美元,累计降 47%。旗舰模型按 9% 微调,GPT-5.6 Sol 四项同步降 9%,像在凑一个整数。缓存这块出现了方向相反的动作,有人免费送,有人开始收费。
我判断缓存价会成为接下来半年的主战场。agent 负载里 90% 是重复上下文,谁能在缓存上做文章,谁就能在同样的牌价下给出更低的账单。OpenRouter 那笔日收入账也算过,调用量和收入从来不是一回事,Gemini Hydrogen 的定价也是同样的错位。
还有个不算便宜的东西:模型越多,比价的成本越高。每家四项价格、两个检查点、三种折扣,一张表已经放不下。
最后留个边界:这是一天的数据。它能说明调价的结构,说明不了趋势。要看连续两周的方向,才知道这是不是拐点。
FAQ
Q:这 14 条里哪条对开发者影响最大?
对 agent 类应用是缓存价那条,对普通对话应用是输出价。单看百分比会误判,要看自己的负载结构。
Q:为什么同一天有的涨有的降?
各家定位不同:小模型在抢量,老版本在保价,旗舰在微调。官方都没说明原因,我只能从版本和数字上倒推。
Q:我该不该换模型?
先算自己的三项占比,再比单价。缓存占七成就比缓存价,输出占八成 就比输出价。只看输入价换模型,大概率换错。
Q:这些价格是什么口径?
公开牌价,美元每百万 token,来自读懂AI时代的价格变动流(2026-11-14 更新)。不含折扣、批量和错峰。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。