
一句话总结:蚂蚁百灵的 Ling-3.2-flash 是 560B 总参数、25B 激活的原生多模态模型,1M 上下文,注意力按 7 层线性配 1 层门控 MLA,30K 长上下文下单用户解码均值 280 token/s。
长上下文这件事,现在有三条路。
一条是把 KV 压小(压缩注意力),一条是只让少数层存 KV(混合注意力),一条是给全注意力加稀疏索引。三条路都有代价,区别在代价落在哪。
Ling-3.2-flash 走的是第二条,而且比例给得很极端:7 层线性配 1 层门控 MLA。
Ling-3.2-flash 的 560B 里只有 25B 在干活
560B 总参数,单步激活 25B,稀疏度 22.4 倍。原生多模态,1M 上下文。
25B 激活是个关键数字。它决定了每次推理要读多少权重,也就决定了吞吐上限。按 4.5 bit/参数算(同代 MoE 的常见量级),每 token 要读 25e9 × 4.5 / 8 = 14.06GB。
官方给的吞吐是:DSpark 投机推理下,30K 长上下文、单用户解码,均值 280 token/s。
两个数一乘:14.06GB × 280 = 每秒 3.94 TB。
H200 的单卡带宽是 4.8 TB/s。3.94 ÷ 4.8 = 82%。
这个比例说明一件事:280 token/s 这个数字,是在单卡带宽的 82% 上跑出来的。它已经很接近物理上限,再优化也就 20% 的空间。
如果这个数是 8 卡张量并行的结果,那每张卡只用到 10% 的带宽,说明瓶颈在通信或者调度上,不在带宽。两种解释对应完全不同的工程含义,公开材料没说清是哪种。我倾向单卡,因为 82% 这个数字太"贴线"了,不像巧合。
Ling-3.2-flash 的 7:1 混合注意力意味着什么
8 层一组,7 层用 Kimi 那边的线性注意力(KDA),1 层用门控 MLA。
线性注意力的特点是不存 KV,只存一个固定大小的状态。所以这一组 8 层里,只有 1 层的 KV 会随上下文长度增长。
KV 总量 = 全层 MLA 的 1/8,也就是省掉 87.5%。
代价在能力侧。线性注意力对"精确回忆某个位置的内容"这件事天生弱于全注意力——它把历史压成一个状态,细节会被稀释。穿插全注意力层,就是给模型留几个"能精确回看"的窗口。
7:1 这个比例比 Kimi K3.1 的 69:24(约 2.9:1)激进得多。Kimi 那边留着 24 层全注意力,是因为它还要跑稀疏索引;Ling 这边没有索引器,靠更少的全注意力层做同样的事。
激进的好处是 KV 小、长上下文便宜。风险是长文里的细节召回可能掉,这个我没有实测,标存疑。
280 token/s 是带宽极限的 82%
把账再拆细一点。
单 token 读 14.06GB 权重,这个数字和上下文长度无关,MoE 每 token 只激活固定数量的专家,不管输入多长。所以从 4K 到 30K,权重读取量不变。
变的是 KV 读取。30K 上下文下,按 1/8 的全注意力层算,KV 大概是每 token 几 MB 的量级;1M 上下文下会涨到几百 MB,那时候 KV 会成为主项,吞吐会掉下来。
所以"280 token/s @ 30K"这个数字,不能外推到 1M。官方也没说 1M 下是多少。
这也是所有长上下文宣传的通病:标称窗口和实际吞吐对应的窗口,经常不是同一个。
视觉反馈自检:把渲染结果当输入
这是这一代新增的能力里最实用的一条。
模型做界面、做渲染时,可以把自己的输出结果(截图、DOM、渲染图)作为观测输入读回去,和预期比对,发现不一致就改。官方叫"视觉反馈自检"。
这件事在纯文本模型上做不了——它写完 HTML 就结束了,对不对得靠人去浏览器里看。能读回自己的渲染结果,等于把"看效果"这一步放进了循环。
视觉自检解决的是"不知道结果对不对",和沙箱解决"能不能越界"是两件事。上次照着 Hosted Agents 的设计写代码时撞出一个洞,结论是隔离只靠规则不行,得在 Sandbox 层做检查。自检同理:靠提示词要求模型"看一眼结果"不牢,得把它做成流程里的固定一步。
异常自适应恢复:报错之后自己能重来
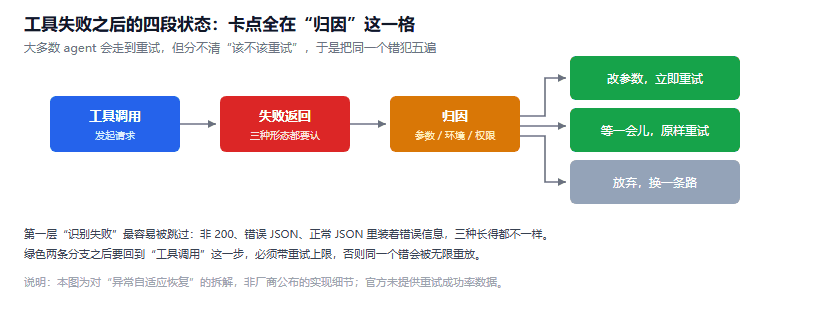
图 1:工具调用失败后的四段状态。关键在第 2 段——能不能区分"参数错"和"环境错",决定重试是修复还是重复犯错
官方描述是:在报错或工具失败后,能定位原因并重试。
这句话听着像废话,但拆开看有三层:
第一层是识别失败。工具返回非 200、返回体是错误 JSON、返回体是正常 JSON 但内容是错误信息——三种情况的处理完全不同。
第二层是归因。参数写错了,改参数重试;环境挂了,等一会儿重试;权限不够,重试一万次也没用,得换路。
第三层是放弃。有些错改不了,硬重试只会烧钱。什么时候认输,是个策略问题。
大部分 agent 卡在第二层。它们会重试,但不会区分"该不该重试",于是把同一个错误犯五遍。
官方没给这三层的具体实现,也没给重试成功率的数字。"异常自适应恢复"这个说法目前只能算能力宣称,不是可验证的指标。
和 Kimi 的 69:24 比:长上下文的两种解法
| 维度 | Ling-3.2-flash | Kimi K3.1 Pro |
|---|---|---|
| 总参数 / 激活 | 560B / 25B | 2780B / 104B |
| 注意力配比 | 7 层 KDA : 1 层 Gated MLA | 69 层 KDA : 24 层 Gated DSA |
| 全注意力层占比 | 12.5% | 25.8% |
| 索引器 | 无 | 有(32 头 × 128 维) |
| 1M KV 量级 | 全层的 1/8 | 比全层还多 17.6% |
最后一行是重点。
Kimi 用 24 层全注意力 + 索引器,结果 1M 上下文的 KV 反而比"93 层全用 MLA"多 17.6%——因为索引器的 key 缓存吃掉了 78%。这笔账我上周算过。
Ling 没有索引器,7:1 直接就省掉 87.5%,没有回吐。
两条路的取舍很清楚:稀疏索引换来"在 1M 里精确挑出 top-k 个 token"的能力,代价是 KV 膨胀;纯混合注意力换来便宜的长上下文,代价是精确回忆靠那 1/8 的层。
哪个好,取决于你的任务是"在长文里找到某一段"还是"读完长文写个摘要"。前者要索引,后者不需要。
关于 Ling-3.2-flash 的五个问题
能下载吗? 公开材料没提权重。目前是产品形态发布,按"不可自托管"预期。
1M 上下文真能用吗? 结构上支持,但吞吐会掉。官方给的 280 token/s 是 30K 下的数字,1M 下没有公开数据。
7:1 会不会掉能力? 会,掉多少取决于任务。检索类任务掉得最多,生成类任务几乎不受影响。这是结构决定的,不是调参能解决的。
DSpark 投机推理是什么? 官方的投机解码方案,用一个小的草稿模型猜后续 token。280 token/s 这个数字包含了投机加速,纯自回归会低不少。
原生多模态是指什么? 图文输入。有没有视频、音频输入,公开材料没说清。
结语
这篇最值得记的不是 280 token/s,是那个 82%。
它说明在当前架构下,MoE 的解码速度已经贴着内存带宽跑了。想再快,只有三条路:把激活参数压下去、把量化位宽压下去、把权重放到更快的存储上。
而 7:1 这个配比给出的信号是:长上下文的成本战,已经从"压缩 KV"转向"减少存 KV 的层数"。这条路更彻底,因为它不是把 KV 压小,是压根不存。
代价写在结构里——那 1/8 的全注意力层,得扛住所有的精确回忆。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。