
一句话总结:NaiveAI 开源的 Naive-N0.5-Flash 是 309B 总参数、15.5B 激活的 MoE,用 AI 参与设计的 5:1 混合注意力撑起 1M 上下文;自研推理引擎把单轮推测解码从 12.3 毫秒压到 3.4 毫秒,每周在一千万个真实沙盒里练手。
硅谷还在争论递归自我改进(RSI)的时间表,国内的开源社区已经把"用 AI 训 AI"跑通了几个完整案例。
NaiveAI 刚开源的 Naive-N0.5-Flash 就是其中之一。这篇把能核实的数字都列出来,看看这件事到底走到哪一步了。
Naive-N0.5-Flash 是什么
309B 总参数、15.5B 激活的 MoE。和同尺寸产品比,它的特点不在参数,在训练方式:整个研发流程里 AI 是参与者,不是工具。
四个公开成绩:SWE-bench Pro 73.6、Terminal-Bench 2.1 86.7、MLE-bench-30 73.7%、PaperBench 63.2%。后两个专考 AI 做研发的能力,开源模型里排前面。
社区用它干的事也很说明问题:有人在 24GB 内存的 Mac 上,写了一页任务书,把一个 0.6B 模型训成了满嘴宫廷腔的"甄嬛";整个微调流程——洗数据、配环境、调显存、写评测——全交给 AI。
5:1 混合注意力:1M 上下文的 KV 又省一次
架构上它用了 5:1 的混合稀疏注意力,5 层线性配 1 层全注意力,8 层一组里只有 1 层存 KV。
和之前写过的两个比例放在一起(Ling 的 7:1 那篇、Kimi 的 KV 账都写过背景):
| 模型 | 配比 | 全注意力层占比 |
|---|---|---|
| Ling-3.2-flash | 7:1 | 12.5% |
| Naive-N0.5-Flash | 5:1 | 16.7% |
| Kimi K3.1 Pro | 69:24 | 25.8% |
这个方向的竞争已经变成"谁的比例更激进"。Kimi 那边靠索引器撑精确回忆,Ling 和 Naive 走纯混合,KV 是全层的 1/8 和 1/6。
官方给的数是注意力检索耗时降了 44%,1M 上下文塞几百轮实验日志、报错堆栈和完整代码库仍能响应。
有一点值得单独说:这个架构是 AI 参与设计出来的。设计神经网络结构这件事本身,开始有 AI 的工时了。
Naive-N0.5-Flash 的推理引擎:151 轮实验换一个内核
自研推理引擎 NaiveRT 是工程含量最高的部分。
研究员带着 AI 用 6 天、151 轮实验重写了底层 CUDA:把开源 SGLang 里每层 29 次零散的 GPU 调用,融合成 1 个 148 线程块协同的巨型内核。
结果:单轮推测解码从 12.3 毫秒降到 3.4 毫秒,缩短 72.4%,线上单流生成跑到每秒 2,000 词。
三个数的意思拆开看:
29 到 1 是调用次数的变化。每次 GPU 调用都有固定的发射开销,29 次变 1 次,省的是开销不是计算量。这和 FlashAttention 当年做的事情同构。
12.3 到 3.4 毫秒是每次解码的耗时。RL 训练里大量时间卡在 rollout 上,rollout 快三倍,同样的卡时能多采三倍样本。
每秒 2,000 词是单流速度。这个数对训练的意义大于对聊天——聊天用不到,RL 的采样管线用得到。
值得注意的还有"151 轮实验"。改 CUDA 内核不是一次写对的,151 轮意味着 150 次失败。这个失败次数本身就是信息:AI 能承受的试错密度,比人类工程师高得多,因为它不累。
每周 1000 万个沙盒:AI 训 AI 的练手场
训练侧,Naive 每周滚动运行近 1,000 万个真实沙盒,峰值并发 10 万个容器。
这个规模解释了模型"手感"的来源。写代码、抓 Bug、看验证曲线,这些能力不是从教材学的,是在一千万次真实的编译失败、测试失败、环境崩溃里泡出来的。
对比一下:一个工程师一年大概经历几千次"写完跑挂再修",这里每周是一千万次。差的不是智商,是样本量。
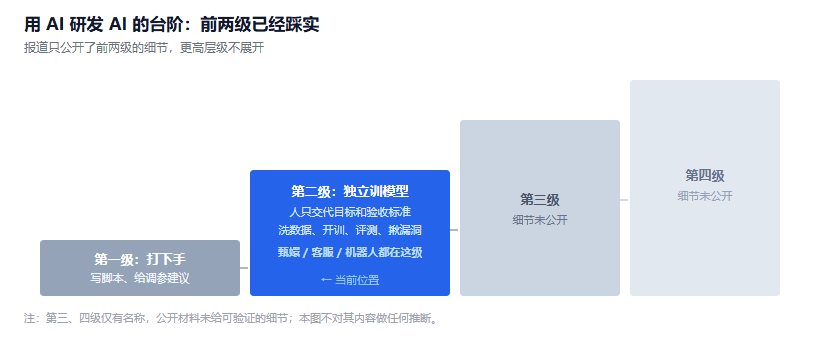
图 1:四级台阶,第三、四级公开材料未给细节,本图不做推断
RSI 四级台阶走到哪了
报道把"用 AI 研发 AI"拆成了台阶,目前公开的两级是:
第一级,单点打下手:帮人写脚本、给调参建议。大部分编程助手在这里。
第二级,AI 独立训出新模型:人只交代目标和验收标准,从洗数据、开训、做评测到揪出考卷漏洞,AI 自己跑完一圈。上面的甄嬛、客服模型、机器人都在这一级。
更高几级报道只提了名字没给细节,我就不复述了。
能确认的是:第二级已经不是概念验证,是可复现的开源工作流。这是和一年前最大的区别。
关于 Naive-N0.5-Flash 的五个问题
权重在哪下? 官方说已开源,具体托管位置以 NaiveAI 的发布页为准。
"AI 参与设计"的水分有多大? 从甄嬛案例看,AI 承担了从出评测题到修 bug 的全流程,这个可信。但"参与设计架构"里人和 AI 的分工没公布,别脑补成全自动。
每秒 2,000 词是聊天速度吗? 不是,是 rollout 速度。聊天场景用不到这个数。
中小团队能复现吗? 微调部分能——0.6B 模型一张 24G 卡就够。但那一千万个沙盒的训练场,个人玩不起。
和 RSI 有什么关系? 它证明了第二级台阶存在。至于更高层级会不会自然出现,没有证据。
结语
这篇最值得记的不是 86.7 分,是那 151 轮实验。
人类工程师做 CUDA 优化,通常改几轮就累了,剩下的靠经验判断。AI 的优势不是判断更准,是它愿意试 151 次,而且每一轮的验证都严格。
换句话说,"用 AI 训 AI"目前跑通的部分,靠的不是模型变聪明了,是试错成本降到了可承受。这个结论不性感,但可操作——你的流程里哪里试错最贵,哪里就最适合先交给它。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。