
一句话总结:DeepSeek V4.1 Flash 以周调用量 70.67T tokens 连续 27 周压着美国模型,按牌价估一笔账,它一天在 OpenRouter 上进账约 760 万美元;但调用量只有它十分之一的 Opus 5.5 batch,收入是它的 3.2 倍。
看到"中国模型连续 27 周登顶 OpenRouter"这类新闻时,我好奇的从来不是排名本身,而是这个第一名值多少钱。榜单给的是 token 数,没人告诉你换算成钱是多少。这篇就把前十名挨个换算一遍,看看量的第一名和钱的第一名是不是同一个模型。
先说结论:不是。而且两个榜单的差距大到离谱,每百万 token 的实际均价能差三万倍。
调用量第一,收入只排第三
2026 年 11 月 12 日的周榜快照,DeepSeek V4.1 Flash 1017 以 70.67T tokens 排第一,腾讯 Hy4 18.81T 第二,智谱 GLM 5.3 Flash 11.28T 第三,前十里有六个是中国模型。GPT-6 Luna 排第四,7.10T。
把调用量乘上各家牌价(假设输入输出 4:1),收入图完全变了样。Opus 5.5 batch 每周调用量 6.76T,只有 Flash 的十分之一,但它输入 2 美元、输出 10 美元每百万,一周估算收入 1.70 亿美元。Flash 输入 0.01 美元、输出 0.5 美元,一周估算 5340 万美元。
调用量第一的模型,收入排第三。换算过来 Flash 一天进账约 760 万美元,年化 28 亿美元左右。这个数字看着不小,可 Opus batch 年化 88 亿美元,同样是"在聚合平台上跑 batch 接口"这一件事。
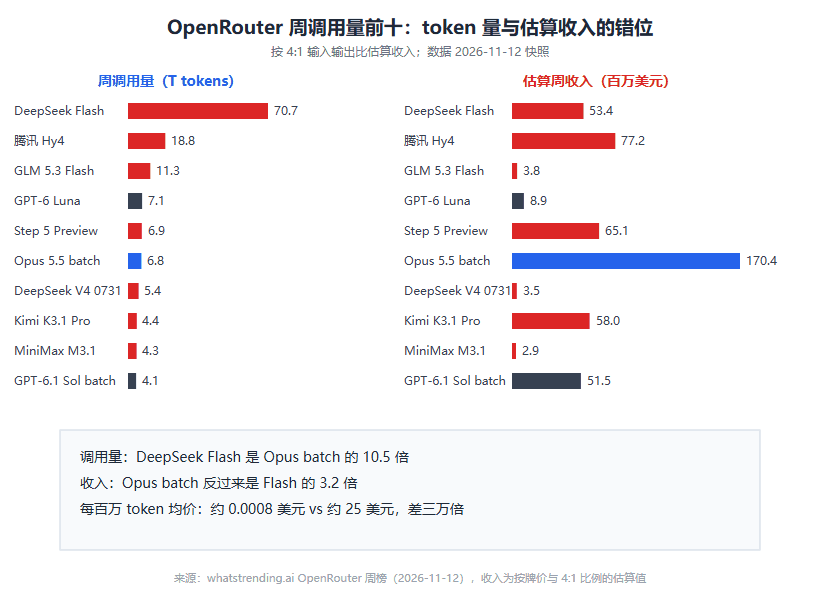
图 1:左列是周调用量,右列是按牌价估算的周收入,两个排序几乎完全重排
七成调用量是什么任务
Flash 的牌价结构能说明它的用途。输入 0.01 美元每百万 token,是 Opus batch 的两百分之一。这个价位上,只有一类任务会大量消耗它:批量抓取、网页清洗、分类打标这类成本敏感的流水线活。
科创板日报引述行业说法,国内模型承接的大多是 agent 网页抓取、批量信息处理这类大规模并行任务,这类任务本身愿意支付的单价就低。GLM 5.3 Flash 输入 0.04 美元,MiniMax M3.1 Flash 0.06 美元,价格带都挤在同一个区间,说明大家在抢同一批客户。
这解释了榜单的形状:前十里中国模型占六席,靠的是把基础设施的价格打穿。而 Opus 的 batch 接口一周 6.76T,单价高两个数量级,服务的是另一批完全不同的活。同一个平台上两条曲线各自增长,互不挤占。
token 均价差三万倍:榜单的两面
把收入除以调用量,得到每个模型每百万 token 的实际均价。Flash 约 0.0008 美元,Opus batch 约 25 美元。同一周、同一个平台、同样的 token 计费方式,均价差三万多倍。
这个倍数比牌价差(2/0.01 = 200 倍输入,10/0.5 = 20 倍输出)大得多。原因有两个:一是 Flash 的调用里输出占比可能更低,抓取类任务返回的 token 很少;二是长上下文输入占比极高,把均价进一步往输入端拖。这两个因素叠加,实际价差远超牌面。
所以"登顶"这个词要看挂在哪个榜上。调用量榜衡量的是平台基础设施的吞吐,收入榜衡量的才是商业价值。新闻标题喜欢前者,因为数字大;投资人和开发者该看后者。
中国模型占四席:钱和量各拿多少
前十里的六个中国模型,加起来一周调用量约 106T tokens,估算收入合计约 2.6 亿美元。三个美国模型(GPT-6 Luna、Opus batch、Sol batch)调用量 18T,估算收入 2.3 亿美元。量是中国模型五倍多,钱却基本持平。
Menlo Ventures 11 月发布的报告给了另一个视角:美国企业的开源模型支出里 89% 流向中国模型,Kimi 占 61%、DeepSeek 15%、智谱 11%。同时开源模型在企业 token 消耗中占比从 11% 涨到 19%,支出占比却从 6% 降到 4%。用量在涨、单价在跌,这就是剪刀差。
上一篇算过,闭源阵营内部"每美元买几分"差 17 倍;这一篇的数字说明开源和闭源之间,单位 token 的价差是另一个量级。两个阵营现在打的是两场仗:一个卖智能,一个卖吞吐。显卡新闻里那些各说各话的数字是同一个故事:同一件事,选不同的分子分母,能讲出完全相反的结论。
这笔估算的口径边界
把估算方法交代清楚,免得数字被当成实数传。OpenRouter 公开的是 token 路由量,不公开收入;输入输出比例 4:1 是我按 agent 类负载的常见形态设的,抓取类任务实际输出占比可能低于 20%,那样收入估出来还会更低。
缓存命中也没有计价。OpenRouter 的价格里 cache read 通常远低于正常输入价,Flash 这类模型的缓存命中率不低,真实账单会比我估的小一截。所以 760 万美元一天应该读作"牌价上限",真实数字大概率在它的一半到八成之间。
有一点倒是确定的:不管口径怎么调,调用量榜和收入榜的错位方向不会变。单价差两个数量级的两个市场在同一张榜上排名,这件事本身就是当下大模型商业结构的缩影。
FAQ
Q:760 万美元一天是 DeepSeek 官方收入吗?
不是。这是按 OpenRouter 公开的周 token 路由量和 DeepSeek 牌价、假设 4:1 输入输出比估算的数字,只覆盖 OpenRouter 一个渠道,不含 DeepSeek 官方 API 和其他平台。实际收入结构里 OpenRouter 只是一部分。
Q:为什么调用量第一收入只排第三?
价格差了两个数量级。Flash 定位是成本敏感的批量任务,输入价 0.01 美元每百万;Opus batch 服务高价值任务,输入 2 美元。调用量放大 10 倍补不上单价差 200 倍的缺口。
Q:连续 27 周超越美国模型指的是什么?
指 OpenRouter 平台上中国模型的周 token 调用总量持续高于美国模型,且当期调用量前五中中国模型占四席。这是用量口径的领先,不是收入或能力口径。
Q:4:1 的输入输出比靠谱吗?
是个粗略假设。agent 抓取、文档处理类任务输出占比低,长上下文输入占比高,真实比例可能更偏向输入。比例只影响估算绝对值,不改变量价错位的结论方向。
Q:普通开发者该看哪个榜?
按需求选:跑批量流水线看调用量榜,那里是性价比市场;接高价值业务看能力和每任务成本,参考 Artificial Analysis 这类独立评测。两个榜回答的是两个不同的问题。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。