
一句话总结:张博开源的 linger 用 polystrata 把 125B 的 MoE 模型跑在 12GB 显卡上,2-bit 权重约 39GB。官方给的 45.5 tok/s,前提是同时有 64GB 内存;换成 32GB 内存那档只有 21.3 tok/s,首字延迟约 3 分钟。
这个演示很抓人:一张 12GB 卡,跑一个 125B 的模型。先说清楚它不是骗术,也不是魔法,是三道前提叠出来的结果。
三组数字,只有一组是真机
第一组,12GB 显卡 + 64GB 内存,Qwen3.8-Flash-Next 稳态 45.5 tok/s,明确标注不含首 token 等待。这组是实测。
第二组,12GB 显卡 + 32GB 内存,同模型 21.3 tok/s,首字延迟约 3 分钟。这组不是真机——是拿 96GB 显卡限制显存预算模拟出来的。
第三组,8GB 显存档,38.1 tok/s,脚注同样注明是 96GB 显卡上的模拟。
三组数字经常被拼在一起讲“8GB 也有 38 tok/s”,但它们的测试条件不同,不能横向比。官方文档自己也提醒了这一点。
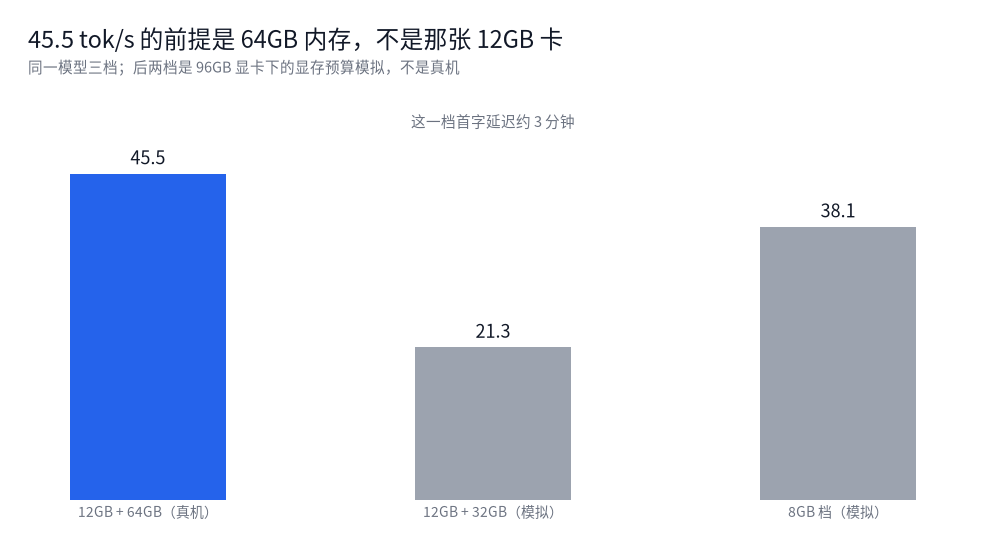
图 1:只有第一根柱子是真实硬件
125B 怎么装进 12GB
靠的是 polystrata 这个 MoE 推理引擎。它的思路不复杂:MoE 的专家是稀疏激活的,每个 token 只走少数几个专家,所以没必要把所有专家都放在显存里。
做法是分层:热专家留在显存,其余放系统内存,再冷的放 SSD,用到时按需调度。Qwen3.8-Flash-Next 的 2-bit 量化文件约 39GB,正好塞进 64GB 内存,显存只负责当前这一步要用的专家。
这是用时间换空间。显存不够,就拿内存带宽和调度延迟去补。
polystrata 已适配 12 个开源模型,包括 Qwen、DeepSeek、Gemma 几个系列,还有 Qwen3.8-27B、Spark-X2.6-4B。不是只为一个演示模型定制的。
图 2:芯片很小,权重很大,中间靠一条慢速传送带
45.5 tok/s 卡在内存带宽上
算一笔账就清楚了。解码阶段每个 token 都要把激活的权重读一遍,显存带宽再高也没用,因为权重不在显存里。
# 估算:解码时每 token 要读多少权重,需要多少带宽
active_b, bits = 8, 2                 # 假设激活 8B,2bit 量化
per_tok = active_b * 1e9 * bits / 8 / 1e9   # GB / token

for tps in (45.5, 21.3):
    print(tps, "tok/s →", round(per_tok * tps, 1), "GB/s")

print("DDR5-5600 双通道理论上限", round(5600 * 8 * 2 / 1000, 1), "GB/s")
print("12GB 显存等效带宽(按 1TB/s 计)", 1000, "GB/s")
按“激活 8B、2bit”估,每 token 要读 2GB,45.5 tok/s 就是 91GB/s。而 DDR5-5600 双通道的理论上限是 89.6GB/s。
这个结果说明什么?说明它已经把内存带宽吃满了,45.5 tok/s 不是模型能力上限,是内存条的物理上限。换更快的内存能提,换更大的显存能提得更猛;换更强的 GPU 核心,一点用都没有。
这也解释了 21.3 tok/s 那档:内存砍半、还要分页到 SSD,调度开销直接翻倍。首字 3 分钟不是模型慢,是它在把 39GB 权重从 SSD 往内存里搬。
“零 token 费”这句话要打折
官方主打的是本地推理不产生云端账单。这话没错,但只是把账单换了科目。
硬件:12GB 显卡 + 64GB 内存,按现在 DRAM 的行情,64GB 内存条本身就不便宜——32GB DDR5 套装已经超过 500 美元。电费:满载跑一天,几十度电。时间:同样的任务,云端 API 几秒出结果,这里要等。
真正的价值不在省钱,在另外三件事:数据不出本机、断网可用、模型可以随便换。对处理邮件、日历、本地文件的个人 Agent 来说,这三条比省几块钱重要得多。
但有个细节要盯:linger 的操作权限是“用户授权的运行环境”,可以读文件、用已登录的浏览器、跑命令行,靠确认卡和服务端校验拦写入动作,没有沙箱隔离。这意味着它的安全边界是“你信不信这个程序”,而不是“它被关在盒子里”。本地跑模型省掉了云端风险,但同时把权限交回给了本地进程。
这套东西适合谁
适合三种人:想试冷门或私有模型、不想付 API 费的人;处理敏感数据、不能上云的人;离线环境。
不适合两种场景:高并发(单机一条内存通道,吞吐就那样)、长上下文(KV cache 要占显存,本来就不够)。
我的判断:这个演示的真正意义不是“12GB 跑 125B”,是“显存不再是硬门槛”。门槛从显存挪到了内存带宽和容量,这对消费级硬件是个好消息——内存比显卡便宜,也更容易加。
顺带一句:这条路和站内写过的另一条正好相反。145B 塞进 29GB 靠的是每秒 400GB 带宽,走的是显存堆叠;polystrata 走的是把权重摊到内存。两条路的瓶颈一个是 HBM,一个是 DDR,钱花在不同地方。
FAQ
Q:12GB 显卡真能跑 125B 吗?
能跑,但要配 64GB 内存,且速度受内存带宽限制。45.5 tok/s 是在这个组合下测的,不是 12GB 卡单独的成绩。
Q:2-bit 量化后模型还能用吗?
能用,质量会降。具体降多少要看模型和任务,官方没给评测分数,只给了吞吐。这也是它目前只能算“可玩”的原因。
Q:和 8GB 档的 38.1 tok/s 怎么比?
不能比。那一档是 96GB 显卡上的显存预算模拟,不是真 8GB 卡跑出来的。
参考资料
- 华尔街见闻 · 前 DeepSeek 成员张博开源 linger,主打零 token 费(2026-11-20,三档配置、39GB 权重与 polystrata 说明)
- 站内 · 145B 模型怎么塞进 29GB:每秒要 400GB 带宽(另一条路线的对照)
- BornCity · DDR5 32GB 套装已超 500 美元(2026-11-18,内存成本背景)
核验方式:45.5、21.3、38.1 tok/s,12GB / 64GB / 32GB / 8GB 三档配置,39GB 2-bit 权重、12 个适配模型、96GB 显卡模拟条件、确认卡与无沙箱的权限说明,取自华尔街见闻对官方文档的转述;500 美元取自内存行情。91GB/s、89.6GB/s、2GB/ token 是我按“激活 8B、2bit”的假设算的,激活参数官方未逐层公布,这组数属估算,用于说明瓶颈位置,不作为性能结论。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。