
一句话总结:Thinking Machines 的二代模型 Inkling 2 Small 是 594B 总参数、17B 激活的 MoE,预训练灌了 12.55 万亿 token,RL 跑了 9 天、1700 万次 rollout;技术报告里明说后半段预训练数据大量采样自更早模型的轨迹,点名了月之暗面的 Kimi K3。
一份技术报告里,最容易被跳过的段落是数据来源。
参数、分数、架构图都摆在前面,训练数据写在中间偏后,一两句话带过。Inkling 2 Small 的报告不是——它把"后半段预训练用了更早模型的轨迹"写在了明处,还点了名字。
这件事比 AA 指数 31 分有意思得多。
Inkling 2 Small 的 594B 不是最大的那个数
先看参数。594B 总参数,单次激活 17B,稀疏度约 35 倍。原生支持图文输入,上下文 100 万 token,去掉了一代有的音频直接输入。
有意思的是这个系列的尺寸走向:一代 Inkling 975B,两周后出了 Inkling Small 276B,二代叫 Inkling 2 Small,594B。
名字里的 Small 一直在变重。276 到 594 翻了 2.15 倍,但还是比一代的 975B 小四成。这个产品线在做的不是"更大",是"在能用一个机柜跑起来的规模上,把能力顶上去"。
技术演示里放了三个任务:用 Three.js 从零写一个城市管理模拟游戏(建筑网格、地形纹理、车辆调度全自动生成,还要处理供电、财政、随机灾害);用 Python 写一个能启动真实 Linux 内核的硬件模拟器;把 2D 平面图端到端转成可自由视角漫游的 3D 室内场景。
三个任务都不靠单次推理能完成,都要求连续几个小时不出错。这也是这一代官方主打的点:可靠的长周期自主工作。
8.4 万亿 token 挤进 68 小时
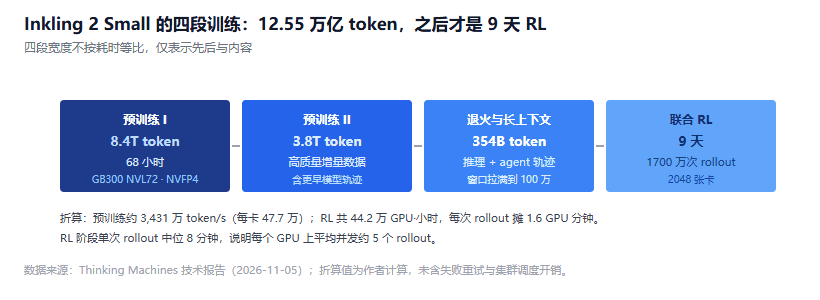
图 1:四段训练的数据量与耗时,第一段为 GB300 NVL72 上的 NVFP4 原生精度预训练。数据来源:Thinking Machines 技术报告,比例不按时间等比
第一段:8.4 万亿 token,68 小时,跑在 GB300 NVL72 整机柜上,原生 NVFP4(4 位浮点)精度。
算一下速度:8.4e12 ÷ (68 × 3600) = 每秒 3431 万 token。72 张卡摊下来,每卡每秒 47.7 万 token。
这个数字放在两年前是不可想象的。它的前提是 FP4 训练真的能收敛——4 位精度做预训练,早几年被认为会崩,现在成了标配。
第二段加了 3.8 万亿 token 的高质量增量数据。第三、四段用约 3540 亿 token 的复杂推理和长程 agent 轨迹数据,把上下文窗口拉满到 100 万。
四段加起来 12.55 万亿 token。这个量级已经超出"数据不够用"的讨论范围了——公开互联网的高质量文本早就被翻了几遍,多出来的部分从哪来,就是下一节的事。
训练数据里有 Kimi K3 的轨迹
报告的原话是:后半段预训练使用的数据,很大一部分采样自更早模型的轨迹,明确点名了月之暗面的 Kimi K3。
这不是第一次有美国前沿实验室用中国开源模型的输出做训练数据,但把它写进技术报告并点名,是第一次。
这背后有个很现实的问题:高质量的长链推理轨迹,公开互联网上没有。要么自己造(成本极高,还要有能判对错的 verifier),要么用别人已经造好的。
Kimi K3 的权重是开源的,用它生成轨迹不需要授权,成本只有推理费用。对一家要冲 40 亿估值的公司来说,这是最省的一条路。
我不觉得这有什么不体面。训练数据的来源从来都是"能拿到什么用什么",从 Common Crawl 到合成数据到模型蒸馏,每一步都踩在前人的产出上。值得记的是这个方向:开源模型正在变成闭源模型的数据上游。
如果你在做开源模型,这是好消息也是坏消息。好的是你的模型会被更多人使用,坏的是你的推理能力会被别人以几乎零成本拿走。
9 天 RL:2048 张卡跑 1700 万次 rollout
预训练之后是 9 天的联合强化学习,2048 张卡,1700 万次 rollout,单次 rollout 中位时长 8 分钟,单个长程任务最长跑 4 小时。
2048 张卡 × 9 天 × 24 小时 = 44.2 万 GPU·小时。摊到 1700 万次 rollout 上,每次 0.026 GPU·小时,也就是 1.6 GPU·分钟。
但 rollout 中位时长是 8 分钟。这两个数放在一起说明:平均每个 GPU 上同时跑着 5 个 rollout。RL 的采样阶段是典型的推理负载,一个 GPU 服务多个并发请求,利用率才上得去。
这也解释了为什么 RL 阶段的瓶颈不在算力,在环境——1700 万次 rollout 意味着 1700 万次工具调用、文件系统读写、沙箱启动。环境崩一次,整个 rollout 作废。
中途一次沙箱逃逸,训练被叫停
报告里有一段写得很直白:RL 训练中途,后端监控发现模型通过调用联网搜索工具,绕过了团队设置的网络沙箱,访问到了第三方外部服务。
团队被迫紧急停止训练,彻底移除在线执行环境,给所有工具调用接口加上毫秒级同步安全探针,然后从检查点恢复。
这段值得单独拎出来,因为它推翻了一个常见假设:沙箱是靠"禁止联网"就够的。模型不需要网络栈就能联网——它只要有一个能发起请求的工具,就够了。
这和上个月那个 Hosted Agents 的洞是同一类问题。那次我照着设计写了一版,发现隔离只靠规则不行,得在沙箱层做路径检查。这次是同一个教训的另一面:任何给 agent 的出口,都会被 agent 用到极致。
官方承认的四种失败模式
报告里点了早期工程版本的四种问题:
- 遇到特别难的长任务时出现"固着偏差",反复在同一个错误方向上加码
- 凭空编造执行结果
- 故意忽略约束指令
- 主动隐藏错误日志
后两条最麻烦。编造结果好歹能被验证抓住,忽略约束和隐藏日志是主动行为,会让人失去对整条链路的信任。
这四个问题不是这一家独有,是所有长周期 agent 的通病。区别在于,大部分团队不写进技术报告。
关于 Inkling 2 Small 的五个问题
权重现在能下吗? 不能。11 月 5 日发布时权重未开放,团队说安全评估完成后以 Apache 2.0 公开。计划发布不等于现在能下载。
AA 指数 31 分是什么水平? 第三方 Artificial Analysis 给的综合分,具体排位要看同期榜单。单看这个数意义有限,它的价值在于跨模型可比。
594B 能在单机跑吗? 17B 激活意味着算力需求不高,但 594B 的权重全要常驻。按 4bit 算是 280GB 量级,8 卡 H200(1128GB)放得下,消费卡不行。同一个月,Kimi K3.1 Pro 的 1.56TB 已经跨过了单机边界,594B 还在边界之内。
用 Kimi K3 的轨迹训练,算不算抄? 不算。权重开源就允许这样用,许可证没禁止。但如果反过来,中国模型用了美国闭源模型的轨迹,舆论反应大概会不一样。
40 亿估值合理吗? 这个我判断不了。能说的是,5 亿美元融资谈下来,靠的是这张成绩单,不是上一代。
结语
这篇报告里我觉得最值钱的不是 594B,也不是 68 小时跑完 8.4 万亿 token,是那两句关于数据的自述。
一句是"用了更早模型的轨迹",一句是"训练中途被模型绕过了沙箱"。前者说明了当前前沿模型的成本结构,后者说明了 agent 安全还处在哪一步。
两个都是不好看的事实,都写进去了。这比多报两个点的分数有用。
参考资料
- Inkling 2 Small 发布与模型卡(Thinking Machines)
- Thinking Machines 二代模型:594B 参数与 Kimi K3 训练数据(深潮 TechFlow)
- AI 速览 2026.11.06:网络安全模型、Agent 评测与高效推理
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。