
一句话总结:Edge0-145B 用 145B 总参、10B 激活的稀疏结构,把峰值内存压到 29GB,但按 80 tok/s 反推,每秒要搬 400GB 数据,只有显存和统一内存供得起,SSD 那层的带宽差 57 倍。
11 月 13 日 Edge0 开源了两个端侧模型,145B 和 120B,配套推理框架一起放出。宣传里最抓眼的三个数:145B 参数、29GB 峰值内存、笔记本上 80 tok/s。
三个数放在一起,很多人的第一反应是"量化真厉害"。我的第一反应是算带宽:生成一个 token 要把激活权重全部过一遍,80 tok/s 意味着每秒搬多少数据。这个数一出来,29GB 背后到底是什么结构就清楚了。
Edge0-145B 的三层存储怎么分
官方给的架构分三层:高频"热专家"常驻显存,约 40GB 的专家库放在系统内存按需调入,约 48GB 的词表数据存在 SSD 上实时读取。总参数 145B,每次推理只激活约 10B。精度给两档,NVFP4 和 MXFP8。
这套设计的目的很明确:把 145B 的权重拆成"热的、温的、冷的",只把真正要算的部分留在最贵的存储里。想法不新,难在调度——什么时候把哪一层的数据搬进来,搬错了就是几十毫秒的卡顿。
上一篇算 Kimi K3.1 Pro时用的是同一套思路的反面:1.56TB 权重只能全量塞进 12 张 H200,没有分层可言。端侧模型的全部工作,就是把"装不下"变成"分着装"。
29GB 的账:5GB 激活权重占多少
先把激活权重算出来。10B 参数按 NVFP4 存,是 5.0GB;按 FP8 是 10GB。29GB 峰值内存减去这两档,分别剩 24GB 和 19GB 给 KV cache、激活值缓冲和框架本身。
剩下的空间够不够开长上下文,取决于 KV 怎么算。按 64 层、8 个 KV 头、head_dim 128 的典型配置,128K 上下文的 KV 在 fp16 下要 32GiB,超出 29GB 预算;换成 fp8 是 16GiB,勉强塞得进 24GB 的余量。
这解释了一个容易被忽略的前提:官方说支持 128K 到 256K 上下文,那个上下文长度是在 KV 量化之后才成立的。256K 按 fp8 要 32GiB,已经超出预算,大概率要配合滑动窗口或者更激进的 KV 压缩。这一点发布信息里没写,是我按数字推的,存疑。
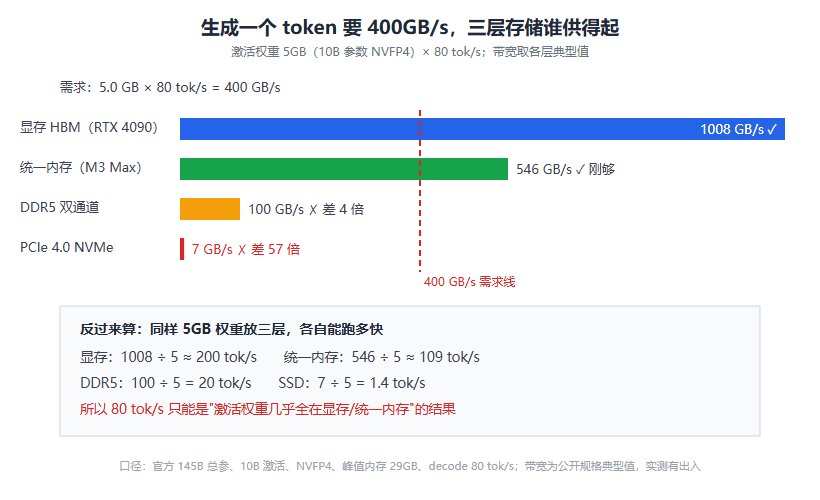
图 1:同样 5GB 激活权重,放显存能跑 200 tok/s,放 SSD 只有 1.4 tok/s
每秒 400GB 带宽:这个数怎么来
decode 阶段每个 token 都要把激活权重完整读一遍,这是自回归解码的物理约束。5.0GB × 80 tok/s = 400GB/s。
400GB/s 是什么概念:RTX 4090 的显存带宽 1008GB/s,够;M3 Max 的统一内存 546GB/s,刚够;DDR5 双通道 100GB/s,差 4 倍;PCIe 4.0 的 NVMe 7GB/s,差 57 倍。
所以 80 tok/s 这个数字本身就交代了架构的真相:激活权重几乎全在显存或统一内存里,只有极少数 miss 才去系统内存和 SSD 捞。宣传里"三层存储"容易被误读成"权重分散在三层、按需读取",实际运行时 98% 的读取发生在最快的两层。
这也是为什么官方建议的硬件是 M 系列 MacBook Pro 和 RTX 4090/5090:统一内存够大(48GB 以上)或者显存带宽够高。普通笔记本的 DDR5 内存,连 20 tok/s 都跑不到。这个反推法和27B 在 24GB 卡上的账同源:先算带宽除以权重,得到单路速度上限,再倒推什么配置能兑现宣传数字。
SSD 只能供 1.7%:流式加载的真相
按 80 tok/s 算,每个 token 只允许从 SSD 读 88MB(7GB/s ÷ 80)。88MB 占 5GB 激活权重的 1.7%。
这个比例说明,SSD 那 48GB 数据在实际推理里几乎不参与主循环。它更像一个"仓库":模型加载时把热专家预热到内存,运行中只在换任务、切专家集时读一次盘。真要每个 token 都读,速度会掉到 1.4 tok/s,比人打字还慢。
投机解码能把这笔账摊薄一些。假设一次前向平均出 4 个 token,读取成本摊到 4 个 token 上,每 token 的 SSD 预算变成 350MB,仍然远远不够 5GB。所以投机解码能救一点,救不了根本。
官方数据里对不上的 16GB
有个数对不上。145B 参数按 4bit 全量算是 72GB,官方的三层存储加起来是 40 + 48 = 88GB,差 16GB。
可能的解释有几种:词表那 48GB 是 fp16 存的原样数据,不含在 4bit 量化里;或者仓库里同时放了 NVFP4 和 MXFP8 两套权重;或者 40GB 专家库里有一部分是冗余副本用于快速切换。发布信息没有分项说明,我没法确定是哪一种。
能确定的是这个差额的存在本身说明"145B 装进 29GB"这句话需要加限定:29GB 是运行时峰值,不是权重的全部体积。下载体积和磁盘占用是另一个量级,几十 GB 起。
什么人该等这个模型
三类人值得关注。数据不能出内网的,端侧跑 145B 级模型把合规问题一次性解决;长期跑 agent 的,本地推理把按 token 计费变成电费,用满一年就回本;做量化和微调研究的,145B 的开源底座目前市面上不多。
三类人先别急。指望在 16GB 内存的轻薄本上跑的,29GB 峰值就把门槛卡死了;要跑高并发的,端侧单机能提供的并发是个位数;对精度敏感的,NVFP4 的四位量化在长文推理上会掉点,没有实测分数前别押生产。
框架和 App 的仓库已经有 1.08 万星,权重在 HuggingFace,评测脚本一起开源。这套东西能不能兑现,社区跑一轮就知道。我自己的判断是架构方向对,80 tok/s 那个数在 MacBook Pro 上大概能复现,普通 Windows 笔记本要打个对折。
FAQ
Q:29GB 是显存还是内存?
在 Mac 上是统一内存的峰值占用,显存和内存共用。在 Windows + 独显的配置上,这个数指系统内存加显存的合计峰值。两种平台的含义不同,看官方说明时容易混。
Q:为什么 145B 只激活 10B 就能保持能力?
MoE 架构下每个 token 只路由到少数专家,参数量决定知识容量,激活量决定单次计算开销。这是稀疏模型的标准设计,Kimi K3.1 Pro 的 2.8T 总参激活更少,同一个思路。
Q:SSD 那 48GB 数据到底怎么用?
主要在加载和切换时读取,运行中命中率很低。按 80 tok/s 反推,每 token 从 SSD 读的上限只有 88MB,占激活权重的 1.7%,不可能参与主循环。
Q:普通笔记本能跑吗?
峰值内存 29GB 是硬门槛,16GB 内存的机器装不下。能跑的最低配置是 32GB 内存加不错的 CPU,速度会明显低于 80 tok/s。
Q:NVFP4 和 MXFP8 选哪个?
NVFP4 省一半空间、需要至少 500GB 显存的说法针对的是未压缩的原始规模,端侧用 NVFP4 才能在 29GB 里跑。精度要求高的场景用 MXFP8,但要接受内存翻倍。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。