
一句话总结:UCSD 的 JetSpec++ 宣称生成速度最高提升 7.45 倍,这个数字本身没问题,但它是峰值不是均值。投机解码的加速比完全由草稿接受率决定,我按经典 draft-and-verify 模型算了一遍:接受率 0.7 时约 2.3 倍,0.85 时约 3.7 倍,要做到 7.45 倍需要接受率超过 0.96。买服务的时候按均值估,别按峰值估。
一、先说这个 7.45 倍
公开信息里对 JetSpec++ 的描述只有一句话:UCSD 的方案结合了因果并行草稿、隐状态预测与流水线验证三件事,宣称生成速度最高提升 7.45 倍。
我没找到对应的论文正文,所以这篇不逐条拆它的实现,而是把投机解码这件事的原理和收益边界算清楚。这样你看到一个加速比时,能自己判断它靠不靠谱。
这个能力比记住某个框架的参数有用得多。
二、原理很简单:猜和验
投机解码的思路一句话能说完:用小模型快速猜几个 token,再让大模型一次性验证这批猜测。
具体过程是这样。解码阶段大模型每步只出一个 token,但它的算力其实没跑满,因为这一步是访存瓶颈,等权重和 KV cache 的时间比算的时间长。投机解码利用这段空闲:小模型连续猜 k 个 token,大模型把这 k 个候选一起送进一次前向,逐个校验。
校验规则很干脆:从左往右,接受第一个不匹配之前的全部,丢弃之后的所有,大模型在断点处自己再补一个。所以一轮下来至少产出 1 个 token,最多产出 k+1 个。
这里有个很重要的性质:输出分布和串行解码完全一致。 因为它不是让大模型接受次优结果,而是让大模型用自己的判断去验证,验证通过的 token 本来就该是大模型会选的。这是少数"加速但不降质"的手段。
三、加速比由什么决定
只有两个变量起作用:接受率,和草稿的成本。
按经典模型算,一轮的产出期望是 (1 - α^(k+1)) / (1 - α),耗时是 k × 草稿成本 + 1(1 代表大模型那次前向)。两者一除就是加速比。
我写了段代码把这个表算出来,参数是草稿成本 0.1(草稿模型单步耗时是大模型的十分之一):
 接受率 |     k=2 |     k=4 |     k=8 |    k=16
--------------------------------------------
  0.50 |   1.46x |   1.38x |   1.11x |   0.77x
  0.60 |   1.63x |   1.65x |   1.37x |   0.96x
  0.70 |   1.82x |   1.98x |   1.78x |   1.28x
  0.80 |   2.03x |   2.40x |   2.40x |   1.88x
  0.90 |   2.26x |   2.93x |   3.40x |   3.20x
  0.95 |   2.38x |   3.23x |   4.11x |   4.48x
这张表里有三个反直觉的结论。
接受率低的时候,猜得越多越慢。 0.5 的接受率下,k=16 只有 0.77 倍,比不加速还差。因为草稿本身要花时间,猜 16 个猜错大半,纯浪费。
k 不是越大越好。 每个接受率都有一个最优点。0.7 时 k=4 最优(1.98 倍),0.9 时 k=16 才好(3.20 倍)。这个最优值跟草稿成本强相关。
上限不高。 就算接受率 0.95、猜 16 个,也只有 4.48 倍。想再高,只能把草稿成本压得更低。
四、7.45 倍需要什么条件
我又算了一遍:草稿成本假设降到 0.05,要达到 7.45 倍,需要多高的接受率。
  k= 4  需要接受率 ≥ 0.999(此时理论加速 4.16x)
  k= 8  需要接受率 ≥ 0.999(此时理论加速 6.4x)
  k=16  需要接受率 ≥ 0.969(此时理论加速 7.45x)
k=32 需要接受率 ≥ 0.964(此时理论加速 7.45x)结论很直接:7.45 倍需要接受率 0.96 以上。
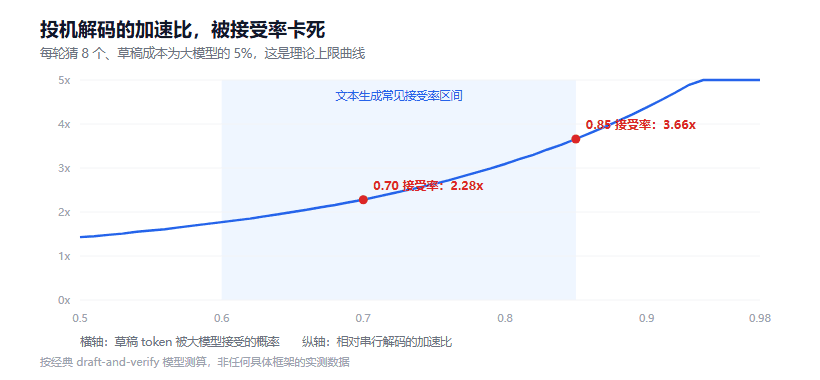
图 1:按 k=8、草稿成本 0.05 算的上限曲线。蓝色区间是文本生成的常见接受率范围
图里能看得很清楚。文本生成任务的接受率通常在 0.6 到 0.85 之间,对应这条曲线上的 1.7 到 3.7 倍。要爬到 7 倍以上,得挤到曲线最右侧那段,也就是接受率 0.96 以上。
这种接受率在什么情况下会出现?我的理解是有两种。一种是任务极度可预测,比如代码补全、格式化输出、模板填充,模型几乎不用想就知道下一个词是什么。另一种是草稿模型和目标模型同源,比如同一家族的蒸馏版,它们的分布高度一致。
通用对话场景达不到这个水平。
五、给它留个余地
上面所有计算都基于经典的"双模型"框架:一个独立的小模型当草稿。这种方案里草稿成本压不到很低,因为小模型也得跑一次完整前向。
JetSpec++ 提到的"隐状态预测",属于另一类做法,典型的代表是 EAGLE 系列。这类方法不单独跑一个小模型,而是复用目标模型的特征层来预测后续 token,草稿成本能降到 0.02 甚至更低。
成本一低,同样的接受率下加速比就上去了。按 0.05 的成本算,接受率 0.9 时 k=16 能有 6 倍多。所以 7.45 倍不是不可能,它是"高接受率 + 极低草稿成本"这个组合下的结果。
我要强调的是:这是峰值条件,不是默认条件。 论文里写"最高提升 7.45 倍",最高两个字是有意义的,它对应某个特定任务、特定配置、特定 batch size。
六、部署时该怎么判断
如果你在选推理服务,或者自己搭,几个判断点。
先问接受率。 供应商如果只给你一个加速比,问它是哪个任务、什么接受率下测的。说不出来的,那个数字就当作参考价,别当预算依据。
看你自己的任务类型。 代码补全、结构化输出、固定格式生成,这类任务接受率高,值得开。开放式长文创作、需要大量创意的场景,接受率低,开了可能反而慢。
小 batch 才有意义。 投机解码提升的是单请求延迟,靠的是利用空闲算力。batch 打满的时候大模型算力本来就紧张,再塞草稿进去,反而抢资源。高并发服务先优化批处理,别急着上投机。
草稿模型要跟目标模型配套。 乱配一个草稿模型,接受率会低到没法看。要么用官方配套的,要么自己训一个。
FAQ
投机解码会改变输出质量吗?
不会。它验证通过的 token 就是目标模型本来会选的,输出分布与串行解码一致。这是它有别于量化、蒸馏的地方。
本地部署值不值得开?
看你跑什么。单用户、低并发、任务类型固定(比如写代码、格式化),值得。多人共享一张卡、任务五花八门,收益不明显。
为什么有的实现里开了反而变慢?
两个原因:接受率太低,草稿的消耗大于收益;或者显存本来就紧,多加载一个草稿模型把 KV cache 挤掉了,触发换页。
7.45 倍这个数字可信吗?
数字本身可信,它是实测峰值。不可信的是把它当平均值用。通用任务按 2 到 3 倍估比较稳。
和量化哪个优先?
先量化。量化省显存、提速稳定、不依赖任务特点。投机解码是在量化之后还想再快时的下一步。
结语
这类"最高提升 N 倍"的宣传,在推理优化领域特别容易误导,因为加速比不是硬件参数,它跟你的输入强相关。
我给个简单的判断方法:看到加速比,先找接受率;找不到接受率,就按 2 倍估。
站里之前写过真实压测的方法和部署超大 MoE 的显存账,三篇连起来是一套完整的推理成本核算:怎么测准、显存怎么算、加速手段能拿多少。
参考资料
- Communeify - 11 月 1 日 AI 日报,含 JetSpec++ 发布说明
- Hugging Face 文档 - Assisted decoding 与投机解码实现
- LuMay - LLM 推理优化的九种手段与取舍
- vLLM 文档 - 投机解码配置与限制
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。