
一句话总结:看到「1T 参数开源」想自建,第一笔账不是买卡,是算显存——BF16 权重约 2TB 起步,加上激活和框架开销要按 1.2 倍预留;然后按「张量并行切算力、专家并行切专家」的思路凑卡;再把机器时价换算成每百万 Token 成本,跟 API 报价比完再决定要不要建。本文所有数字是估算,我没有这样的机器。
Mistral Large 4 放出 1T 权重之后,「自托管」这个词又热了起来。但 1T 和 35B 不是一个游戏:35B 量化后一张消费卡能跑,1T 是机房项目。
这篇把账一步步算清楚。所有数字按行业通行估算方法推出,我没有实际部署过,拍板前请以第三方实测为准,Clover 那篇的小规模路径可以对照着看。
第一步:权重要占多少显存
权重大小 = 参数量 × 每参数字节数。三档精度:
| 精度 | 每参数字节 | 1T 权重体积 | 备注 |
|---|---|---|---|
| BF16 | 2 | 约 2TB | 官方参考精度 |
| FP8 | 1 | 约 1TB | 推理常用,质量损失很小 |
| INT4 | 0.5 | 约 500GB | 激活值敏感的 MoE 要小心 |
三个修正项让实际比理论值大:
1.2 倍预留。 框架本身、CUDA 上下文、通信缓冲、激活值都要占显存。行业经验是按权重的 1.2 到 1.3 倍配卡。BF16 那档实际要准备 2.4TB 左右。
激活量未知。 Mistral 没公布 Large 4 的激活参数,这意味着两个数算不出来:单 token 的计算量(影响吞吐预估),和激活值峰值(影响显存余量)。这是目前自建评估最大的盲区,等第三方拆解。
KV cache 是大头。 长上下文的缓存随并发线性涨。128K 上下文、几十路并发的服务,KV cache 可以吃掉几百 GB。它不随权重量化而变小。
第二步:并行策略,大白话版
单卡装不下,就要把模型切到多张卡上。三种切法解决三个不同的问题:
张量并行(TP):把「一次矩阵乘法」切开,多张卡各算一块,结果拼起来。解决「单层太大」的问题。通信量极大,卡之间必须走高速互联(NVLink 级别),跨机器会很痛苦。
专家并行(EP):MoE 有几百个专家,把不同专家放不同卡。每个 token 只路由到少数专家,所以大部分通信是「token 找专家」,负载均衡是关键难题——热门专家的卡会先饱和。
流水线并行(PP):把层切开,前一半层在 A 机器、后一半在 B 机器。通信量最小,但有空泡(一部分卡在等),吞吐有折损。
实际的超大模型部署是三者混用:机内 TP + 机间 EP + 跨机 PP。 这也是为什么自建需要的不只是卡,还有一台配好 NVLink/InfiniBand 的机器——把 16 张没有高速互联的卡凑一起,实际吞吐会远低于理论值。
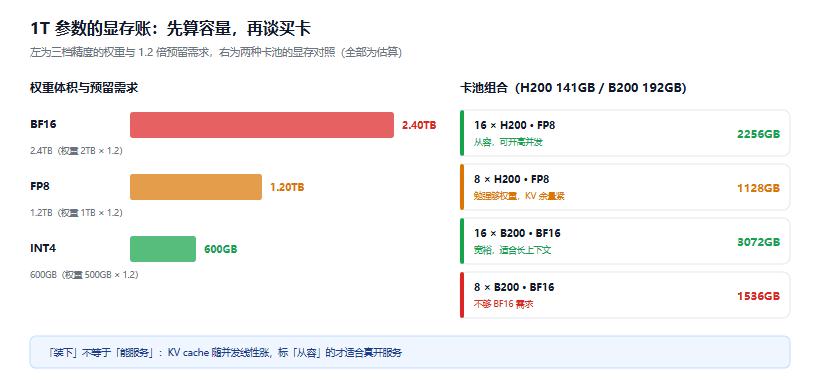
图 1:左为三档精度的权重体积(含 1.2 倍预留),右为两种卡池组合的显存对照
第三步:卡的组合方案
以 H200(141GB)和 B200(192GB)为参照:
| 方案 | 精度 | 总显存 | 够不够(含 1.2 倍预留) |
|---|---|---|---|
| 8 × H200 | FP8 | 约 1128GB | 够 1TB 权重,KV 余量紧张 |
| 16 × H200 | FP8 | 约 2256GB | 从容,可开高并发 |
| 8 × B200 | BF16 | 约 1536GB | 不够 BF16(2.4TB 需求),FP8 从容 |
| 16 × B200 | BF16 | 约 3072GB | 宽裕,适合长上下文高并发 |
直觉上的提醒:「刚好装下」和「能服务」是两回事。 装下只算权重,服务还要给 KV cache 和峰值激活留空间。表里标「从容」的方案才适合真开服务,标「够」的方案实测大概率 OOM。
第四步:成本换算,和 API 比
机器时价按市场行情估(波动大,仅示意):H200 约 $2–4/卡/小时,B200 约 $4–7/卡/小时。
以 16 × H200 跑 FP8 为例:
机器成本:16 × $3 = $48/小时
假设吞吐(估算):批量 3000 tok/s → 一小时 1080 万 token
每百万 token 成本:48 ÷ 10.8 ≈ $4.4
对比 Mistral API:输入 $0.70、输出 $2.10。
结论直白:吞吐做不到 3000 tok/s 以上,自建就是亏的。 而 3000 tok/s 需要不错的并发和利用率——自建的成本模型里最贵的是闲置,不是卡。
把上篇的压测方法用起来再拍板:先在云上按小时租同样的配置压测一周,拿到真实的吞吐和利用率数据,再决定是租长期还是继续用 API。
五个坑,按命中率排
坑 1:只按权重配卡。 2TB 权重配 2TB 显存,起服务就 OOM。1.2 倍是底线,长上下文要 1.3 倍以上。
坑 2:低估 KV cache。 128K 上下文的并发服务,KV cache 是显存里涨得最快的一块,比激活值大一个量级。要按「并发数 × 上下文长度 × 每 token KV 大小」单独算。
坑 3:忽略互联成本。 卡没问题,机器间的 InfiniBand 交换机、光模块、布线是隐性大头。跨机通信不畅,EP 的吞吐能掉一半。
坑 4:忘了负载均衡。 EP 架构里热门专家会打满单卡。看平均利用率决定扩容是错的,要看最热那张卡。
坑 5:拿官方 tok/s 当容量规划依据。 官方数字是特定硬件、特定 batch 下的峰值。容量规划用自己的压测数据,方法在压测那篇里。
边界
这篇是算账方法,不是部署指南。三个明确没做的事:没实测任何配置、激活参数未知导致吞吐无法估准、并行调优的实际细节(通信 oveRLap、expert cache)超出范围。
自建决策的合理顺序:先压测验证吞吐 → 再算利用率下的真实成本 → 末了跟 API 价对比留出 30% 余量。 三步都过了再采购,缺一步都是赌。
参考资料
- Mistral 官方发布 - Large 4 权重与部署建议
- vLLM 文档 - 张量并行与专家并行配置
- NVIDIA H200/B200 规格 - 显存与互联带宽
- SGLang 文档 - 大规模推理部署参考
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。