
一句话总结:循环层用同一份权重跑两遍,权重显存确实省下来了。但它的 KV cache 按"层计算次数"算,56 次而不是 32 次,KV 反而更贵。在 24GB 单卡上,FP16 精度大约到 11 万 token 处反转,8bit 精度更早,5.7 万就翻过来了。省显存这件事,有前提。
上一篇拆了商汤那个 Loop 架构的层结构,讲的是它怎么用 9B 参数换来 14.6B 的等效能力。
看完之后我有个疑问一直没解决:它到底省不省显存。
直觉上当然省——权重只有一份,跑两遍又不占额外空间。但推理的时候真正吃显存的除了权重,还有 KV cache,而这一块跟"跑了几遍"直接相关。
我写了个脚本把账算清楚。结论和我一开始想的不一样。
一、先定一个能算的题目
要比较就得控制变量。
设定:单张 24GB 显卡(4090 这个级别),比较两种配置在同等能力下的显存占用。
- 稠密 14.6B:40 层,hidden 5120,代表"堆参数"那条路
- 循环 9B:32 层,中间 24 层跑两遍,共 56 次层计算,hidden 4096
两者的等效能力都标在 14.6B 附近,这才有可比性。
计算规则两条:
权重显存 = 参数量 × 每参数字节。FP16 是 2 字节,8bit 是 1 字节。
KV cache = 2(K 和 V)× 层计算次数 × hidden × 2 字节 × token 数。
第二条是重点。循环层跑两遍,两遍的输入不同,产生的 Key 和 Value 也不同,必须各存一份。所以按 56 次算,不按 32 层算。
二、权重的账:循环层确实省
先看权重这一半。
| 配置 | 参数量 | 权重占用 |
|---|---|---|
| 稠密 14.6B FP16 | 14.6B | 27.2 GB |
| 循环 9B FP16 | 9B | 16.8 GB |
| 稠密 14.6B 8bit | 14.6B | 13.6 GB |
| 循环 9B 8bit | 9B | 8.4 GB |
同精度对比,循环层省 10.4 GB(FP16)或 5.2 GB(8bit)。
这个结论和直觉一致。24GB 的卡跑 FP16,稠密 14.6B 的权重就要 27.2GB,直接装不下;循环 9B 只要 16.8GB,还剩 7.2GB 能分给上下文。
这就是它最大的价值:让一张消费级卡能跑起 14B 级别的能力。
三、KV cache 的账:循环层反而贵
问题出在另一半。
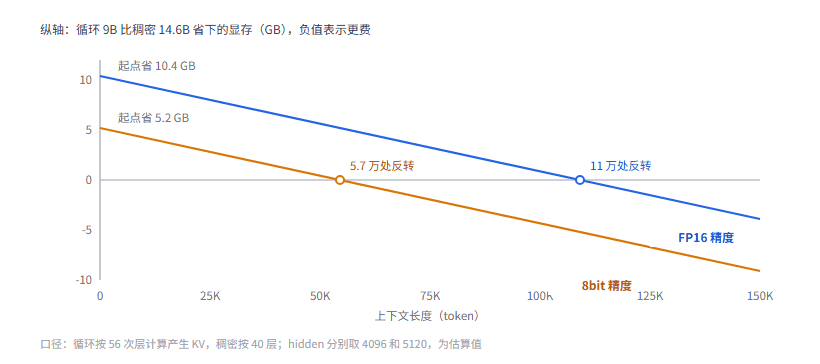
图 1:权重省下来的显存,会被 KV 一点点吃回去,两条线各有一个反转点
每 token 的 KV 占用:
- 稠密 14.6B(40 层):0.78 MB
- 循环 9B(56 次层计算):0.875 MB
循环层每 token 多占 0.095 MB。单个 token 看着微不足道,乘上上下文长度就不是了。
8K 上下文时,差距是 0.75 GB。10 万 token 时,差距是 9.5 GB——比它在权重上省下来的还多。
因为循环层的层计算次数是 56,稠密是 40,比值 1.4。KV 的差距也正好是这个倍数关系。这类按上下文线性增长的账,27B 那篇算过更极端的版本:262K 上下文光 KV 就要 48GB。
四、显存反转点在哪里
把两条线放一起,就有交点。
FP16 精度:约 11 万 token。 在这之前,循环层总占用更低;超过之后,它反而更费。
8bit 精度:约 5.7 万 token。 因为 8bit 下权重省得少(5.2GB 而不是 10.4GB),交点来得更早。
这个数字有实际意义。商汤训练上下文标的是 262,144 token,如果真按这个长度部署,循环层在显存上不但不省,还会倒亏。
不过要说明:262K 是训练上下文,不等于部署时真的开这么长。 现阶段的推理服务通常开 8K 到 32K,这个区间里循环层是有优势的。
五、用这段代码自己算显存
换个模型、换个量化精度,结论会变。下面这段可以直接跑,改参数就行。
BUDGET_GB = 24.0
CTX = 8192

def kv_mb_per_token(layers, hidden):
    """每 token 的 KV 占用,MB。layers 传层计算次数,不是层数。"""
    return 2 * layers * hidden * 2 / (1024 ** 2)

def analyze(name, params_b, layer_calcs, hidden, bytes_per_param):
    weight = params_b * 1e9 * bytes_per_param / (1024 ** 3)
    kv_tok = kv_mb_per_token(layer_calcs, hidden)
    kv_ctx = kv_tok * CTX / 1024
    left = BUDGET_GB - weight
    max_ctx = int(left * 1024 / kv_tok) if left > 0 else 0
    print(f"{name:<16} 权重 {weight:5.1f}GB  KV@8K {kv_ctx:4.2f}GB  "
          f"最长 {max_ctx:>7,} token")
    return dict(w=weight, kv=kv_tok, ctx=max_ctx)

dense = analyze("稠密 14.6B FP16", 14.6, 40, 5120, 2)
loop  = analyze("循环 9B FP16",   9.0, 56, 4096, 2)

# 反转点:权重差除以每 token 的 KV 差
delta_w = dense["w"] - loop["w"]
delta_kv = (loop["kv"] - dense["kv"]) / 1024      # GB per token
if delta_kv > 0:
    cross = delta_w / delta_kv
    print(f"\n超过 {cross:,.0f} token 后,循环层开始更费显存")
跑出来:
稠密 14.6B FP16    权重  27.2GB  KV@8K 6.25GB  最长       0 token
循环 9B FP16       权重  16.8GB  KV@8K 7.00GB  最长   8,468 token

超过 113,932 token 后,循环层开始更费显存
第一行那个 最长 0 token 是真实结论——权重就超了预算,一个 token 都开不了。
六、坑清单
1. 用层数算 KV,结论会反。 循环层的 KV 必须按层计算次数算。用 32 层去算,会得出"循环层 KV 更省"的错误结论,整个比较就废了。
2. hidden 取多少影响很大。 我按 9B 用 4096、14.6B 用 5120 估的,官方没公布准确值。hidden 差 20%,交叉点会移动 20% 左右。
3. 8bit 不总是更划算。 8bit 权重省一半,但 KV 不受量化影响(默认仍按 FP16 存)。上下文越长,权重占比越小,量化带来的优势越不明显。
4. 别忘了 activation 和临时缓冲。 我只算了权重和 KV,实际运行时还有中间激活值、CUDA 上下文、框架开销,通常要额外留 1-2GB。
5. 层计算次数多,延迟也要多算。 56 次 vs 40 次是 1.4 倍,同参数量下(9B vs 9B)是 1.75 倍。显存换来的时间成本,在长输出场景会很明显。
七、边界
这套算的是理论显存,跟实测会有出入。真实的 KV cache 实现有分页(PagedAttention)、有共享前缀复用,实际占用可能比公式算的低一些。
另外,"等效 14.6B 能力"这个前提本身是官方的说法,我按它做了等能力对比。如果实际能力达不到,那这个比较对循环层是不利的——它相当于用 16.8GB 去换一个不如 14.6B 的模型。
结语
循环层是个好设计,但它省的是一部分显存,不是全部。
判断你自己的场景要不要用它,看一个数:你的上下文常规长度是多少。
- 8K 到 30K:循环层明显占优
- 5 万到 11 万:看精度,8bit 已经反转,FP16 还在窗口里
- 超过 11 万:权重省的那点,不够 KV 还
商汤那篇讲的是它怎么做到的,这篇讲的是它在什么条件下成立。两件事得一起看。
参考资料
- AI 圈要闻 2026-11-03 - SenseNova Loop 的层数与上下文规格
- Microsoft 文档:KV cache 与 PagedAttention - 显存构成参考
- vLLM 文档 - 分页 KV cache 的实现说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。