
一句话总结:NVIDIA 的 VoiceChat 11B 和日本团队的 Haru-4B,是目前仅有的两个开源全双工语音模型。一个 448ms 但要 80GB 显存,一个 198ms、12GB 就能跑。差的不是模型,是路线。
Haru-4B 是 11 月发布的,VoiceChat 是 8 月 3 日上的权重,都被贴上“首个开源全双工”的标签——一个英文语境的首个,一个日语语境的首个。
一张表看路线差别
VoiceChat 11B:轮换延迟 448ms,建议 80GB 以上显存,英语单语,仅研究用途,无托管 API。Haru-4B:官方 65.2ms,加上 133ms 分帧是 198.2ms,12GB 能跑,九种语言,同样是研究基座。
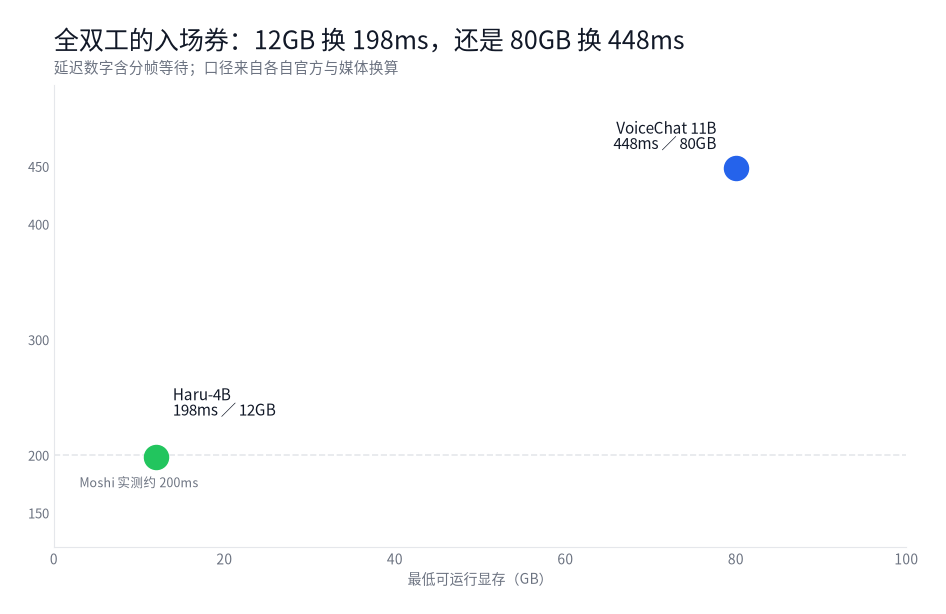
图 1:延迟差 2.3 倍,显存差 6.7 倍
差距不是优化好坏,是取舍。Haru 把帧率压到 7.5Hz,用更粗的时间粒度换更小计算量;VoiceChat 保留更细的语音建模,代价是参数和显存。
448ms 是怎么测出来的
不是端到端延迟,是“平滑轮换延迟”——你一句话说完、它开始接话的那个时间点,测于 Full-Duplex-Bench 1.0 这个专用评测集。配了两个数:平滑轮换的占用率 TOR 0.82;中途打断的接管延迟 480ms、成功率 1.00。打断它接得住,只比正常接话慢 32ms。
还有一个指标容易被忽略:停顿处理 TOR,合成数据 0.153、真实通话数据(Candor)0.255,越低越好。这一项才是全双工的真正难点——用户“嗯”了一声没说完,模型该不该抢话。0.255 说明在真实通话里,它每四次左右的停顿会有一次判断错。
所以 448ms 这个数字的含金量,比 Haru 那个 65.2ms 实在:它有评测集、有 TOR、有打断指标。Haru 那边只给了延迟分项,没有对话质量分数。
架构:一条链上塞了三段
NGC 的模型卡写得很清楚:音频先用 fast conformer 编码成 token,喂给 Nemotron Nano V2 9B 主干预测文本 token,再交给 TTS 解码器出音频码。另一路独立通道专门预测工具调用脚本。
这和 Haru 的“三流逐元素相加”是两种思路。VoiceChat 是串行三段、共享一个 9B 主干;Haru 是并行三路、压进同一个位置。前者工程上更好拆、更好调,后者延迟更低但耦合更紧。
“首个支持实时工具调用”这个卖点,落地方式很土但很有效:每个工具可以预定义一句“稍等”台词,模型一决定调工具就先说出来,API 在后台跑,用户听到的不是沉默。这一招比任何延迟优化都更能改善体感。
会选工具,不会填参数
工具调用是它最想证明的能力,也是数据最难看的地方。
Full-Duplex-Bench v3 上,工具选择准确率 82.5%,参数准确率只有 44.2%,Pass@1 33%。转换一下:它八成知道该调哪个,但只有四成能把参数填对,三成能真正跑通。
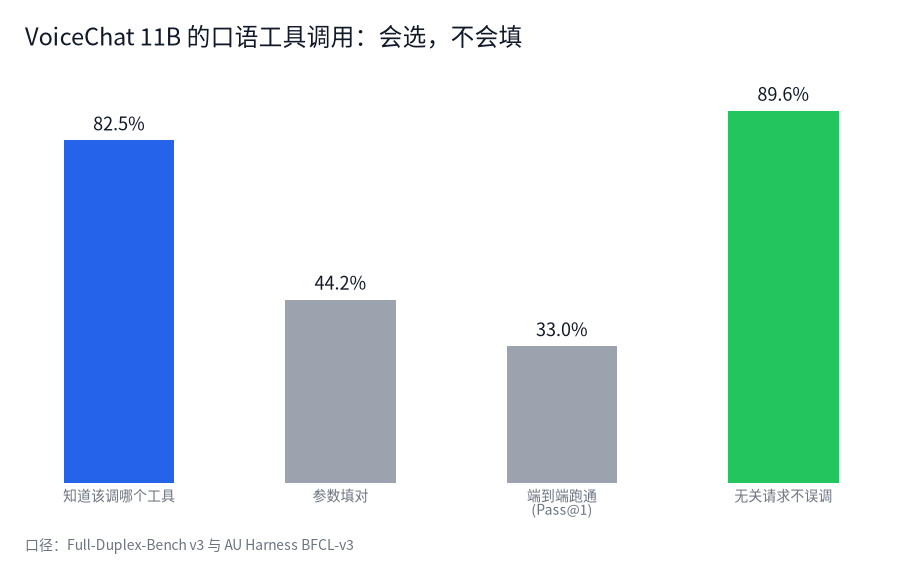
图 2:选择能力与执行能力差了一倍
口语版 BFCL-v3 的分项更能说明问题:简单 58.5%,多工具 62.5%,并行 42.5%,并行多工具 27.5%,平均 56.1%。它不是不会用工具,是“一次只干一件事还行”。而“查订单 + 改地址”这种组合,恰好是客服日常。
# 工具调用三段通过率相乘,看缺口在哪
select, arg, pass1 = 0.825, 0.442, 0.33
print(round(select * arg, 3))   # 0.365:选对且填对
print(round(pass1, 3))          # 0.33:端到端真跑通
print(round(0.365 - 0.33, 3))   # 0.035:参数对了仍失败的部分
80GB 是权重撑出来的吗
不是全给权重。权重按 safetensors 头统计是 11,095M 参数、1,626 个张量、44.38GB——这是 fp32 存法。
params = 11_095  # 百万参数,按 safetensors 头统计
for dtype, width in [("fp32", 4), ("bf16", 2), ("int8", 1)]:
    print(dtype, round(params * 1e6 * width / 1e9, 1), "GB")
转 bf16 是 22.2GB,int8 是 11.1GB。80GB 里权重只占一半,剩下是 KV cache、音频缓冲、TTS 中间张量和框架预留,官方没给拆分。硬压到 24GB 不是不行,但全双工时序敏感,量化抖动会变成“接话变慢”,把 448ms 这唯一优势吃掉。
三个约束,一个判断
三个约束:只有英语,中文要自己微调,且需要带重叠标注的双人对话语料;仅研究用途,没有托管 API,得自己起容器;长对话、多轮、噪声环境、刹不住话,官方都列为短板。
我的判断:这两个模型的价值不在“能用”,在“给出了两条路线”。要低延迟低门槛走 Haru 那条,要可评测可扩展走 VoiceChat 这条。真正的分水岭不是 448 或 198,是谁先把“被打断之后怎么接”这件事测准。目前只有 VoiceChat 交了分数,而且分数不高——这才是这条赛道现在的真实水位。
FAQ
Q:448ms 和 Haru 的 198ms 能直接比吗?
不完全能。198.2 是 65.2 加 133 的算法延迟,偏理论下界;448 是评测集上的平滑轮换延迟,含模型与解码,偏体感。
Q:80GB 显存能降到多少?
权重换 bf16 是 22.2GB,理论上 40GB 卡能塞。但官方没验证过,且全双工对时序抖动敏感,压显存的收益可能被延迟反弹吃掉。
Q:中文能用吗?
不能直接用。模型卡标注英语单语,中文需要重训或至少大幅微调,且要有带重叠标注的双人对话语料。
参考资料
- NVIDIA NGC · NemotronLabs VoiceChat 模型卡(架构、448ms、工具调用能力与研究方向定位)
- MarkTechPost · VoiceChat 11B 发布解读(2026-08-09,TOR 与 BFCL-v3 分项)
- 声网 · 首个开源全双工语音工具调用模型(2026-08-10,工具调用实测表与部署门槛)
- NemotronLabs VoiceChat 11B 权重解析(2026-08-05,11,095M 参数与 44.38GB 的逐张量统计)
核验方式:448ms、480ms、TOR 0.82 / 1.00、停顿 TOR 0.153 / 0.255、工具调用五项分项,取自模型卡与 MarkTechPost、声网的转述;82.5%、44.2%、33%、89.6% 取自 Full-Duplex-Bench v3 与 BFCL-v3 口语版;11,095M、1,626 个张量、44.38GB 取自权重文件头统计;Haru 的 198.2ms 与 12GB 来自站内上一篇。2.3 倍、6.7 倍、22.2GB、11.1GB 与 3.5 个点,是我用上述数字直接算的。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。