
一句话总结:27B 用 Q4 量化后权重 12.6GiB,24GB 卡剩约 9.9GiB 给 KV cache,32K 上下文单路能跑、边界在 40K token,128K 完全放不下;Q8 权重 25.1GiB 直接超卡,没有第二档可选。
阿里 11 月开源 Qwen3.8-27B,官方口径里"24GB 显存可跑"和"编程办公超上一代 Plus"一起出现。前者对,但缺了半个句子:24GB 可跑的是什么上下文、什么并发、什么精度。买卡之前只看"可跑"两个字,装上才发现跑不动自己的场景,这种亏吃过的人不少。
这篇把 27B 在 24GB 卡上的账拆开算:权重占多少、KV cache 怎么涨、上下文开到多长、速度上限在哪。层配置按 27B dense 的典型规模假设(64 层、GQA 8 个 KV 头、head_dim 128),正式部署前以仓库 config.json 为准。
Q4 量化后 12.6GiB:显存怎么分
27B 参数按不同精度折算:BF16 是 50.3GiB,FP8 是 25.1GiB,Q4 是 12.6GiB。24GB 卡上只有 Q4 一档可行,FP8 都装不下,更不用说 BF16 的两张卡。
12.6GiB 权重之外,推理框架本身要吃 1.5GiB 上下(CUDA context、激活缓冲、采样状态都算在内),留给 KV cache 的只有 9.9GiB。这个数字是后面所有讨论的地基。
Q4 的质量代价也得提一句。27B 这个规模对 4bit 量化的耐受度比 7B 好,通常能保住九成以上能力,但代码补全和长文推理这类任务对精度更敏感,自己拿两个 case 对比 Q4 和官方 API 的输出,比看跑分可靠。
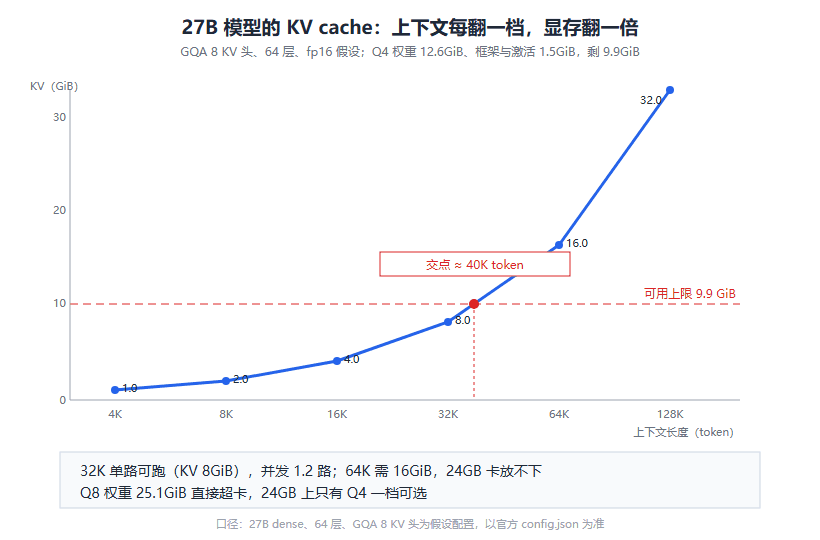
图 1:KV cache 随上下文每翻一档翻倍,与 9.9GiB 可用上限的交点在 40K token 附近
24GB 能开多长上下文:KV cache 的账
KV cache 是那个容易被忽略的变量。它的公式不复杂:2 乘层数乘 KV 头数乘 head_dim 乘序列长度乘每元素字节数。按 64 层、8 个 KV 头、fp16 算,每 1024 token 消耗 0.25GiB。
对到具体档位:4K 上下文 1GiB,8K 是 2GiB,16K 是 4GiB,32K 是 8GiB。32K 那一档还在 9.9GiB 之内,但只剩 1.9GiB 余量,并发是 1.2 路——也就是说 32K 是单路独占的配置。再往上 64K 要 16GiB,直接出局。
交点在 40K 附近。这个数是"24GB 卡跑 27B"的真实边界,比宣传口径里的任何数字都更有用:你的提示词加输出超过 40K,这张卡就不够了。
128K 上下文宣传口径的另一面
模型本身支持长上下文,和你的卡能跑长上下文,是两件事。128K 上下文按同配置要 32GiB KV,24GB 卡连权重带框架才 14GiB,缺口 22GiB。要跑满 128K 得 48GB 显存,两张 24GB 卡做 tensor parallel 或者一张 48GB 的工作卡。
上一篇算 K3.1 Pro 部署时同样的坑更大:1.56TB 权重配 1M 上下文,单个请求的 KV 就要 488GiB。长上下文的显存大头从来不在权重,在 KV。宣传页写的是前者,你付账单的是后者。
应对办法有两个方向。一是 KV 量化,fp16 存 KV 改成 fp8 或 int8,直接省一半到四分之三,40K 边界推到 80K 到 160K,代价是长程检索精度略降;二是滑动窗口注意力这类架构手段,但那要改模型,Qwen3.8-27B 的开源权重不支持你改结构后无损效果。
速度上限:带宽除以权重
decode 阶段每个 token 都要把全部权重从显存过一遍,速度上限就是显存带宽除以权重大小。24GB 档的 4090 带宽 1008GB/s,除以 12.6GiB 权重,理论上限 80 tok/s,按七成实际利用率算是 56 tok/s 左右。
这个速度对单用户的编码助手场景完全够用,人读的速度在每秒 10 到 20 token,56 有富余。但它是单路的上限:32K 上下文占掉 8GiB KV 之后,并发跑第二路,两路的速度都要打折。拿它当个人工具是甜点区,拿它当团队共享推理节点就挤了。
prefill 阶段另算,它吃算力不吃带宽,27B 在 4090 上 prefill 速度通常在每秒几千 token,喂 32K 提示词要十秒上下,等得起。
这个上限也解释了为什么同一张卡跑 7B 能到每秒一百多、跑 27B 就掉到五十几。decode 是纯带宽活,权重大三倍,速度就慢三倍,算力再强也救不回来。想要更快的本地输出,路只有两条:换带宽更高的卡,或者换更小的模型,没有第三条。
什么人该买这张 24GB 卡
账算完了,给判断。如果你的场景是个人编码助手、文档问答,输入很少超过 20K,24GB 卡加 Q4 的 27B 是当下性价比最好的组合之一:一张消费卡的钱,换来一个不上传代码的本地模型。
选型时还应该拿它和两头的模型比一比。往下是 7B 档:8GB 卡就能跑,速度也快一倍,但编程能力肉眼可见地糙;往上是 32B 档:Q4 要 18GiB 权重,24GB 卡装是装得下,KV 只剩三四个 GiB,上下文开不过 12K,实际体验很拧巴。27B 卡在中间,Q4 之后还能留 10GiB 给 KV,是 24GB 卡上能力与上下文的最优平衡点,这个位置不是巧合,是量化曲线和显存曲线刚好在这里交汇。
反过来,三种情况别选。要 64K 以上上下文的,直接看 48GB 或双卡;要多用户并发的,Q4 后剩的显存撑不起第二路,不如直接调 API;要跑 Q8 以上精度的,权重本身超卡,得换 32GB 以上卡型。RTX PRO 6000 那张 96GB 工作卡正处涨价通道,24GB 消费卡是少数没被波及的档位,这也是它性价比的另一半来源。
一句话收束:24GB 跑 27B 是真的,但成立的条件是 Q4、40K 以内、单路。三个条件都对上,这张卡很甜;对不上,加钱或者上云。条件这东西,下单前对一遍,比装完再退省事得多。
FAQ
Q:24GB 卡跑 27B 必须量化吗?
是。BF16 要 50.3GiB,FP8 也要 25.1GiB,都超过 24GB。唯一可行的是 Q4 量化,12.6GiB 权重留出约 10GiB 给 KV cache 和框架。
Q:为什么 32K 上下文只能单路?
32K 的 KV cache 要 8GiB,加上权重和框架开销后只剩 1.9GiB,不够第二个请求的 KV。并发跑两路各 16K 还勉强可以,32K 独占是常态。
Q:KV cache 能压缩吗?
能。fp16 的 KV 改成 fp8 或 int8 存储,显存减半到四分之三,40K 边界能推到 80K 甚至更远,代价是长程检索精度小幅下降。主流推理框架都有现成开关。
Q:Q4 之后的 27B 还能保留多少能力?
27B 规模对 4bit 耐受度较好,常规任务通常保住九成以上,但精细代码补全和长文推理可能更敏感。没有公开的量化后评测分数,建议用自己的任务实测。
Q:速度能到多少 token 每秒?
4090 级带宽 1008GB/s 除以 12.6GiB 权重,理论上限 80 tok/s,实际按七成利用率约 56 tok/s。prefill 吃算力,喂 32K 提示词约十秒。
- FAQ
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。