
一句话总结:higurashi 以 Apache 2.0 开源全双工语音模型 Haru-4B,5.27B 参数,12GB 显存能跑。官方 65.2ms 延迟不含 133ms 分帧等待,全算上 198.2ms,和两年前 Moshi 打平。它真正改的是架构,不是速度。
11 月中旬放出的权重,Apache 2.0,部分组件 MIT,上 Hugging Face 后冲到全品类热门第一。参数 5.27B,BF16 检查点约 10.5GB,底座 Qwen3.5-4B,Apple Silicon 走原生 MLX,服务端是 vLLM-Omni 插件。先说那个被到处转的数字:MacBook 上 65 毫秒。
65.2ms 是在什么条件下测的
条件写得很细:M1 Max、int8 权重、自家 Metal 内核的 Swift 原生应用、有线麦克风和耳机。中位数 65.2 毫秒,正负 1.5。
分项是麦克风进应用 5.3、模型单步 34.2、socket 传输 4.1,合计 43.6 毫秒。65.2 减 43.6 剩 21.6,花在音频编解码上——官方分解表没单列,是我按差值推的。这笔账几分钟就能自己复算:
mics, infer, sock = 5.3, 34.2, 4.1        # 官方分项,M1 Max / int8
frame = 1000 / 7.5                        # 7.5Hz,一帧 133.3ms

seen  = 65.2                              # 官方口径(p50,±1.5)
codec = seen - (mics + infer + sock)      # 21.6:官方未单列,按差值反推
full  = seen + frame                      # 198.5,报道写 198.2 是取整差

print(round(codec, 1), round(full, 1))    # 21.6  198.5
print(int(7.5 * 60 * 10))                 # 4500,十分钟对话的前向次数
print(round((12.5 - 7.5) / 12.5, 2))      # 0.4,对比 Moshi 的步数差
所以它成立的前提是一整套特定配置。换蓝牙耳机或走公网,加减几十毫秒很正常。
漏掉的 133ms,是分帧
模型按 7.5Hz 处理音频:每 133 毫秒收一帧、出一帧。这意味着最坏情况光等凑满一帧,就要多 133 毫秒。
官方博客自己提示了:最大 133 毫秒的算法延迟没算进 65.2。韩国一家媒体补上这一项,得 198.2。加法不是官方做的,算式就是 65.2 + 133。
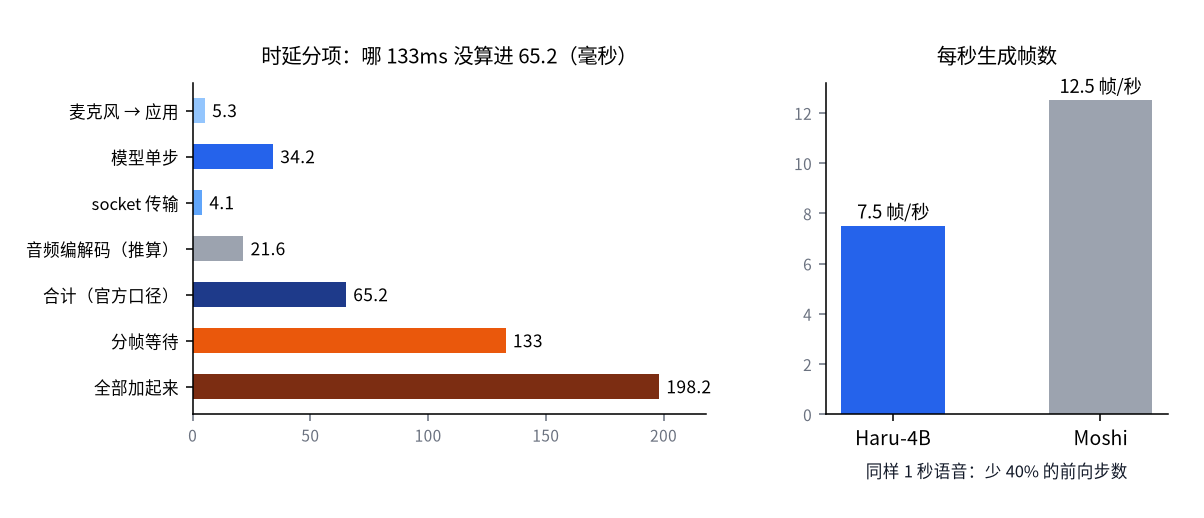
图 1:65.2 是前五项之和,第六项 133 没进官方口径
同一套东西因此有两个数:宣传用 65,排期得用 198。
198ms 和 Moshi 打平,但步数少四成
Moshi 是法国 Kyutai 2024 年开的全双工模型,论文写理论延迟 160 毫秒,实测约 200 毫秒。Haru 的 198.2 落在同一档。
两年过去端到端延迟没动。变的是算力效率:Moshi 每秒生成 12.5 帧,Haru 只生成 7.5 帧,同样一秒语音前向步数少 40%。
代价也直接:帧率低,响应粒度就粗。133 毫秒一格,意味着它判断"你说完没说完"的最小单位是 133 毫秒。人说话的自然停顿常在 200 毫秒上下,勉强够用,谈不上精细。
B300 上一步约 15 毫秒,换硬件能压 20 毫秒;但 133 毫秒的分帧由架构决定,换卡压不掉。
三个流怎么塞进同一个位置
全双工的老做法是两路,用户一路、模型一路。Haru 加到三路,相加而不是拼接,也不是轮流:
# 三流合一(结构示意,非官方源码)
frame = 1000 / 7.5
for chunk in mic.read(frame):                        # 每帧 133ms 用户音频
    u = enc_audio(chunk)                              # 64 维连续 latent
    h = proj_u(u) + proj_a(a_prev) + proj_t(t_prev)   # 三路逐元素相加
    out = model.step(h)                               # 一次前向,32 层
    a_next, t_next = out.audio, out.text
    spk.write(decode(a_next))                         # 同帧就出声
一路是用户这 133 毫秒的音频,一路是模型要输出的音频,一路是模型要输出的文本。三路各自投影后逐元素相加,压进同一个位置,一次前向同时出音频和字。
音频不走离散码本。因果的 VibeVoice 分词器把 24kHz 音频每 3200 采样点压成一个 64 维连续 latent,仍是 7.5Hz;写帧的是 4 层 MLP 头,flow matching 训练、MeanFlow 蒸馏,一步采样。
文本按块和音频对齐。官方说这样能缓解灾难性遗忘——纯音频训练会把语言能力磨掉,得拿文本锚住。
代价在容量:三股流共用一个 32 层、hidden 2560 的底座,每层都要同时编码"在听什么""在说什么""要说什么字"。好处是听与说真并行,坏处是文本能力被摊薄,这也是它只能算基座的原因之一。
推理侧还有一笔隐性成本:每 133 毫秒一次前向,十分钟对话就是 4500 次,KV cache 随对话线性涨。这跟 128K 上下文那笔 KV cache 账是同一个道理。
4000 万小时,合成对话全剔掉
训练数据是这篇最不像"堆参数"的地方:4000 万小时真实语音,覆盖 160 多种语言,约合 4566 年。
关键在剔掉了什么:LLM 生成的对话文本、TTS 生成的语音全部排除。目的很明确——不让模型学"AI 腔",只学真人怎么停顿、插话、笑。
双人对话不够用,他们造了 FastDialogueSidon 生成 1300 万小时分离对话,约 1484 年,底料仍是真人。算力账:256 张 B200,Megatron-LM,约 8 天。九种主要语言是英、西、葡、德、法、中、日、俄、韩。
我的判断是,数据策略比 5.27B 参数更值钱。全双工要学的是"重叠"——两个人同时出声时谁让谁,这东西没法靠调 prompt 得到。
12GB 能跑,但它还不是助手
体量友好:BF16 权重 10.5GB,12GB 卡刚好塞进去,余量不大;转 int8 还能再省,误差和 0.8B 那次量化实测同类。对比才知道多罕见:LongCat-2.5 要 745GiB 显存才起得来。消费级显卡跑全双工语音,此前没有过。
但定位写得很清楚:research release,预训练基座,公开的性能只有延迟,没有对话质量评测。"像人一样插话、会笑"目前只有演示。体验入口倒特别:官方开了两个日本号码,050-5444-3154 男声、050-5444-3155 女声,打过去直接对话。
我把它归到基础设施型发布。全双工真正的门槛从来不是延迟,198 毫秒两年前就有人做到;难的是被打断之后怎么接——接得对不对、会不会抢话、冷场了怎么续。这三件事要靠后训练和评测集,这次一件没给。
图 2:65.2 是露出水面的那一角
所以现在能说的是:底座能跑,延时账算得清,剩下的留给下一版。
FAQ
Q:65ms 是虚标吗?
不算。条件写得很清楚,但它不含最多 133ms 的分帧等待,全算上 198ms。引用时最好两个数一起给。
Q:中文能用吗?
中文在九种主要语言里,训练数据也覆盖。但它是预训练基座,没做中文对话后训练,直接当中文语音助手会不稳。
Q:能替代现在的语音助手吗?
暂时不能。没有工具调用、没有后训练、没有对话质量评测,更适合当研究底座和微调起点。
参考资料
- AI/TLDR · Haru-4B:higurashi 的开源全双工语音模型(参数量、架构、训练数据、延迟分项)
- GIGAZINE · 日语实时对话 AI「Haru-4B」开放模型公开(2026-11-16,电话演示与官方发布)
- 다대구 · 全双工语音 AI Haru-4B,65ms 应答(2026-11-15,加入 133ms 得 198.2ms 与 Moshi 对照)
- Shiritomo · higurashi 公开全双工语音模型 Haru 4B(2026-11-14,Apache 2.0 与体验方式)
核验方式:参数、底座、架构、三流相加、分词器、4000 万小时与 1300 万小时、256 张 B200 训 8 天,取自 AI/TLDR 规格表;延迟分项与 M1 Max 条件同源;133ms 分帧、198.2ms 加法、Moshi 的 160 / 200ms 与 12.5Hz 取自다대구;电话与 Apache 2.0 取自 GIGAZINE 和 Shiritomo。43.6、21.6、4566 年、1484 年、4500 次、40%,都是我用披露数字直接算的。
- FAQ
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。