
一句话总结:Ollama 的模型目录里没有 .gguf 文件,每个文件都以 sha256-<64 位十六进制> 命名;一个 7B 模型对应 1 个 manifest 加 6 个 blob,权重只占其中 4.68GB,剩下 14KB 全是元数据。
本机装了个 qwen2.5:7b,一直想知道它到底把文件存哪了。
ollama list 显示 4.7GB,du 显示 4.36G,两个数不一样,目录里又找不到任何 .gguf。
翻了一遍目录结构,结论是:Ollama 借用的是容器镜像那套存储模型,不是"一个模型一个文件"的直觉。
Ollama 的模型仓库长什么样
四层目录:
~/.ollama/models/
├── blobs/                                   6 个文件,全部无扩展名
├── manifests/registry.ollama.ai/library/qwen2.5/7b    1021 B
├── manifests-v2/ollama.com/                空目录
└── metadata/sha256-2bada8a7...json         4133 B
blobs/ 是实际数据,文件名就是内容哈希。
manifests/ 是按 registry/命名空间/模型名/标签 组织的指针,一个模型一个文件。
manifests-v2/ 是空的,但目录建出来了——说明有个新的 registry 布局正在铺,只是这次安装还没用上。
metadata/ 是按模型 blob 哈希命名的 JSON,存的是 GGUF 头里的键值对。
manifest 是 docker 的格式,不是 Ollama 自己的
打开那个 1021 字节的 manifest,第一行就露了底:
{"schemaVersion":2,
 "mediaType":"application/vnd.docker.distribution.manifest.v2+json",
 "config":{"mediaType":"application/vnd.docker.container.image.v1+json",
           "digest":"sha256:2f15b321...","size":487},
 "layers":[...]}
schemaVersion: 2 加 docker 的 mediaType,这是 OCI/Docker 镜像清单的格式。Ollama 直接拿来用了。
这个借用很聪明。镜像格式自带"分层 + 内容寻址 + 多架构"三件套,正好对上模型文件的需求:权重是一层、模板是一层、license 是一层,改模板不用重下权重。
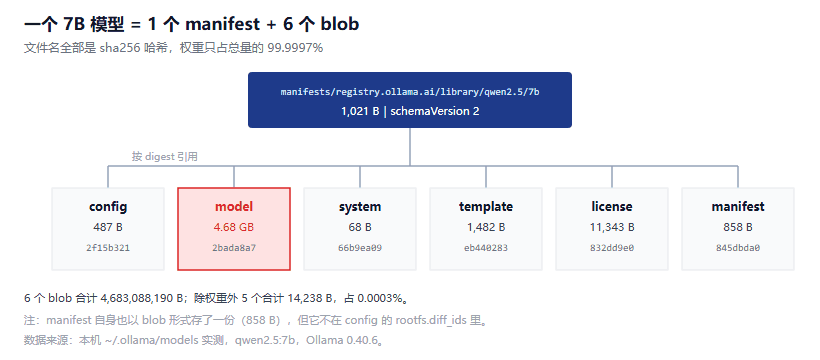
图 1:manifest 按 digest 指向 6 个 blob,其中权重占 4.68GB,其余 5 个合计 14,238 B。数据来源:本机 ~/.ollama/models 实测
每个文件都用内容哈希命名,这是 blobs 的去重规则
6 个 blob 的名字都是 sha256- 加 64 位十六进制,没有扩展名。
| blob | 大小 | 作用 |
|---|---|---|
| 2bada8a7… | 4,683,073,952 B | 权重(GGUF) |
| 2f15b321… | 487 B | config,模型的元信息 |
| 66b9ea09… | 68 B | system prompt |
| eb440283… | 1,482 B | 对话模板 |
| 832dd9e0… | 11,343 B | license |
| 845dbda0… | 858 B | manifest 自身的副本 |
合计 4,683,088,190 B。
内容哈希命名的好处是自动去重:如果两个模型共用同一个模板,模板那一层在磁盘上只有一份。你下 10 个 Qwen 系模型,模板和 license 大概率只占一份空间。
坏处也在这儿——文件名不告诉你它是什么。想找权重,只能按大小猜;想找模板,只能一个个 cat。
Ollama 显示 4.7GB,磁盘上是 4.36G
两个数是同一个文件,单位不同。
4,683,073,952 字节 = 4.36 GiB = 4.68 GB。ollama list 用十进制(GB),du 用二进制(GiB),差 7.4%。
这个差异在模型下载时会让人误判:以为省下了 300MB,其实一分没省。
顺手算一下量化位宽:4,683,073,952 × 8 / 7.6e9 = 4.93 bit/参数。
config 里 file_type 写的是 Q4_K_M。Q4_K_M 标称的约 4.8 bit,实测 4.93,多出来的部分是嵌入层和输出层用了更高精度。
这个方法可以套到任何 GGUF 上:文件大小除以参数量,4.5 到 5.0 之间是 Q4_K_M,5.5 左右是 Q5,8.5 是 Q8。标称和实测对不上,就是标错了。
config 里的 diff_ids 和 blobs 对不上
config 那个 487 字节的文件,内容是这样的:
{"model_format":"gguf","model_family":"qwen2","model_type":"7.6B",
 "file_type":"Q4_K_M","architecture":"amd64","os":"linux",
 "rootfs":{"type":"layers","diff_ids":[
   "sha256:2bada8a7...","sha256:75357d68...",
   "sha256:9bebd78b...","sha256:832dd9e0..."]}}
diff_ids 列了 4 个哈希,但 blobs/ 目录里只有 6 个文件,其中 2 个(75357d68、9bebd78b)在磁盘上不存在。
原因在 docker 的语义里:diff_ids 存的是解压后层的摘要,layers[].digest 存的是压缩包的摘要。Ollama 对 GGUF 不做压缩,所以这两个哈希是同一份内容的两种计算口径——一个算的是"文件字节",一个算的是"层内容"。
这两套哈希不能互相查。拿着 diff_ids 去 blobs/ 里找文件,会以为文件丢了。
metadata 目录是 GGUF 头的缓存
metadata/sha256-<权重blob哈希>.json,4133 字节,三个顶层键:ollama_version、kv、omitted。
kv 里有 31 条,是 GGUF 头的键值对:
general.architecture= qwen2general.file_type= 15(数字编码,15 对应 Q4_K_M)general.size_label= 7Bgeneral.basename= Qwen2.5general.base_model.0.repo_url= huggingface 链接
这些信息本来就在 GGUF 头里。Ollama 单独抽出来存一份,是为了不用读 4.68GB 的文件就能回答"这模型是什么架构、什么量化"。
omitted 这个键有意思——列的是被丢掉的元数据项。大模型动辄几十条 GGUF KV,全存下来占地方,所以只留常用的。
这和我们上一篇解析 safetensors 头部是同一个思路:把"文件里是什么"和"文件多大"分开处理。
坑清单
1. 手动删 manifest,blob 不会跟着删。
ollama rm 会同时清掉 manifest 和不再被引用的 blob。但如果直接 rm 掉 manifests 下的文件,blobs 里的 4.68GB 就成了孤儿——ollama list 看不到它,du 还在算它。
想清干净得自己扫:列出所有 manifest 引用的 digest,和 blobs 目录做差集。
2. 同名不同量化会各占一份权重。
qwen2.5:7b 和 qwen2.5:7b-instruct-q8_0 的模板、license 哈希相同,只占一份;权重哈希不同,各占一份。所以删一个模型省下的空间,通常等于它的权重大小,不是整个目录的百分比。
3. 拷贝模型目录要连 manifests 一起拷。
只拷 blobs/ 过去,Ollama 认不出来——它先读 manifest,再按 digest 找 blob。反过来只拷 manifests,全部报"文件不存在"。
4. 路径里的大小写和空格会出问题。
manifest 路径是 registry.ollama.ai/library/模型名/标签,模型名带斜杠的(比如 library/qwen2.5-coder)会多一层目录。写脚本遍历时按 manifests/**/* 收,别按固定层级拼。
结语
Ollama 这套设计里最值得学的是"借用容器镜像格式"这个决定。
它省掉了一整套版本管理和分发协议,代价是概念上多绕一层:用户以为在管"模型",实际在管"镜像"。
理解了这一层,很多行为就顺了——为什么改个模板不用重下权重(分层)、为什么两个模型能共用空间(内容寻址)、为什么删不干净(引用计数要靠程序维护,不是文件系统的事)。
顺带说一句,manifests-v2 那个空目录说明这套布局还要变。现在写的脚本,明年可能要改。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。