
一句话总结:Catalyst Atomic 发布了一个本地推理服务器,用一个 OpenAI 兼容地址后面挂六个引擎:llama.cpp、vLLM、SGLang、TensorRT、MLX、Prism。它省掉的是「每个引擎一套启动脚本」,代价是「六个引擎能力的交集才是你能用到的」。换引擎不用改客户端代码,但也可能换完发现工具调用不通。
前阵子想在本机跑一个 9B 的模型做代码补全。
先在 Ollama 里试,能跑,但结构化输出(JSON mode)不太稳。换 vLLM,吞吐上来了,但 CUDA 版本对不上(这台机器驱动上限 11.6)。再试 llama.cpp,能跑,但工具调用要自己拼模板。
三个引擎,三套启动命令,三份配置文件。光是把它们各自的参数搞清楚,就花了一个晚上。
看到 Atomic 这个产品的时候,我第一反应就是:这东西解决的是那个晚上。
一、Atomic 解决什么问题:六套启动脚本合成一个
它的做法是:在本机起一个 OpenAI 兼容的服务端口,后端可以选六个引擎里的任意一个。
# 客户端代码完全不用变,只改 base_url
client = OpenAI(base_url="http://localhost:8000/v1", api_key="not-needed")
resp = client.chat.completions.create(
    model="local",
    messages=[{"role": "user", "content": "写个快排"}],
)
想换引擎,改服务端配置就行,Python 代码一个字不动。这个价值是真实的,尤其对那种「同一套 agent 代码要在不同机器上跑」的场景。
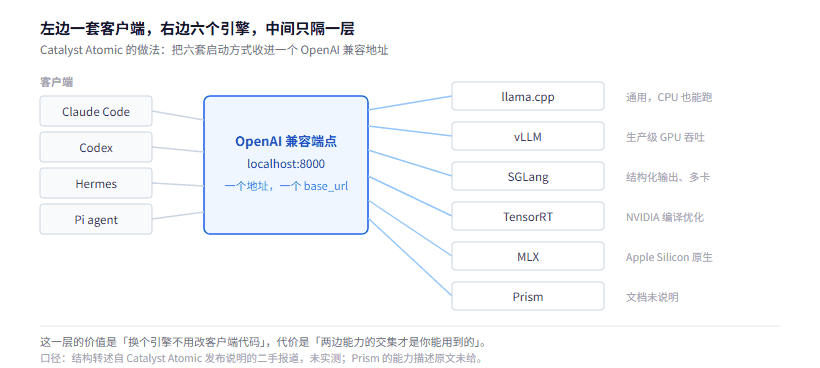
图 1:客户端只认一个地址,后面换哪个引擎它不知道
它还包括这些:
- 一条命令装引擎,按检测到的硬件(GPU / CPU / NPU)自动选
- 从 Hugging Face 拉 GGUF、MLX 或 safetensors 权重
- 支持 Windows、Linux、Apple Silicon、NVIDIA(RTX、Blackwell、DGX Spark)
- AMD Ryzen Halo 标注为「即将支持」
- 附带 stable-diffusion 的图像和视频生成
- CLI 加 Web UI
- 可以通过 Cloudflare 隧道做远程访问
二、六个引擎各自适合什么
这六个不是随便凑的,各自有明确的位置:
| 引擎 | 擅长 | 什么情况下该选它 |
|---|---|---|
| llama.cpp | 通用,CPU 也能跑 | 没有独显、要跑量化 GGUF |
| vLLM | 生产级 GPU 吞吐 | 多并发、要 PagedAttention |
| SGLang | 结构化输出、多卡 | 要严格 JSON、复杂 prompt 编排 |
| TensorRT | NVIDIA 编译优化 | 固定模型、追求极限延迟 |
| MLX | Apple Silicon 原生 | Mac 上跑,不想折腾 |
| Prism | 发布说明没写清楚 | 目前只能存疑 |
前五个我大致能判断适用场景。Prism 这个我查不到它是谁的、干什么的,报道里只列了名字。这种「列了但没说」的情况,我倾向先当成占位。
值得说的是这六个的定位本身有重叠。llama.cpp 和 MLX 在 Mac 上都能跑,vLLM 和 SGLang 在功能上大量交叉。重叠意味着选择困难,而这个工具并没有真正替你解决选择困难,它只是把六个选项摆在同一个菜单里。
三、OpenAI 兼容的边界:能跑通不等于功能齐全
这是我认为最需要注意的地方,报道里也点了出来。
「OpenAI 兼容」不是一个标准,是个事实约定。各家实现覆盖的端点范围不一样:
- 有的只实现了
/v1/chat/completions - 有的加了
/v1/embeddings - 流式(streaming)和工具调用(tool calls)支持程度差异更大
- 更细的字段(
logprobs、response_format的具体类型、finish_reason的取值)各家都不太一样
所以「能连上」和「功能齐全」是两件事。 你把一个依赖 tool calls 的 agent 指向新引擎,可能第一次请求就 400,也可能跑通了但工具调用被静默降级成纯文本。
报道给的建议很实在:切换之前先确认三件事。
- 这个兼容层覆盖了哪些端点——流式?工具调用?还是只有基础对话?
- 自动安装挑的引擎,是不是你想要的那个(它可能按硬件选了默认值,而不是你的首选)
- 你依赖的那些字段,新引擎返回的格式对不对
第三条最容易漏。比如你的代码依赖 usage.prompt_tokens 做成本统计,某个引擎不返回这个字段,你的统计就全是 0,而且不报错。
这类问题我一个都没实测。 手上没有装 Atomic 的环境,也没法在六个引擎上逐个验证端点覆盖。文章里这部分是转述加推断,标存疑。
四、自动选引擎会不会选错
「一条命令装引擎,按检测到的硬件自动匹配」这句话,体验上是加分项,工程上是风险点。
原因很简单:硬件不是选引擎的唯一变量。
举个具体的:一台有 RTX 4090 的机器,按硬件匹配大概率选 vLLM 或 TensorRT。但如果你的用途是「跑一个 4bit 量化的 30B 模型,单用户,偶尔用」,llama.cpp 反而更合适——它不需要预分配显存,模型加载快,量化格式支持最全。
硬件检测能看出「有 GPU」,看不出「你要跑量化模型、单用户、间歇使用」。这些信息只有你知道,工具猜不到。
gpt-oss 那篇算过类似的账:同一个模型的两个尺寸,20b 能在 16GB 内存上跑,120b 要一张 H100。选哪个不是看你有多少显存,是看你要干什么。
所以我建议:第一次装完,先看它选了什么,再决定要不要手动覆盖。别默认它选对了。
五、什么场景值得用
我的判断是分三档。
值得用:多台异构机器跑同一套代码。 你有一台 Mac、一台 Windows + N 卡、一台 Linux 服务器,同一份 agent 代码要在三台都能跑。这时候统一端点的价值最大——不用写三套适配。
值得用:频繁在引擎之间对比。 调参、压测、换量化档位的时候,切引擎不用改代码能省很多时间。27B 量化档位那篇算过 Q4 到 Q8 的显存门槛,那种场景下快速换引擎试效果是刚需。
不太值得:只有一台机器、只跑一个模型。 这时候六个引擎是负担而不是便利——你要多理解一层抽象,还要承担兼容层带来的不确定性。直接用 llama.cpp 或者 Ollama 更省事。
我的经验是,抽象层的价值跟「它下面有几个东西」成正比。 只有一个后端的时候,抽象层是纯成本。
六、常见问题
这个工具是开源的还是商业产品?
报道说「免费、开源」,但没有给出具体的许可类型和仓库地址。想用得放心,先去确认许可。
它和 Ollama 有什么区别?
Ollama 也是一个端点后面接引擎,但基本只接 llama.cpp。Atomic 接六个,覆盖面和复杂度都高一个量级。简单场景用 Ollama 更省心。
能在中国大陆正常用吗?
它要从 Hugging Face 拉权重。这一步在国内网络环境下需要额外处理,报道没提这块。
远程访问安全吗?
它用 Cloudflare 隧道做远程访问。隧道本身是加密的,但把本地推理端口暴露到公网,等于把你的算力开放给任何拿到地址的人。至少加一层 token 鉴权,别裸奔。
这个产品成熟吗?
从报道描述看是新发布,AMD 平台还在「即将支持」。生产环境我建议先观望,个人折腾可以上。
七、结语
这类「统一抽象层」的产品,价值判断有个简单办法:看它省下的是不是你真的在做的事。
如果你确实在三四台机器、五六个引擎之间来回切,那它省的是真时间。如果你只是在自己电脑上跑一个模型,它省的那点配置功夫,还不够你理解兼容层边界花的时间。
抽象层永远要收税的,税就是「你不知道下面发生了什么」。 这层税值不值得交,取决于你在下面待的时间有多长。
我这次的判断是先不装。一台机器一个模型,用不着这一层。等哪天真的要在三台机器上跑同一套东西了,再回来看它。
参考资料
- Tools4All - Atomic Local AI Server ships OpenAI-compatible API across six engines - 本文所有产品细节均转述自此文
- OpenAI API 参考 - 兼容层要覆盖的端点与字段清单,可用于逐项核对
- vLLM 文档 - OpenAI 兼容服务 - 单个引擎侧兼容实现的参考样例
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。