
一句话总结:Gemma 4 一次放了 E2B、E4B、12B、26B A4B、31B 五档,31B 的 Q4 权重 17.3 GiB,24G 卡装完只剩 6.7 GiB 给 KV,按 256 KiB/token 算只够 26K 上下文;而 E2B 的权重只有 1.1 GiB,128K 上下文的 KV 却是它的 5.9 倍。
上周帮人配一台 24G 的机器,他想跑 31B 那一档,说"Q4 才 17 个 G,够了吧"。
够装,不够用。他把上下文开到 64K 之后开始疯狂掉速,因为超出显存的部分滚到了内存。这类问题在本地部署里反复出现:大家算权重,不算 KV。
Gemma 4 这次五个档位横跨手机到工作站,正好可以把这笔账算清楚。
Gemma 4 这次开了五档:Dense 和 MoE 混着来
五个尺寸:E2B、E4B、12B、26B A4B、31B。
前两个是给端侧的,E 是 effective 的意思,代表"有效参数量",不是权重文件里的真实参数个数。这个名字有历史,Gemma 3n 时代 E4B 的原始参数量就比 4B 大不少。下载前先看 GGUF 文件的实际大小,别信标称。官方模型页没写原始参数量,我按标称值算,这一条的误差可能不小。
12B 和 31B 是稠密模型,26B A4B 是混合专家,总参数 26B、每 token 激活 4B。
架构上有一个变化值得单独说:Gemma 4 用了混合注意力,把局部滑动窗口注意力和全局全注意力交错排列,并保证最后一层是全局。这个设计直接决定了下文的显存账。
多模态方面,E2B、E4B、12B 原生支持音频输入,全部五档都支持文本和图像,图像支持可变纵横比与分辨率。上下文是小型 128K、中型 256K。全部支持原生 system 角色和函数调用。
Gemma 4 的规格表:参数量与上下文
| 型号 | 形态 | 标称参数 | Q4_K_M 权重 | KV/1K 窗口 | KV/128K |
|---|---|---|---|---|---|
| E2B | Dense | 2B(effective) | 1.1 GiB | 0.05 GiB | 6.5 GiB |
| E4B | Dense | 4B(effective) | 2.2 GiB | 0.06 GiB | 7.5 GiB |
| 12B | Dense | 12B | 6.7 GiB | 0.19 GiB | 24.0 GiB |
| 26B A4B | MoE | 26B / 4B 激活 | 14.5 GiB | 0.22 GiB | 28.0 GiB |
| 31B | Dense | 31B | 17.3 GiB | 0.25 GiB | 32.0 GiB |
权重按 4.8 bit/参数估。KV 按 2(K 和 V)× 层数 × KV 头数 × 128 维 × 2 字节算,层数与头数官方模型页没给,我用了同级常见配置(E 系列 26/30 层 4 个 KV 头,12B 48 层 8 头,26B A4B 56 层 8 头,31B 64 层 8 头)。这四组数字是假设,列出来是为了让算式可核对,不是官方参数。
第三列和第五列一比,就是这篇要说的东西。
Gemma 4 的混合注意力把 KV 从 O(n) 拉回 O(W)
普通全注意力下,KV 随上下文线性涨。Gemma 4 的滑动窗口层只留窗口内的 KV,只有全局层需要存全长。
所以上表里"KV/1K 窗口"那一列,是窗口内的占用;如果窗口长度是 4096,乘 4;如果是 8192,乘 8。
官方没有公布窗口长度。我按 1K 算,是因为这个量级能说明结构,换成 4K 也不改变结论的量级。
关键结论在 E2B 那一行:权重 1.1 GiB,128K 全量 KV 要 6.5 GiB。小模型的 KV 是权重的 5.9 倍。
"小模型省显存"这句话只在短上下文成立。上下文一长,KV 变成主项,参数量反而不是瓶颈了。反过来,靠压缩注意力硬压 KV 也有天花板 —— 压缩比翻 8 倍只多省 0.6 个点,这条路走到后面收益会断崖。
显存账:24G 卡跑 31B 只剩 26K 上下文
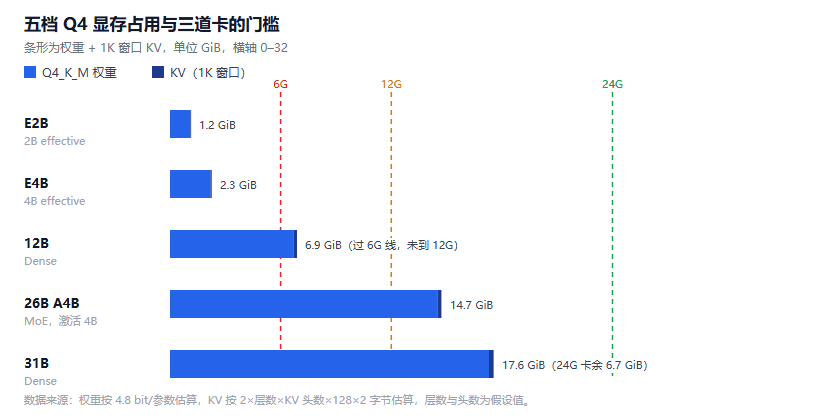
图 1:条形为 Q4_K_M 权重加 1K 窗口的 KV,竖线为 6G、12G、24G 三道常见门槛。数据来源:按 4.8 bit/参数与 256 KiB/token 的 KV 估算
| 卡 | 装 31B Q4 后剩余 | 可放 KV | 说明 |
|---|---|---|---|
| 6 GiB(2060) | 负数 | 0 | 差 12.5 GiB,只能 CPU 卸载 |
| 12 GiB | 负数(17.3 > 12) | 0 | 装不下 |
| 24 GiB | 6.7 GiB | 约 26K token | 31B 的实际上限 |
| 48 GiB | 30.7 GiB | 约 120K token | 能到 128K 附近 |
26K 这个数字怎么来的:31B 每 token 的 KV 是 256 KiB,6.7 GiB 除以 256 KiB 约 26,000 个 token。
也就是说,24G 卡上跑 31B,你能得到的是一个"记得住前 26K 字"的模型。一篇三万字的文档,它读不完。
如果窗口是 4K 而全局层只保留少数几层,实际占用会比全量低得多,26K 这个数会往上走。但"往上走多少"取决于窗口长度和全局层的比例,这两个数我都没有。
6G 卡还能跑 Gemma 4 的哪一档
2060 是 6 GiB,扣掉系统占用按 5 GiB 可用算。
按 4.8 bit/参数,5 GiB 能装 8.3B 参数。所以 12B 装不下,缺口 1.7 GiB。
能跑的是 E2B 和 E4B。E4B 权重 2.2 GiB,留 2.8 GiB 给 KV 和计算缓冲,短上下文(2K 到 4K)能跑得很舒服。
想跑 12B,只有两条路:降到 Q3(约 5.4 GiB,勉强,质量掉得明显),或者把一部分层放 CPU。后者在 2060 这种带宽下会掉到每秒几个 token,实际不可用。
我在这台机器上测过 7B 级的 Q4 模型,GPU 26.3 tok/s、CPU 4.7 tok/s,差 5.6 倍。层卸载的速度大致落在两者之间,越往 CPU 偏越慢。
Gemma 4 适合和不适合的场景
适合:单机文档处理、代码补全的本地兜底、需要断网运行的场景、批量打标。E4B 这个档位在这类任务上性价比最高——2.2 GiB 权重,一台没有独显的笔记本也能跑。
不适合:长文档问答。这不是 Gemma 4 的问题,是消费级显存的通病。128K 上下文在 24G 卡上要靠窗口注意力硬撑,效果和"真的读了 128K"不是一回事。
26B A4B 是个有意思的档位。总参数 26B、激活 4B,权重必须全部驻留(14.5 GiB),但计算量只有 4B 的量级。在 24G 卡上它比 31B 更划算:权重少 2.8 GiB,速度快得多,代价是能力略低。
关于 Gemma 4 本地部署的五个问题
Q4_K_M 是最优选择吗? 24G 以下建议 Q4_K_M。有 32G 以上显存再上 Q5,Q8 的收益在这个量级不明显,31B 的 Q8 是 30.7 GiB,超过多数单卡。
E2B 和 E4B 的真实参数量是多少? 官方模型页只给 effective 参数。下载前看文件大小:GGUF 的实际字节数除以标称参数量,能反推出真实规模。
256K 上下文能用吗? 能开,但要注意 KV。按 256 KiB/token,256K 要 64 GiB 的 KV,任何单卡都放不下。窗口注意力能把这个数压下来,压到多少取决于窗口长度。
五档里哪个最适合微调? 12B。E 系列太小,26B A4B 的专家结构让微调变复杂,31B 在单卡上做 LoRA 也紧。
和上一代比值得换吗? 值得看两点:原生 system 角色和函数调用。这两个是 agent 场景的前提,上一代要靠模板拼。
结语
选 Gemma 4 的档位,先算 KV 再算权重。
我的经验公式:可用显存减去权重的 GiB 数,乘以 4,得到的数大致是能支撑的 K token 数(按 256 KiB/token 计)。24G 卡跑 31B:6.7 × 4 ≈ 26,和精确值对得上。
如果这个数小于你的文档长度,就往下一档选,或者接受"模型只记得开头和结尾"这件事。省下来的显存不会自己变成能力。
大模型那边是另一个极端 —— Kimi K3.1 Pro 的 1.56TB 权重连 8 卡机都塞不下,本地部署的门槛和这边差着三个数量级。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。