
一句话总结:Artificial Analysis 10 月 28 日发布 Intelligence Index v5,把 60% 权重换成私有测试集,编码项里 15% 交给 Cognition 的 FrontierCode 2.0——这个榜单不再问「代码能不能跑通」,而是问「这个仓库的维护者愿不愿意合并你的补丁」;结果 DeepSeek V4.1-Flash 在这个口径下拿到 28%,是所有已发布权重模型里最高的,但综合分仍落后榜首 26 分。
跑分这件事,一直是 AI 行业最不靠谱的信息源。不是因为测不准,是因为题库被训进去了。
一个公开题库只要挂出来三个月,下一批模型的训练数据里就有它。厂商不一定作弊,但数据清洗很难保证没混进去。结果就是分数年年涨,实际能力提升没那么快。
AA 这次改的就是这个环节。这是自 2026 年 1 月 v4 上线以来幅度最大的一次重构,改的不是题目难度,是谁来判分。
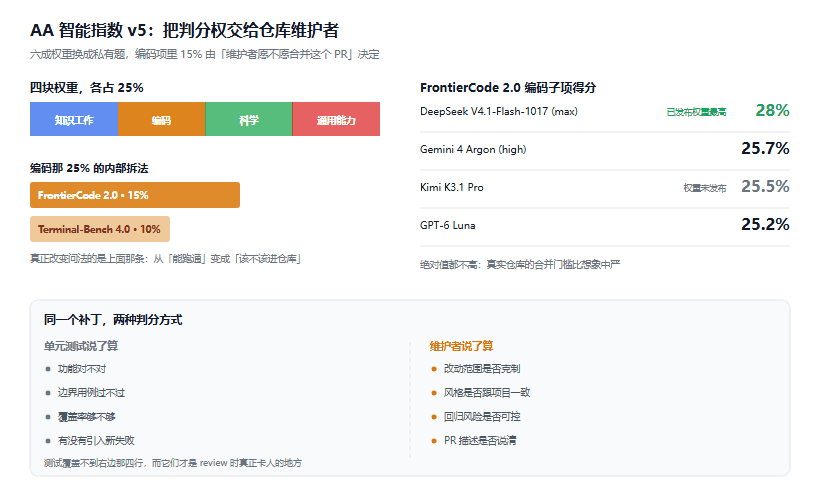
图 1:左为 v5 的四块权重分配,右为 FrontierCode 2.0 上的编码子项得分
v5 改了什么
| 维度 | v4 | v5 |
|---|---|---|
| 私有题占比 | 低,主要依赖公开题库 | 60% 建立在私有测试集或隐藏答案上 |
| 评测构成 | 九项 | 九项,四大类各占 25% |
| 编码项内部 | 常规代码题 | FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10% |
| 判分主体 | 自动化测试 | 编码项部分改由仓库维护者判断 |
四大类权重是平均分的:知识工作 25%、编码 25%、科学 25%、通用能力 25%。
真正的变化在编码那 25%。里面 15% 给了 Cognition 同日发布的 FrontierCode 2.0,10% 给了 Terminal-Bench 4.0。前者是这次重构的核心变量。
FrontierCode 2.0:从「能跑通」到「敢合并」
这套评测的设计值得单独讲,因为它问的是一个以前没人系统量化的问题。
132 项任务,全部来自真实开源仓库。模型提交改动后,不再是单元测试跑一遍给分,而是由该仓库的维护者按「我愿不愿意合并这个 PR」来打分。任何一项阻塞性检查失败,直接记零分。
这个转向的含义比分数重要得多。可运行和可合并之间隔着一堆测试覆盖不到的东西:
改动范围是否克制。 测试只关心功能对不对,不关心你顺手重构了三个无关文件。维护者一眼就看出来。
风格是否跟项目一致。 命名习惯、错误处理方式、日志格式。这些没有测试能查,但 reviewer 每天在挑。
回归风险是否可控。 你改的这行代码,有没有可能是别人依赖的隐含行为?测试过了不代表线上不会炸。
PR 描述是否说清。 这个最虚也最真实:说不清楚为什么改、怎么验证的,维护者就不敢合。
我在实际项目里见过太多次了:AI 生成的补丁测试全绿,但 review 时被打回,理由全是上面这几条。这次终于有人把它做成了指标。
结果:一个罕见的诚实坐标
FrontierCode 2.0 上的得分(编码子项,不是综合分):
| 模型 | 得分 | 备注 |
|---|---|---|
| DeepSeek V4.1-Flash-1017 (max) | 28% | 已发布权重中最高 |
| Gemini 4 Argon (high) | 25.7% | |
| Kimi K3.1 Pro | 25.5% | 权重 11 月 4 日前发布,AA 标为未发布 |
| GPT-6 Luna | 25.2% |
但综合分是另一回事:v5 首发榜首 Claude Opus 5.5 拿到 58 分,DeepSeek 与它差约 26 分。同期发布的 Gemini 4 Carbon 在 v5.0 上以 59 分排第一。
这组数据的价值在于它是个诚实的坐标:一个开源模型在「真实仓库的可合并性」上追到了第一,综合能力却落后 26 分。
这两件事同时成立,说明什么?说明通用能力和科学推理那部分,开源模型还有实实在在的差距,不是榜单噪音。也说明「编程能力」这个笼统的说法该拆开了:在真实仓库里写出维护者愿意接受的代码,和在试卷上解出算法题,是两种能力。
我认为这比「某模型又拿第一」有用得多。
这个方法的三处代价
重构方向对,但代价要说清楚,不然容易把 28% 当成铁一样的事实。
第一,维护者打分引入主观性。 同一个补丁投到不同仓库,得分可能差很多:严格的维护者会挑风格,宽松的会看功能。132 项任务能不能代表全体,取决于选仓库的分布。这是用可复现性换真实性。
第二,60% 私有题意味着你没法自己验证。 公开题的榜单,你可以复现、可以质疑;私有题的榜单,你只能信。AA 的公信力成了唯一的担保。这是必要的取舍,但读者要知道自己在信什么。
第三,任何指标一旦被优化就会被钻空子。 「让维护者愿意合并」这个目标,够聪明的话可以专门训一个「写小补丁、风格保守、描述详细」的策略去刷分,而实际能力没变。这种事在 MMLU 上发生过,在这里同样会发生。
以后看跑分,问三个问题
这份榜单让我把看跑分的习惯固定下来了,三个问题按顺序问:
第一,这是哪个版本的口径? 同一个模型在 v4 和 v5 上分数能差一大截,不同版本不能横向比。看到「某某模型 80 分」先找版本号,找不到就当无效信息。Nanbeige 那篇就是现成例子:官方在 Terminal-Bench 2.1 上报 80.9,第三方在 4.0 上测出 23.8,两套榜差 57 分。
第二,谁跑的? 厂商自测、第三方复测、还是社区众测。厂商自测不是不可信,是要打折,Clover 那篇就是全自测的典型,73.6 这个数至今没有第三方复现。这篇里所有 FrontierCode 数据都来自 AA 一方,属于第三方,但仍要看清是哪个子项。
第三,权重放了吗? Kimi K3.1 Pro 那 25.5% 后面 AA 特意标了「weights not yet released」,这个标注很关键:权重没放出来的模型,能力和部署成本都是未知数,不能和能下载的模型直接比。
三个问题问完,一半的榜单新闻会自动消失。
常见问题
AA 是谁,凭什么当裁判?
Artificial Analysis 是独立评测机构,不做模型、不卖算力,靠订阅和报告活着。它的优势是中立,劣势是私有题库无法被外部审计。
为什么编码占 25% 却拆成 15% + 10%?
因为这两种能力不重合。FrontierCode 测「维护者愿不愿合并」,Terminal-Bench 测「在终端里连续操作完成任务」。一个偏代码质量,一个偏工具使用,分开算比混成一项更准。
28% 是什么概念?
是 132 项任务里通过维护者评审的比例。绝对值不高,说明真实仓库的合并门槛比想象中严;横向比才有意义。
国内模型这次表现怎么评价?
单项领先、综合落后,这个组合是真的。别急着吹也别急着贬,它恰好说明开源模型的能力分布不均匀:工程实现强,通用推理弱。
这类榜单值得追吗?
看你做什么。做选型的话值得看趋势,不值得看小数点。做模型的话,FrontierCode 这套思路比它的分数更有参考价值:给自己建一个「维护者愿不愿合并」的内部标准,比刷公开榜有用。
结语
v5 这次改的不是难度,是问题的问法。从「这段代码能不能跑」改成「这个补丁该不该进仓库」,一句话把评测从实验室拉回了工程现场。
但别把它当终极答案。私有题让你只能信、维护者打分带主观、指标一旦公开就会被优化。它是目前最接近真实工程价值的一把尺子,不是唯一的尺子。
我的建议很具体:下次你评估一个编程模型,别只看 SWE-bench 那个数字,去翻一眼它在 FrontierCode 上的表现。如果两个数字差距很大,说明这个模型擅长考试、不擅长交付。
参考资料
- Artificial Analysis Intelligence Index v5 报告 - 权重构成与私有题说明
- Cognition FrontierCode 2.0 发布 - 132 项真实仓库任务与维护者评审机制
- IT之家报道 - v5 首发榜单与 DeepSeek 单项数据
- 腾讯研究院 AI 速递 - 评测方法论转向的解读
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。