
一句话总结:官方说的 680 tok/s 和你实测的 80 tok/s 往往都没错,只是测的不是同一件事——压测要固定输入长度和输出长度、区分 TTFT 与解码速度、跑多次取分位值,再把吞吐换算成每百万 Token 成本,这三步做完数字才能用来做决策。
上一篇讲怎么把 Clover 跑起来,这一篇讲跑起来之后怎么知道它到底多快。
这件事比看起来重要。你选模型、报预算、决定要不要自建,依据都是这些数字;而官方给的 tok/s 几乎总是偏乐观,不一定是造假,是口径对你没用。
三个指标,别混成一个
大部分人说的「速度」其实是三件不同的事:
TTFT(Time To First Token):从发出请求到收到第一个 token 的时间。对话场景的体感几乎全靠它。1000 token 的回复,用户等 3 秒才看到第一个字,就是卡。
ITL / TPOT(Inter-Token Latency):输出中相邻 token 的间隔。它决定「字往外蹦的速度」。人阅读大概每秒 10 到 20 个 token,超过这个数就感觉是瞬间出完。
吞吐(Throughput):单位时间内所有请求加起来产出的 token 数,单位 tok/s。它只跟成本有关,跟单个用户的体感无关。
一个模型可以吞吐 2000 tok/s 但单请求 TTFT 5 秒,也可以 TTFT 0.2 秒但吞吐只有 300。报数字不带指标名,等于没说。
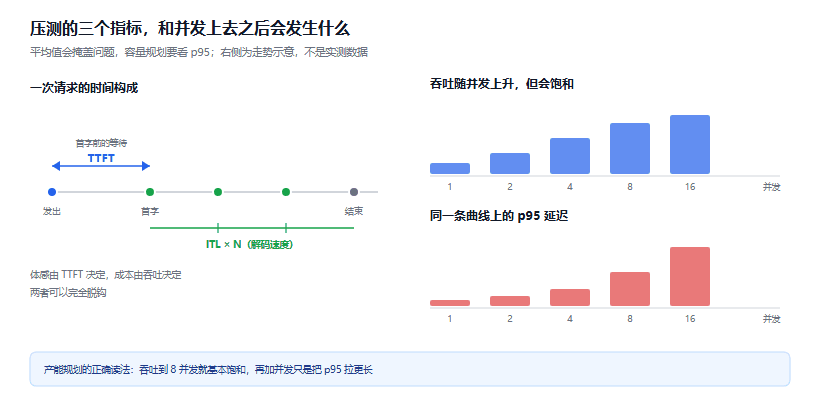
图 1:左边是三个指标在时间轴上的位置,右边是并发上去之后吞吐和延迟的典型走势(示意图)
官方数字为什么不可比
拿 Clover 那组数据举例,官方给了四组:GB300 上 680 tok/s、H200 上 515 tok/s、5070 Ti INT4 上 101.8 tok/s、49 项任务中位 1.52 秒。四个数字都对,但不能互相换算,因为至少有五个变量在变:
| 变量 | 影响 |
|---|---|
| batch size | 官方明说 680 是 batch=1,但服务化时 batch 上去吞吐会翻几倍 |
| 输入长度 | 长输入吃满显存带宽,短输入跑不满 |
| 输出长度 | 短输出被 TTFT 主导,长输出被解码速度主导 |
| 精度 | BF16 和 INT4 差 2 到 3 倍很正常 |
| 硬件 | 同样的卡,PCIe 代际和内存带宽也能差 10% |
所以看到「某某模型 680 tok/s」,第一反应应该是问:batch 多少、输入多长、输出多长、什么精度。 四个说不出来,这个数字就只能当宣传。
工具一:用框架自带的压测脚本
vLLM 和 SGLang 都带 benchmark 工具,最省事。vLLM 的形式大概是这样:
Python -m vllm.entrypoints.OpenAI.API_server \
  --model <你的模型路径> \
  --port 8000 \
  --max-model-len 8192

# 另开一个终端,用官方 benchmark 脚本扫并发
python benchmarks/benchmark_serving.py \
  --backend openai-chat \
  --base-uRL http://127.0.0.1:8000 \
  --model <你的模型路径> \
  --dataset-name random \
  --random-input-len 512 \
  --random-output-len 256 \
  --num-prompts 200 \
  --max-concurrency 16
关键是 --random-input-len 和 --random-output-len 这两个参数。不指定它们,测出来的数字没有意义,因为输入输出长度随机浮动,两次结果没法比。
SGLang 有类似的 bench_serving,参数名不同但思路一样。
工具二:自己写,二十行能测准
框架自带的脚本够用,但有个问题:它测的是「平均延迟」,不给你分位值。而线上出问题的永远是 p95,不是平均值。
自己写一个不复杂。这段用 aiohttp 流式请求,同时拿到 TTFT 和总时长:
# bench.py —— 需要先 pip install aiohttp
import asyncio, json, statistics, time
import aiohttp

URL = "http://127.0.0.1:8000/v1/chat/completions"
PROMPT = "写一个 Python 函数,用滑动窗口求数组的最大值,要求 O(n)。"   # 固定输入
MAX_TOK = 256                                                          # 固定输出上限


async def one_request(session):
    payload = {
        "model": "local",
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": MAX_TOK,
        "stream": True,
    }
    t0 = time.perf_counter()
    ttft, ntok = None, 0

    async with session.post(URL, json=payload) as r:
        r.raise_for_status()
        while True:
            raw = await r.content.readline()
            if not raw:
                break
            line = raw.strip()
            if not line.startswith(b"data:"):
                continue
            data = line[5:].strip()
            if data == b"[DONE]":
                break
            try:
                chunk = json.loads(data)
            except json.JSONDecodeError:
                continue
            delta = chunk["choices"][0]["delta"].get("content")
            if delta:
                if ttft is None:
                    ttft = time.perf_counter() - t0       # 首个内容块
                ntok += 1

    return ttft, time.perf_counter() - t0, ntok


def pct(xs, p):
    xs = sorted(xs)
    if not xs:
        return 0.0
    return xs[min(int(len(xs) * p), len(xs) - 1)]


async def run(concurrency, rounds=4):
    conn = aiohttp.TCPConnector(liMIT=concurrency)
    async with aiohttp.ClientSession(connector=conn) as s:
        await one_request(s)                              # 预热,丢掉
        t0 = time.perf_counter()
        res = await asyncio.gather(*[
            one_request(s) for _ in range(concurrency * rounds)
        ])
        wall = time.perf_counter() - t0

    ttfts = [r[0] for r in res if r[0]]
    totals = [r[1] for r in res]
    toks = sum(r[2] for r in res)
    print(f"并发 {concurrency:>2} | 吞吐 {toks / wall:7.1f} tok/s | "
          f"TTFT p50 {pct(ttfts, .5):.2f}s p95 {pct(ttfts, .95):.2f}s | "
          f"总时长 p50 {pct(totals, .5):.2f}s | 产出 {toks} tok")


if __name__ == "__main__":
    for c in (1, 2, 4, 8, 16):
        asyncio.run(run(c))
四个设计要点,每一个都影响结果可信度:
固定 PROMPT。 输入一变,结果就没法横向比。真实业务里输入长度分布很宽,那就取 p50 和 p95 两种长度各测一遍。
先跑一次丢掉。 第一次请求要加载 kernel、填显存缓存,会明显偏慢。这是预热。
用流式,不等待完整响应。 非流式接口拿不到 TTFT,只能拿到总时长,你就分不清是「首字慢」还是「解码慢」。
取分位不取平均。 平均值会被少数极慢的请求拉高,掩盖真实分布。线上容量规划看 p95。
扩散模型多两个变量
自回归模型的压测只看输入输出长度就行。Clover 这类块扩散模型还有两个参数会直接影响速度,必须固定住:
block_size(默认 32)。 块越大并行度越高,但超过训练时的块大小,质量会掉、速度收益也会衰减。
threshold(默认 0.95)。 这是「质量-速度」的主旋钮。0.95 意味着块内每个位置都要相当确定才填;降到 0.9,去噪轮数减少,速度上升,错误率也上升。
所以测 Clover 时,一组参数要写成 block=32, threshold=0.95 这样,单写一个 tok/s 没有意义。换参数就是换模型。
把吞吐换算成钱
这一步最有用。公式:
每百万 token 成本 = 机器时价 × (3600 ÷ 吞吐 tok/s) ÷ 1e6举两个数:假设租一台 A100 每小时 2 美元,实测吞吐 2000 tok/s。
一小时产出:2000 × 3600 = 720 万 token
成本:2 ÷ 7.2 = 0.278 美元/百万 token
如果实测只有 500 tok/s,同样一台机器:2 ÷ 1.8 = 1.11 美元/百万 token。差 4 倍。
这个数字才有决策价值。拿它跟 API 报价比:API 输入 0.15、输出 0.60 美元每百万 token,而你自建算出 1.11,那就别自建。自建那篇的成本核算用的是同一套算法,可以对照着看。
顺带提醒:这个成本没算上闲置。自建最怕的是半夜没人用,机器照样计费。用「峰值吞吐」算出来的成本会严重低估真实成本,要按平均利用率打折。
五个坑,按命中率排
坑 1:拿厂商数字当基线。 硬件、batch、精度全不同,直接比会得出完全错误的结论。要比较就自己两台机器都跑一遍。
坑 2:只测单请求。 单请求的 tok/s 是延迟指标,不是吞吐指标。做容量规划时看着单请求数字买机器,一定买错。
坑 3:不控输出长度。 输出长度不固定,两次跑的 tok/s 能差一倍,因为短输出被 TTFT 主导。
坑 4:忽略流式与首包。 有些部署方案会先把整个结果算完再一次性返回,TTFT 等于总时长。压测时看 stream 参数有没有真的生效。
坑 5:用一次结果下结论。 GPU 有降频、有热墙,机器忙起来和空载状态差不少。至少跑三轮看波动,波动超过 15% 说明环境有问题,先查再测。
边界与下一步
这套方法测的是「你的部署在你的流量下有多快」,不是「模型有多强」。能力评估是另一件事,得看任务成功率,不能用速度代替。
另外,我上面那段脚本本机没有可用的大模型 endpoint,没有跑过端到端。逻辑是对的(流式解析、预热、分位统计都按标准做法写的),但你第一次跑建议先发 1 个请求确认能正常解析 SSE,再开并发。
下一篇换个方向,把站里逆向那条线串成一张路线图——从 Cheat Engine 找数值到 Ghidra 看伪代码,八个环节该按什么顺序走。
参考资料
- vLLM benchmark_serving 文档 - 参数含义与并发扫描用法
- SGLang 性能测试文档 - bench_serving 参数说明
- Clover 官方发布博客 - 四组速度数据的硬件与精度口径
- NVIDIA 推理性能调优指南 - TTFT 与 ITL 的定义与优化方向
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。