
一句话总结:Micius-Flash 是个 27B 的工程专用模型,原生多模态、256K 上下文,硬件代码基准 64.2%(比同尺寸基线高 15 个点),半导体 agent 基准 62.4%(高 17.2 点)。它最值得看的地方不是分数,是把 EDA 工具和 KiCad 接进去的那个 Harness。
11 月 10 日挂上 arXiv,模型开源。20 多个数据集、约 1.5 万条记录。
27B 的定位:不是通用模型
这个尺寸很微妙。27B 比端侧模型大得多,比旗舰小得多——夹在中间,只能靠"专"取胜。
它专的方向是半导体和硬件。数据管道沿三个学科搭:半导体知识与推理、硬件编码、半导体多模态理解,另外加一个 agent 专家。
原生多模态输入这点值得单独说。很多工程模型是"文本主干 + 视觉适配器",看原理图和看文本走两套路径。原生多模态意味着图、表、代码在同一个表示空间里,这对读数据手册、认引脚图这类任务是刚需。
Micius-Flash 的硬件代码基准 64.2%
| 基准 | Micius-Flash | 同尺寸基线 | 差值 |
|---|---|---|---|
| 硬件代码(20+ 数据集均值) | 64.2% | 49.2% | +15.0 |
| 半导体 agent | 62.4% | 45.2% | +17.2 |
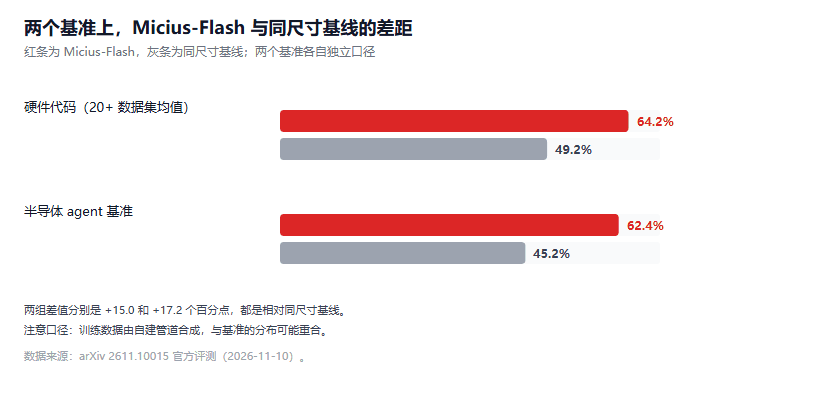
图 1:红条为 Micius-Flash,灰条为同尺寸基线
15 个点的差距,在硬件代码这类任务上算大。Verilog 和普通软件代码的区别在于错了编译不过,或者能编译但时序不对——后者要到综合之后才发现,反馈周期长得多。
不过要看清这套数字的口径:20 多个数据集、约 1.5 万条记录,全部来自自建管道合成的数据。这意味着基准和训练数据的分布可能高度重合。官方没有在第三方公开基准上给分,这是我判断它的能力时最谨慎的一点。
工程模型的数据飞轮:三阶段怎么转
管道分三步:知识树构建与扩展、数据合成、质量验证加难例增强。
第一步是搭知识树——把半导体领域的知识组织成层级结构(从器件物理到工艺到 EDA 工具链)。这一步决定了后面合成数据往哪些方向长。
第二步按树上的节点合成数据。有知识树的好处是覆盖面可控:哪个分支数据不够,往下补就行,不会出现"某个工艺节点的题一条都没有"的情况。
第三步做质量验证,同时把模型做错的难题挑出来,加强到下一轮。这是飞轮真正转起来的地方——不是一次性造数据,是每一轮根据失败样本补数据。
多教师蒸馏:把三个专家合成一个工程模型
训练用的是 MOPD(Multi-Teacher On-Policy Distillation)。三个教师分别管半导体知识、硬件编码、多模态理解,然后向一个学生模型蒸馏。
关键在"On-Policy":用来蒸馏的序列不是教师生成的,是学生自己生成的,再由教师打分。这一步解决的是分布偏移——学生自己会犯的错,教师生成的完美序列里根本不会出现。
蒸馏这件事有个绕不过去的矛盾。三个专家各自在自己的领域强,但合成一个模型时,能力不会简单相加。
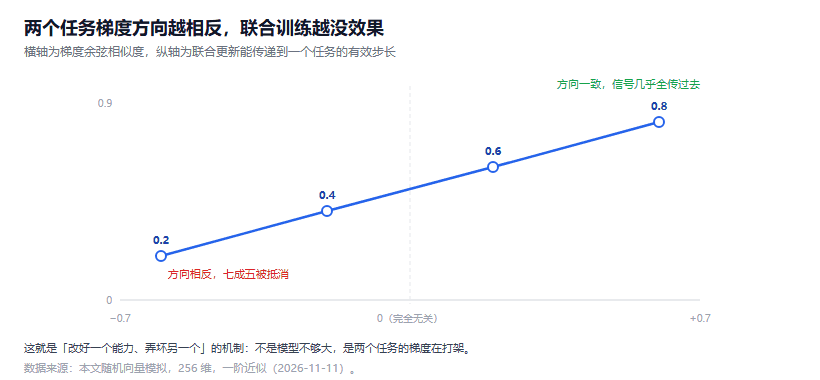
图 2:两个任务梯度夹角的余弦值越低,联合更新能传递的有效信号越少
我用随机向量模拟了一下:两个任务的梯度余弦相似度为 +0.6 时,联合更新对每个任务的有效步长是 0.8;余弦降到 -0.6(方向相反),有效步长只剩 0.2。也就是四个单位的学习信号,三个被互相抵消了。
这解释了为什么少样本微调经常出现"改好一个能力、弄坏另一个"。多教师蒸馏的作用是把不同能力的梯度分开传,而不是让它们在一个损失函数里打架。
接到 EDA 和 KiCad 上
Micius Harness 是这套东西里我最看重的部分。它把模型接到真实工具上:EDA 工具、KiCad、执行环境。
官方给的案例是 PCB 设计、芯片设计流程自动化、软件开发。模型能利用工具的执行反馈做多步规划、代码调试、迭代验证。
这一点比分数重要。工程任务的特点是有客观反馈——DRC 报错就是报错,时序不满足就是不满足。有反馈就能闭环,模型可以自己试错。通用的聊天模型做不到这一点,因为它不知道自己的输出在物理世界里是否成立。
和通用模型比,它差在哪
垂直模型的账要算两面。
强的地方是领域内的任务结构。Verilog 的语法、时序约束的写法、EDA 工具的报错格式,这些东西通用模型要靠上下文现学,27B 的工程模型是训进去的。15 个点的差距主要来自这里。
弱的地方在领域外。同尺寸的通用模型在常识问答、开放域写作、多语言上有更均衡的表现;27B 的容量全押在半导体上,换个领域就明显吃力。这不是缺陷,是取舍。
还有一层要提醒:训练数据大量来自合成。合成数据的好处是覆盖全、成本低,坏处是它反映的是"数据管道以为的世界",不是真实项目的样子。
真实芯片项目的代码长什么样?十几年前的库、没人维护的构建脚本、注释写着"不要动这里"、变量名是拼音缩写。这些东西合成不出来,因为它们不合理。
所以拿到模型之后,先拿自己项目的真实代码试,别看公开基准的分数。基准是本家数据训的、本家管道造的,分数高是应该的。
谁该看这个工程模型
做 EDA 工具链、芯片验证、硬件代码生成的人,值得拿下来试。27B 的体量,单机双卡能跑,比 1.6 万亿参数那种门槛低得多。
只是做通用代码补全的,没必要。它的优势集中在半导体这个垂直领域,离开这个领域,27B 的能力不如同尺寸的通用模型。
这个尺寸本身就尴尬。模型分层那篇算过,中间层正在被两头挤——上面是 70 亿到万亿参数的旗舰,下面是 0.1 美元百万 token 的小模型。27B 要活下来,只能靠垂直领域的数据壁垒。
还有个前提要确认:它的训练数据大量来自合成。如果你的场景是真实项目的遗留代码(风格混乱、注释缺失、依赖几十年前的库),合成数据训出来的模型未必适应。这个风险官方没提,但从数据管道的设计能推出来。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。