
一句话总结:我给 Skill 写了个 lint,扫了本机 83 个,58 个有问题,占七成。反直觉的地方在于分布:引用断链 36 个(43%)、description 没写触发语 33 个(40%),而大家最担心的「正文写太长」只有 5 个(6%)。真正让 Skill 失效的不是臃肿,是断链和不触发。
一、Skill 写多了会烂,但烂在哪
单看一个 Skill,很难出问题。目录对、frontmatter 齐、正文写清楚,就能用。
问题出在数量和时间的乘积上。写到十几个之后,会出现三种情况:改了正文忘了改脚本、引用了后来被删掉的文件、description 当初随手写的一句话到现在也没动过。
这些问题的共同点是不会立刻报错。Skill 加载成功、格式合法、Agent 也读到了,只是在你需要它的时候不触发,或者触发后按着一条死路去走。
所以我做了个 lint。思路和代码检查一样:别靠人记,靠工具扫。
二、三个检查维度
格式层。 frontmatter 能不能解析、name 和 description 在不在、name 和目录名是否一致。这一层是硬性要求,错了加载就会出问题。
匹配层。 description 的长度是否合理、有没有写清楚"什么时候用"。这一层决定 Skill 会不会被触发,最容易被忽略。
内容层。 正文 token 估算是否超标、正文里引用的本地文件是否存在。这一层决定触发之后能不能跑通。
TRIGGER_HINTS = ("当", "时使用", "使用时", "when", "use ", "Use ",
                 "适用于", "用于", "务必", "确保")

def est_tokens(text):
    """粗估:中文按 1.5 字符/token,英文按 4 字符/token"""
    cjk = len(re.findall(r"[\u4e00-\u9fff]", text))
    other = len(re.sub(r"\s", "", text)) - cjk
    return int(cjk / 1.5 + other / 4)
token 估算用的是经验系数,不追求精确,只要能把"三千还是三万"分出来就够用。
三、真实数据
扫的是本机 skills 目录,83 个 Skill。
Skill 总数:83
存在问题:58 个(70%)

按问题类型(同一 Skill 可命中多类):
  引用断链         36 个(43%)
  description 缺触发语 33 个(40%)
  正文超 5k token  5 个(6%)
  格式问题         11 个(13%)

正文 token 中位数:1633
正文 token 最大:14187
只有 SKILL.md、没有任何附件的:41 个(49%)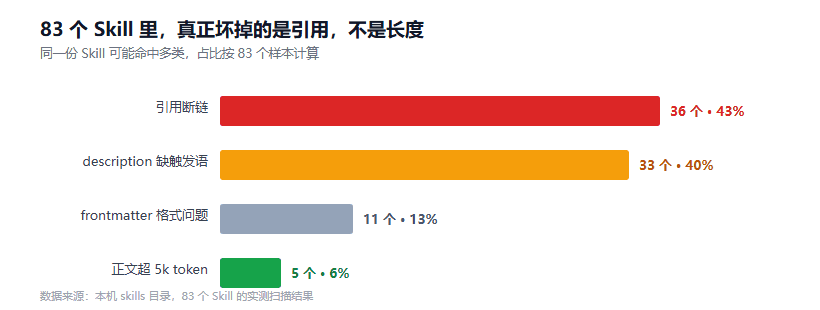
图 1:断链和触发语缺失占了绝大多数,长度反而是小问题
四、三个反直觉的结论
结论一:长度不是主要矛盾。
官方的建议是正文不超过 5,000 token,我原以为会有很多 Skill 超标。实际只有 5 个,占 6%。中位数 1,633 token,相当克制。
这说明写的人大多有分寸感。真正的问题是别的。
结论二:引用断链占 43%,是第二大类的两倍还多。
我抽查了几个:
有个 Skill 的正文写着「详细说明见 wiki/index.md」,但目录里只有 SKILL.md,那个 wiki 目录从来没建过。作者当时可能打算写,后来忘了。
还有个 Skill 有 references/ 目录,里面文件都在,但正文引用时写的是 reverse-engineering/tools-dynamic.md,实际文件名是 tools-dynamic.md,多了个前缀。文件明明在,就是找不到。
这两类加起来,构成了断链的大头。
结论三:一半的 Skill 只用了前两层。
41 个目录里除了 SKILL.md 什么都没有。这意味着第三层——脚本和参考资料——完全没被使用。
关于三层加载的机制,在前面那篇里讲过。只写正文的 Skill 依然能用,但它失去了这个格式最大的优势:把确定性操作交给代码。
五、断链为什么这么常见
我认为有三个原因,都是结构性的。
一是 Skill 是"写一次、改很多次"的东西。 你发现漏了什么就补一句,删了一个文件就顺手 rm,但不会回头去改正文里那句引用。文件系统和文档内容之间没有任何强制关联。
二是路径有两种写法,容易混。 相对 Skills 根目录,还是相对 SKILL.md 所在目录?两种都有人在用,混着写就出错。
三是没有加载时校验。 Skill 加载只看 frontmatter,不管正文里的引用。所以断链永远不会在加载阶段暴露,只会在真正执行到那一步时才发现。
第三条是根本原因。工具不检查,人就会忘。
六、description 缺触发语,问题更隐蔽
40% 的 Skill 在这一项不合格。
description 是 Agent 唯一用来决定"要不要打开这个 Skill"的依据。它启动时只读这两行元数据,别的一概不看。
所以这句话必须回答两个问题:
- 这个 Skill 做什么
- 什么情况下该用它
我扫到的失败案例,大多只答了第一个。比如写「用于处理 PDF 文件」,这句话说得没错,但 Agent 不知道什么时候该想起它。改成「用于处理 PDF 文件。当用户要求提取 PDF 文字、填写表单、合并文档时使用」,匹配率完全不同。
这个问题的隐蔽性在于:Skill 装上了,格式没问题,也不报错。它只是永远不被触发。你以为装了个工具,实际上是装了个没人用的摆设。
七、怎么修
断链。 先跑一遍 lint 拿到清单,然后两件事:文件该有的补上,路径该改的改对。改完再跑一次确认。
日常维护上,我建议加一条纪律:删文件、改文件名的时候,同一个动作里顺手 grep 一遍所有 SKILL.md。 一个 grep -rn "旧文件名" 就能扫完,十秒钟的事。
触发语。 按固定句式重写:做什么。当……时使用。 前半句说能力,后半句列触发场景,触发场景里尽量用用户真会说的词。
超长正文。 5 个案例里,最长的约 14,000 token。处理方式不是删内容,是拆:把"只有特定情况才需要"的部分挪进 references/,正文留一个指针。拆完正文短了,信息一点没少,而且真正需要时还能读到。
八、给团队的五条规矩
如果 Skill 是多人维护的,光靠自觉不管用。
一,description 用固定句式。 前半句能力,后半句触发场景。写不出来的,说明这个 Skill 定位不清。
二,引用只写相对 SKILL.md 的路径。 统一一种写法,别混。
三,正文超过 3,000 token 就拆。 别等到 5,000 才动,留点余量。
四,lint 进 CI。 退出码非 0 就不合并。和代码检查一样对待。
五,每季度扫一次。 Skill 是文档,文档会腐坏。定个体检周期比事后追查便宜。
九、坑清单
写这个 lint 的过程本身踩了两个坑,都挺典型。
1. 把 URL 里的路径当成本地文件。 第一版扫出来断链特别多,仔细看发现 github.com/morluto/rea/blob/main/docs/xxx.md 被当成了本地路径。修法是匹配前先把 https?://\S+ 剥掉。
2. 正则把 package.json 截成 package.js。 我用 \.(md|py|sh|js|json) 匹配,非贪婪地在 .js 就停了。后来干脆去掉 js/json,只匹配 md/py/sh,误报立刻降下来。
3. 备份目录混进统计。 有个 .backup-xxx 目录里也放了 SKILL.md,被算成了一个 Skill。跳过所有 . 开头的目录就好。
4. token 估算是粗估,别当计费依据。 我用的 1.5 字符/token,不同模型、不同分词器能差出一倍。这个数只用来看量级。
十、边界
这个 lint 只能查形式,查不了内容质量。
一个 description 写得句式完美但描述错了能力范围的 Skill,它照样给绿灯。正文里讲的方法是不是最好的做法,它也不知道。
引用的检查也只覆盖 .md、.py、.sh 三类。正文里提到一个 .json 配置或者一张图片找不到,它不报。
这些都得靠人。工具的作用是把机械的部分自动化,让人腾出手看真正难的部分。
结语
这组数据里最有价值的一条,是"七成有问题"这个数字背后的分布。
如果把维护精力按问题占比分配,你应该把一半时间花在修断链上,而不是反复打磨正文措辞。大多数人恰好相反,正文改了七八遍,引用一次没查过。
给个具体动作:现在就扫一遍你自己的 Skill 目录,看断链有几个。数字出来之后,你可能会有和我不一样的结论。
站里另两篇:Skill 是什么、从零写一个能用的 Skill。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。