
一句话总结:腾讯混元开源的 Hy-Nomas 是能"逛"的世界模型,不是只能看的视频模型。主模型和代码 Apache 2.0,ComfyUI 社区节点把门槛压到 12GB 显存,30 系、40 系的中端卡就能跑。但三件事得先看清:一次按键要等 3.5 到 4 秒才出下一段、提示词是结构化剧本不是一句话、解码器权重是 NVIDIA 非商用许可。
一、它和视频模型的区别
先把概念分清,这决定了你会不会用错工具。
视频模型生成的是"一段片子":给一句话,出一段画面,你只能播放、暂停、快进。
世界模型生成的是"一个地方":画面是连续的空间,你可以控制镜头在里面移动、转向,中途还能用一句话改这个世界的规则,比如让天变暗、让路边开出别的花。
打个类比:视频模型给你拍电影,世界模型给你搭片场。
Hy-Nomas 属于后者。它支持 720p,可以连续生成多段,官方放出的是权重、推理代码和训练代码,主模型走 Apache 2.0。
二、能"逛"靠的是两件事
分段自回归。 世界不是一口气生成的,而是切成 2 到 5 秒一段,前一段的输出作为后一段的输入。
世界记忆。 每生成一段,前面所有片段的关键信息都存在 KV 缓存里,新段落生成时全程参考。这就是为什么你走回头路,五段之前路过的那家店还在原地,不会穿帮。
第二条是这套东西成立的关键。没有世界记忆,你每走一步周围环境都会重新长一遍,根本谈不上"空间"。
代价也很直接:它不实时。 记忆越长,每段的生成成本越高。
三、三条路,三个门槛
官方和社区给了三条路径,差别比想象中大。
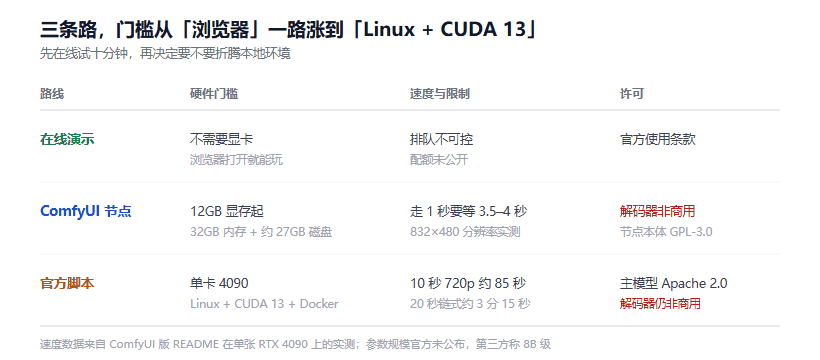
图 1:从零成本试玩到原版脚本,三条路的硬件、系统和许可条件都不一样
第一条,在线试。 官方在线演示和 Hugging Face Space 都免费,10 月 31 日之后还支持上传一张图片来初始化世界。适合先判断"这玩意儿值不值得我装环境"。缺点是排队情况不可控,我这边多次直连 HF 都超时了,没法核实配额。
第二条,ComfyUI。 这条路对普通人最友好,社区节点把显存压到 12GB 起步(大致 3060 12G、4070 这档)。系统内存 32GB 起步,硬盘约 27GB:INT8 主模型 9GB、FP8 解码器 9GB、文本编码器 9GB。
装起来就三步,进 custom_nodes 拉节点仓库,用 hf download 下三个权重文件,把工作流 JSON 拖进 ComfyUI。仓库的 workflows 目录里有现成的:文本起世界、图片起世界、相机控制、以及最好玩的 Drive 模式(运行时按 WASD 直接操控)。
第三条,官方脚本。 想要官方原版体验(多轮交互、自部署 Web Demo、LoRA 微调),得走官方仓库。硬门槛先说清:Linux + CUDA 13.0,官方给的是 Docker 镜像。Windows 用户最顺的路径其实就是第二条。
单卡低显存推理靠四招压下来:INT8 权重和 KV 缓存(计算还是 BF16)、滑动窗口历史(官方单卡预设只保留最近 18 个潜在帧的记忆)、CPU offload(组件轮流上卡,用完回内存)、FP8 解码器。
这四招的代价写在明面上:CPU 和显卡之间来回搬数据,所以系统内存要给足。32GB 是底线不是上限。
四、速度预期,别被演示骗了
数字来自 ComfyUI 版 README 在单张 RTX 4090 上的实测:
| 场景 | 耗时 |
|---|---|
| 10 秒 720p | 约 85 秒 |
| 10 秒 832×480 | 约 34 秒 |
| 20 秒链式世界 | 约 3 分 15 秒 |
| Drive 模式按 W 走 1 秒(832×480) | 等 3.5–4 秒 |
README 明确标了 Drive 模式 "not real time"。
我认为这条最影响使用体验的心理预期。宣传视频里 WASD 逛街看着很流畅,那是加速播放的。真实节奏是:按一下,等四秒,世界往前长一秒。
把它当"世界渲染器"用,心态就对了;当"AI 游戏"用,会失望。
五、提示词不是一句话,是一份剧本
这是新手第一小时最容易翻车的地方,我认为比硬件门槛更劝退。
Hy-Nomas 要的输入是结构化 JSON,不是口语化描述。结构大概是这样:
{
  "perspective_view": "third-person follow",
  "Style": "CG",
  "subject_list": [{
    "display_name": "small orange fox",
    "subject_attribute": "橙色皮毛、白胸脯、蓬松尾巴的小狐狸"
  }],
  "segments": [{
    "start_time": "00:00.000",
    "end_time": "00:05.000",
    "visual_description_long": "石板路穿过一片发光的森林……",
    "contained_actions": [{
      "start_time": "00:00.000",
      "end_time": "00:05.000",
      "action_description": " walks slowly to the left along the stone path."
    }]
  }]
}
几条硬规矩,来自社区 README 的实测建议:
视角只能四选一(第一人称、第二人称、第三人称跟随、第三人称旁观)。风格只能四选一(实拍、动漫、CG、游戏画面)。单个主体,人、动物、载具或群组,不要塞一群人。首段只写场景不写主体,建议 80 到 200 词;后续段落写"变化",用 Compared to the previous segment, ... 开头;没变化就写官方给的固定句式。
还有一条特别容易搞错:相机运动不要写进文本。 官方 Web Demo 和 ComfyUI 节点都支持键盘控制相机,写进文本反而几乎不动。相机交给键盘,文本只管世界本身。
官方在线 demo 内置了提示词增强模型 Nomas-PE,能把大白话转成标准剧本。本地部署没有这层辅助,照格式抄例子最稳。
六、那个许可坑,商用前必看
主模型和代码是 Apache 2.0,这条没问题。
问题在解码器。PixelUMM 解码器的权重是 NVIDIA 的非商用许可,社区项目页写的是 research and evaluation only。
这条对个人玩没影响,对公司做产品是硬约束。你想拿它生成的内容做商业用途,得先把这条查清楚,别等做完了才发现。
这种"主模型开源 + 某个组件非商用"的组合,今年已经出现好几次了。站里那篇开源许可证收紧讲的就是这个趋势,Hy-Nomas 是又一个例子。
七、和另外两个世界模型的差别
放一起看更清楚。
Genie 4 是 Google 的,闭源研究预览,能实时改场景、有原生音频,但只有少数人能碰(那篇解读在这里)。
Qwen-AgentWorld 是语言世界模型,用的是文本和代码表示环境(那篇),目的是给 Agent 训练做模拟器,不是给人看的。
Hy-Nomas 走的是第三条:像素级、可交互、能在消费级显卡上跑、权重公开。它的定位最接近"给个人开发者一个能玩的世界模型"。
FAQ
到底多大参数?
官方没有公布,第三方普遍按 8B 级别理解。我倾向于认为这个数字是蒸馏版主模型的量级,基座可能更大。
12GB 显存真的能跑?
ComfyUI 路线是 12GB 起步,配合 CPU offload 和 INT8 权重。能跑和跑得快是两件事,12GB 卡上建议从 832×480 分辨率开始试。
Windows 能用官方脚本吗?
官方推理环境面向 Linux + CUDA 13.0,给的是 Docker 镜像。Windows 直接跑大概率卡在环境上,走 ComfyUI 更省事。
生成的内容能商用吗?
主模型 Apache 2.0 可以,解码器权重是非商用许可不可以。这个组合意味着实际商用时要把解码器排除在外,或者找替代方案。具体条款建议看权重仓库的 LICENSE 原文。
为什么不实时,以后会吗?
原因是自回归生成,每段都要完整跑一次前向。要实时需要模型本身快一个量级,或者换非自回归的架构。短期看不到。
结语
Hy-Nomas 最有价值的地方不是效果,是它把世界模型这件事从论文和演示视频里拉到了消费级显卡上。12GB 就能跑,这条线一过,参与的人会多一个量级。
但它现在的位置很清楚:能玩,不能当生产工具。不实时、要写剧本、解码器不能商用,这三条限制了它的用途。
给个建议:先用在线 demo 花十分钟试,觉得有意思再装 ComfyUI。别一上来就折腾官方脚本那条路,环境配置能劝退一半人。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。