
一句话总结:抓到一个 WebSocket 连接后,你看到的是一串二进制,不是 HTTP 那种能直接读的文本。这篇起了一个最小服务端抓真实帧,把一帧拆到字节级:2 字节基础头加 4 字节掩码密钥,剩下才是内容。掩码不是加密,但它会让所有直接 grep 的办法失效,这也是协议逆向里最容易卡住的一步。
一、先搞清楚它和 HTTP 的差别
HTTP 抓包能直接看懂,因为报文是文本:GET /api/user HTTP/1.1 一行一行摆在那儿。
WebSocket 只有握手那一下是 HTTP。101 之后,双方走的是二进制帧,一个字节一个字节地传。你抓到的原始数据长这样:
81 8c 11 22 33 44 79 47 5f 28 7e 02 40 21 63 54 56 36看不出任何东西。这 18 个字节里,"hello server" 藏在后面。
想读懂它,得知道帧的格式。这份格式定义在 RFC 6455 里,不长,但有几个细节必须先搞对。
二、前置条件
Python 3.9 以上,标准库。不需要 websocket 库,因为我要拆的就是它封装掉的东西。
我写了个 100 多行的脚本:起一个本地服务端,完成握手,收客户端发来的真实帧,然后按 RFC 拆开打印。
三、握手还是 HTTP
客户端发的第一件事跟普通请求没区别:
GET /chat HTTP/1.1
Host: 127.0.0.1
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Key: MDEyMzQ1Njc4OWFiY2RlZg==
Sec-WebSocket-Version: 13
服务端回 101,带上 Sec-WebSocket-Accept。这个值是把客户端的 Key 拼上一个固定字符串、算 SHA-1、再 base64,用来证明服务端真的懂这个协议,不是随便回了个 101。
GUID = "258EAFA5-E914-47DA-95CA-C5AB0DC85B11"
accept = base64.b64encode(hashlib.sha1((key + GUID).encode()).digest()).decode()
这一步逆向上没什么价值,但如果你要写客户端模拟器,它绕不过去。
四、帧的结构,字节级
101 之后开始走帧。一帧的头部最少 2 个字节。
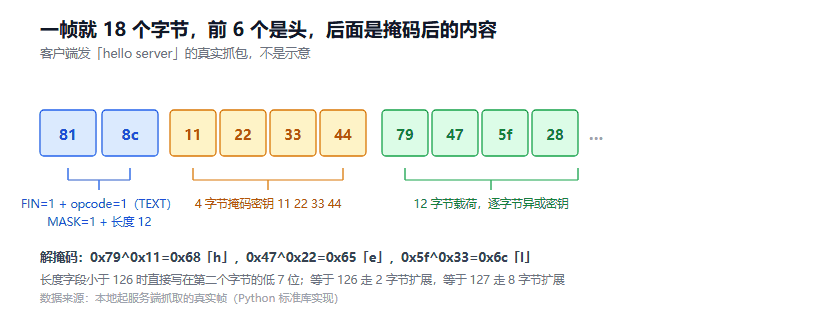
图 1:真实抓到的第一帧,81 8c 开头,后面 4 个字节是掩码密钥
第一个字节拆两半。 最高位是 FIN,表示这是不是消息的收尾帧;接着 3 位 RSV,留给扩展用,默认全 0;低 4 位是 opcode,标类型。常用的几个:0x1 文本、0x2 二进制、0x8 关闭、0x9 ping、0xA pong。
0x81 拆开就是 1000 0001:FIN=1,RSV=000,opcode=1(文本)。
第二个字节也拆两半。 最高位是 MASK,标这个帧有没有加掩码;低 7 位是长度。这个位置是个机关:低 7 位只能表示 0 到 127,超过就得借位。
- 长度小于 126,直接写在这个位置
- 等于 126,后面跟 2 个字节表示真实长度
- 等于 127,后面跟 8 个字节表示真实长度
0x8c 拆开是 1000 1100:MASK=1,长度 12。
掩码密钥 4 个字节。 只在 MASK=1 时存在。客户端发往服务端的帧必须加,反过来不加。
载荷。 剩下的字节,加了掩码的要逐字节异或回去。
五、掩码不是加密,但会挡住所有直觉做法
这段是我认为逆向时最该理解的。
RFC 里写明,掩码的目的不是保密,是防止缓存投毒。中间有代理服务器的时候,攻击者可以构造一段看起来像 HTTP 请求的 WebSocket 载荷,骗代理缓存下来。给每个客户端帧加一个随机的 4 字节掩码,就让载荷没法被预测,这个攻击就不成立了。
所以掩码的强度很低,密钥就 4 个字节而且明文写在帧里。它不是给你防的,是给协议防的。
但对做分析的人来说,它足够挡住三件事:直接字符串搜索找不到内容、肉眼看不出来、按文本假设写的解析器全部失效。
解掩码很简单,循环异或:
if masked and key:
payload = bytes(b ^ key[i % 4] for i, b in enumerate(raw))拿真实数据算一遍:0x79 ^ 0x11 = 0x68,是字符 h;0x47 ^ 0x22 = 0x65,是 e;0x5f ^ 0x33 = 0x6c,是 l。三个字节解出来就是 "hel"。
站里之前写过从乱码里逆出 XOR 密钥,讲的是密钥未知怎么爆破。这里是密钥已知(就在帧里),只是要按位置循环用它。同一个运算,两种场景。
六、实测输出
--- 客户端发来的第一帧(带掩码) ---
原始字节:81 8c 11 22 33 44 79 47 5f 28 7e 02 40 21 63 54 56 36
FIN=1 RSV=0 opcode=0x1 TEXT
MASK=1 key=11223344 长度=12
载荷:hello server
整帧占用 18 字节
12 字节的内容,实际占了 18 字节。头部开销 6 字节,占了三分之一。
这个比例在小消息上很显著。如果你的场景是高频发小消息(心跳、状态同步),协议开销会吃掉相当一部分带宽。这不是缺陷,是设计取舍:换来的是双向、低延迟、无需重复握手。
再对照两种长度:
--- 短文本(长度 < 126) ---
原始字节:81 82 11 22 33 44 7e 49
FIN=1 RSV=0 opcode=0x1 TEXT
MASK=1 key=11223344 长度=2
载荷:ok
整帧占用 8 字节

--- 长文本(走 126 扩展长度) ---
原始字节:81 fe 00 c8 11 22 33 44 69 5a 4b 3c ...
FIN=1 RSV=0 opcode=0x1 TEXT
MASK=1 key=11223344 长度=200
整帧占用 208 字节
长帧那个开头是 81 fe 00 c8:0xfe 的低 7 位是 126,所以走扩展长度,紧接着的 00 c8 就是 200。
七、坑清单
按踩到的概率排。
1. 一个 recv 可能拿到多帧,也可能只有半帧。 TCP 是流,不是消息。我发了两条消息,服务端一次 recv 只拿到第一条,第二条还在缓冲区。解析必须循环处理,还要处理"拆了一半"的情况:把剩余字节留在缓冲区,等下个包拼起来再解。
2. 把 MASK 位当成长度的一部分。 第二个字节的高位和低 7 位是两个字段,直接读整字节会得到 140 这种不可能的长度。
3. 忘了服务端发来的帧没有掩码。 逆向时如果两边都按有掩码解析,服务端返回的内容会全变成乱码。掩码是单向的。
4. 忽略 opcode 直接全当文本解。 ping/pong 帧(0x9/0xA)的载荷可能是空的也可能是任意字节,close 帧(0x8)的前两个字节是状态码。按 UTF-8 硬解会抛异常。
5. 没处理分片。 FIN=0 表示后面还有帧,opcode=0 表示续帧。一条大消息会被拆成多个帧,不拼起来就是断的。
6. 压缩扩展被忽略。 服务端可能协商了 permessage-deflate,这时候载荷是 deflate 压缩过的。解完掩码还得解压,直接看是乱码。
八、边界
这套东西只够读懂明文协议。
如果业务层在帧里又套了一层加密(不少即时通讯产品这么做),解完 WebSocket 帧你还得面对第二层,那就得去客户端里找密钥,工作量上了一个量级。
还有 permessage-deflate 我没在脚本里处理,遇到协商了压缩的连接,需要额外解压一步。
另外,这个脚本是个最小实现,没做完整的握手校验、没处理控制帧、没实现分片重组。它能证明格式,不能直接当生产库用。
站里之前写过协议逆向入门,讲的是 HTTP 接口的签名怎么还原。这篇处理的是另一层:当协议根本不以文本形式出现时,你从哪里开始拆。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。