
一句话总结:Skill 不是把 prompt 存成文件那么简单,它真正的价值在第三层:脚本。这篇从头做一个「文章发布前体检」的 Skill,30 行元数据加正文、100 行检查脚本、一份规则参考。做出来之后跑两个样本验证:故意写坏的那篇五项全抓,干净的那篇通过。中间还撞了一次误判,把词表精度改好了。
一、先说为什么要做这个
我每天发文章,每篇发布前要过一遍检查:禁用词有没有、破折号是不是太密、段落是不是太长、图片路径对不对。
这些事每一件都简单,但每天手动重复一遍,早晚会漏。漏了就得发出去再改,改完还得重新发布。
这正是 Skill 该管的事:一件有固定流程、你重复做过三次以上的事。
判断标准很简单。如果你想不出"这件事我上周做过几次",那还不值得做成 Skill。
二、前置条件
一个能跑 Python 的终端。不需要装任何依赖库。
目录位置看你的 Agent 环境,通常是用户级 skills 目录或者项目级目录。我这次建在项目目录下,验证通过再决定装不装。
整个 Skill 就三个文件,加起来不到 200 行。
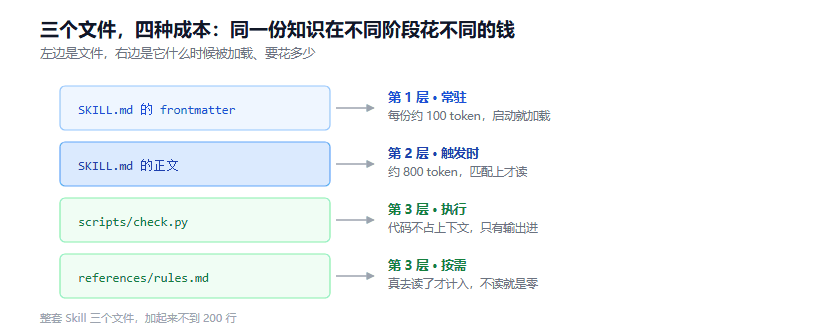
图 1:左边是文件,右边是它什么时候被加载、每次花多少上下文
三、第一步:把触发条件写清楚
这是全篇最重要的一步,也是最容易糊弄的一步。
SKILL.md 开头必须是 frontmatter,name 和 description 两个字段是必需的。
---
name: article-lint
description: 中文技术文章发布前体检。当用户要求检查文章、审稿、发布前自查,或提到禁用词、破折号密度、段落过长、图片缺失等问题时使用。
---
description 是 Agent 唯一的判断依据。启动时它只读这两行,靠这段文字决定要不要打开这个 Skill。
所以它必须同时回答两个问题:做什么,什么时候用。
我改成过三版。第一版写的是"检查文章质量",太笼统,什么文章都能算。第二版写"检查中文文章的禁用词",太窄,用户说"帮我审一下稿"就匹配不上。第三版才把动作和触发词都摆进去。
这一段写不好,后面做得再好也没有机会被调用。
四、第二步:正文只写判断,不写实现
第二层是 SKILL.md 的正文,Agent 触发 Skill 后整段读进上下文。
这里最容易犯的错误是把它写成一个说明书,把每一步怎么做都描述一遍。
我的写法是只写三件事:什么时候用、三步流程、判定标准。具体怎么检查交给脚本,正文不描述算法。
判定标准用表格,因为表格最省 token 也最好读:
| 项目 | 阈值 | 为什么 |
|---|---|---|
| 禁用词 | 0 处 | 套话和空评价,出现即改 |
| 破折号密度 | ≤ 2 处/千字 | 超了读起来喘不上气 |
| 「不是 A 而是 B」 | ≤ 1 处 | 用多了像模板 |
| 单段句数 | ≤ 4 句 | 长了手机上是一堵墙 |
正文我控制在 800 token 左右。官方建议不超过 5,000,但那是上限不是目标,写得越短命中后占的上下文越少。
五、第三步:把确定性的活交给脚本
这一层是 Skill 和"一段长 prompt"的分水岭。
如果正文里写"检查一下有没有禁用词",Agent 每次的判断标准可能不同,同一个词这次算违规下次算放过。写成脚本,结果就是确定的、可复现的、可测试的。
BANNED = ["赋能", "助力", "生态", "闭环", "抓手", "底层逻辑", "护城河",
          "降维打击", "组合拳", "综上所述", "总而言之", "值得注意的是",
          "不难看出", "由此可见", "首先", "其次", "再者", "最后",
          "令人惊叹", "颠覆性", "革命性", "里程碑", "遥遥领先"]

def check_banned(text):
    hits = []
    for i, line in enumerate(lines_of(text), 1):
        if line.strip().startswith("|"):     # 表格里的阈值说明不算正文
            continue
        for w in BANNED:
            if w in line:
                hits.append((i, w))
    return hits
关键的一点在 Skill 的机制里:脚本是执行的,不是读取的。
Agent 用 bash 跑这个脚本,只有标准输出进上下文。脚本本身那 100 行代码,一行都不占。这就是为什么第三层"几乎免费"。
六、第四步:把解释性内容扔进参考文件
词表放脚本里,但"为什么禁这个词、该换成什么"这种解释不能塞进正文,否则正文会膨胀。
扔进 references/rules.md,在正文里写一句"不确定怎么改的时候查那份"。
Agent 只有在需要替换建议时才会去读。不读的时候,它不占任何空间。
七、第五步:装上,然后造两个样本来测
写完了不能只看格式对不对,得真跑。
我造了一个故意写坏的样本:两句话里塞了八个禁用词、三个破折号、两处「不是 A 而是 B」、一个七句的长段、一个指向不存在文件的图片引用。
文章:sample-bad.md
字数:156(去空白)

[FAIL] 禁用词        8 处
        第 3 行:赋能
        第 3 行:生态
        第 3 行:闭环
        第 3 行:护城河
        第 3 行:首先
        第 3 行:其次
        第 3 行:最后
        第 9 行:最后
[FAIL] 破折号        3 处(全文不足 500 字,不判密度)
[FAIL] 不是A而是B    2 处(上限 1)
[FAIL] 段落长度      最长 7 句(上限 4)
[FAIL] 图片          1 个引用,缺 1 个
        找不到:images/not-exist.png

结论:5 项不达标
五项全抓到,退出码 1。这个退出码的意义在于:它能直接挂进发布流程,有问题就卡住。
再跑一个干净样本:
文章:sample-good.md
字数:476(去空白)

[ OK ] 禁用词        0 处
[ OK ] 破折号        0 处(全文不足 500 字,不判密度)
[ OK ] 不是A而是B    0 处
[ OK ] 段落长度      最长 3 句
[ OK ] 图片          1 个引用,全部存在

结论:通过
两边都能出结果,说明它不是"永远报红"或者"永远报绿",判断是真的在工作。
八、一次被自己工具打脸的迭代
第一次跑干净样本,它报了错:
[FAIL] 禁用词        1 处
        第 1 行:最后
第 1 行是标题:「缓存键怎么设计:把变化的部分放到最后」。
这里的「最后」是实义词,指位置。而词表里的「最后」指的是篇章连接词,像「最后,我们总结一下」。
一刀切的字符串匹配区分不了这两种用法,这就是典型的误报。
改法是加语境判断:
LAST_WORD_PATTERN = re.compile(r"最后[,,、是]|最后(我们|说|一点|再|来看)|^最后")

if w == "最后" and not LAST_WORD_PATTERN.search(line):
    continue
改完再跑,坏样本恢复 8 处(「最后是生态」重新被抓住),好样本通过。
这一轮迭代本身就是个教训:凡是靠词表判断的工具,第一版一定有误报,而误报的样板往往来自你自己的文档。
顺带说,这个 Skill 的 SKILL.md 自己跑检查也不通过,因为里面就有那一整张禁用词表。工具检查自己的说明书,必然报红。这不是 bug。
九、坑清单
1. description 太笼统,永远不触发。 「辅助写作」这种描述匹配不上任何具体请求。要写具体动作加具体触发词。
2. 正文写成操作手册,塞进几千字。 触发一次就吃掉几千 token,而那些内容脚本一行就能做完。正文只说"做什么"和"什么算好"。
3. 脚本报错但静默退出。 一定要设退出码,非 0 才算不通过。没有退出码的检查脚本等于没有检查。
4. 相对路径按脚本位置算,不是按执行目录算。 图片检查这块最容易出问题。我在脚本里用 os.path.dirname(os.path.abspath(文件)) 作为基准,而不是当前工作目录。
5. 没测过两种输入。 只测坏样本,你不知道它会不会什么都报红;只测好样本,你不知道它有没有在工作。两边都要跑。
十、边界
这个 Skill 只管表达层面。事实对不对、数据来源标没标、论证有没有漏洞,它一条都管不了。
词表是硬编码的,遇见新的套话要手动加。这类工具永远追不上语言的变化,只能定期维护。
另外它按字符串匹配,遇到"讲解某个禁用词本身"的文章必然误报。我在正文里写了这条,让 Agent 看到时跳过,但那靠的是判断,不是脚本能力。
结语
回到最开始那句:Skill 的价值不在"把 prompt 存成文件",在于它让你能把确定性的部分固化成代码,把判断性的部分留给模型。
一个只有正文的 Skill,本质还是一段长 prompt。加了脚本之后,它才变成一个工具。
想动手的话,别从大的开始。挑一件你每周做三次、每次五分钟、步骤固定的小事,做成第一个 Skill。跑通了再往上加。
站里之前那篇从零写一个 MCP 服务器讲的是给 Agent 接外部能力,和这篇是两个方向:一个给它手,一个给它经验。Skill 本身是什么,在这篇里讲过。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。