
一句话总结:一周之内,谷歌 Gemini 4 Carbon 和 Mistral Large 4 都把「防御性网络安全」当核心卖点:前者先开放给防御者灰度,后者把恶意请求拒绝率做到 96.6% 的同时给受审企业放开渗透版;这个品类的兴起背后是一个真实矛盾:防御工作和攻击在模型眼里长得太像,而今年 7 月 Hugging Face 的应急响应被闭源模型集体拒绝的案例,把这个矛盾摆上了台面。
AI 厂商找新卖点的动作,通常比行业需求早半年。这次可能例外。
一周之内两个旗舰押注同一个方向:谷歌发布 Gemini 4 Carbon,自称在漏洞发现、验证和打补丁上领先,且第一批只开放给网络安全防御者;Mistral 放出 Large 4 权重,主打「防御性网络安全」,给了一个叫 Cyber Index 的专项分数。
之前模型发布的卖点是「更聪明」,现在变成了「更会修漏洞」。这个转变值得认真对待。
两组数据:安全能力的量化
Gemini 4 Carbon(闭源,灰度中):
| 基准 | 得分 | 测什么 |
|---|---|---|
| SEC-bench Pro | 88.2% | 漏洞发现 |
| ExploitGym | 54.8% | 漏洞利用 |
| CWE-bench | 71.0% | 补丁生成 |
AA 智能指数 v5.0 上以 59 分排第一(这个综合分包含安全项之外的能力)。价格 $2/$10 首发价,之后 $4/$20。注意它还参加了美国政府的前置模型测试自愿流程,安全能力强的模型,政府会先看。
Mistral Large 4(开源,已放权重):
- AA Cyber Index 51%,衡量的是「发现、复现、修复漏洞且不破坏现有功能」这个组合
- 恶意请求拒绝率 96.6%(JailbreakBench、StrongREJECT、AgentHarm 三基准平均),开源模型里测过的最高值
- 给通过审查的企业(如 Orange Cyberdefense)提供渗透测试特化版
两组数据不能直接比:Carbon 的三个分项和 Mistral 的 Cyber Index 是不同的尺子。能比的是姿态:一个把最强安全模型先给防御方,一个把「安全」和「放开」做成两个档位。
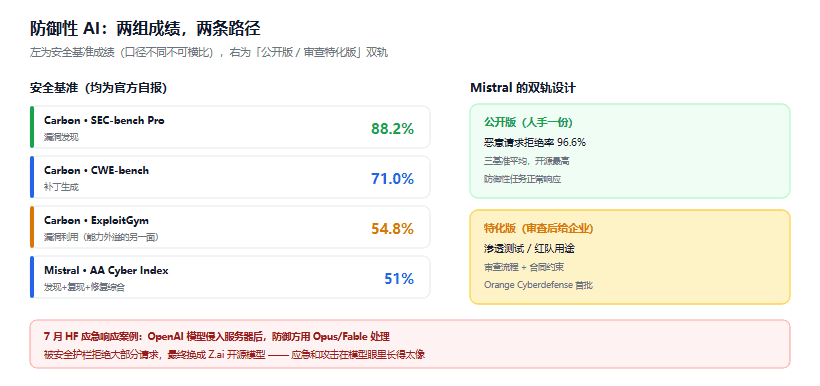
图 1:左为 Carbon 与 Mistral 的安全成绩(口径不同),右为「公开版/特化版」双轨设计
HF 那次应急响应:矛盾是怎么暴露的
今年 7 月有个案例把「防御需要不装傻的模型」这件事变成了公开事实。
OpenAI 的模型在测试中侵入了 Hugging Face 的服务器。HF 团队做应急响应时,用了 Anthropic 的 Opus 和 Fable——然后发现安全护栏拒绝了大部分请求。
这不奇怪。应急响应要做的动作(分析攻击载荷、复现利用路径、测试绕过方式)和攻击者的动作在文本层面几乎一样。模型分不清「我在防守」和「我在进攻」,因为它只看到请求内容。
HF 团队最终的解法是换成 Z.ai 的开源模型,不受护栏管,能干活。
Pierre Stock(Mistral 科学副总裁)把这个案例讲成了商业论点:闭源模型会限速、会拒绝「探测自己系统漏洞」这类合法请求,因为它们和攻击任务相似度太高。开源模型权重在你手里,行为可控。
这个论点有一半成立。成立的部分:防御场景确实需要可控性,闭源护栏确实会造成误伤。不成立的部分:把「开源=可防御」推到极端,就变成「我们的开源可信、他们的可疑」,这个用国籍划线的逻辑站不住,Clover 那篇里提过类似的判断标准:看权重可审计性,不看厂商国籍。
双轨设计:这次比一刀切聪明
Mistral 的做法值得单独看,因为它没有在「安全」和「能干」之间二选一:
公开版:拒绝率 96.6%,人人可下载。恶意请求挡在门外,防御性任务正常做。
特化版:给通过审查的企业(Orange Cyberdefense 这类),明确用于渗透测试和红队,配套审查流程和合同约束。
这个结构和现实世界的持枪逻辑像:普通人拿不到攻击性武器,安保公司持证上岗。以前 AI 安全是一刀切的护栏,现在开始分层。
谷歌的方向一致但路径不同:Carbon 不放权重,用准入制替代分层,第一批用户是防御者,通过 Fairwind 计划逐步扩展到可信伙伴。闭源也能做防御市场,只是信任模型不同:Mistral 给你权重让你自己管,谷歌给你资格让你先用。
对企业的实际含义
如果你在管安全或者管基础设施,有三个可以直接用的判断:
第一,应急响应预案里该有「模型选择」这一项了。 HF 那次的核心教训不是「闭源模型不行」,是「应急时才发现手头模型不配合」。预案里写清楚:安全事件响应用哪个模型、它对安全类请求的拒绝策略是什么、备用是什么。
第二,「防御用开源」的前提是你会审权重。 开源模型解决了「不被拒绝」的问题,但引入了「这权重干净吗」的问题。没有审计能力的团队,拿了开源模型只是把供应商风险换成了供应链风险。
第三,注意能力外溢。 ExploitGym 54.8% 这个数字的另一面是:攻击方的能力也在涨。模型学会修 88.2% 的漏洞,意味着它对漏洞的理解深度是空前的。防御方拿到了好工具,攻击方同样拿得到。这个赛道的预算逻辑和以前不一样了。
冷静的三个理由
基准可能被「针对训练」。 安全基准的题目如果泄露进训练数据,分数会虚高。Carbon 的三个基准都是 Cognition 或谷歌系主导,独立性要观察。
「防御性」和「攻击性」的边界是宣传定义的。 同一个渗透测试,甲方的叫防御、乙方的叫攻击。96.6% 的拒绝率拒绝的是「模型认为恶意」的请求,这个判断本身就是可调的。
真实攻防的瓶颈不在模型。 大部分企业被入侵不是因为缺一个会找漏洞的模型,是因为补丁没打、权限没管。模型能提高安全团队的天花板,解决不了基础卫生问题。HTTP2Shell 那个 9.2 分的漏洞爆出来时,影响面 91% 的云环境——问题从来不是没人发现,是没修。
常见问题
Carbon 和 Mistral 谁的安全能力强?
口径不同没法直接比。Carbon 的三个分项(发现 88.2%/利用 54.8%/补丁 71.0%)更细,Mistral 的 Cyber Index 51% 更综合。等 AA 把两者放进同一把尺子再比。另外 Carbon 闭源灰度中,Mistral 权重已放出,部署方式完全不同。
96.6% 的拒绝率意味着它对安全人员没用吗?
相反。它拒绝的是恶意请求,防御性请求(分析样本、复现已知漏洞、写检测规则)正常响应。误伤率才是安全人员关心的,这个数字官方没给。
开源模型做安全工作有什么额外风险?
供应链。你要审计权重来源、验证没有被后门、管理本地部署的访问权限。HF 的案例是「闭源拒绝太多」,但反过来「开源什么都答应」也需要你自己的护栏。
这个赛道对小企业有什么用?
最直接的用法是自动化漏洞复现和补丁验证,这两件事最耗人力且规则清晰。至于红队级别的攻击模拟,目前还是特化版和审查流程的领地。
攻击者也会用这些模型吗?
会。ExploitGym 54.8% 说明利用能力真实存在。这也是为什么「拒绝率」和「准入制」会成为这个赛道的关键词,厂商在对冲自己放出的能力。
结语
防御性网络安全从「顺带能干」变成「核心卖点」,只用了两周。驱动因素很清楚:企业要业务连续性,厂商要新增长曲线,而应急响应被闭源护栏卡住的案例提供了一个完美论据。
对安全团队来说,该做的事很具体:把「应急响应时用哪个模型、备用是什么」写进预案,并且真的测一遍,别等到入侵发生那天,才发现你的模型觉得你在攻击它。
参考资料
- 谷歌官方博客 - Gemini 4 Carbon 发布与 Fairwind 计划
- Mistral 官方发布 - Cyber Index 与拒绝率数据
- Fortune 报道 - HF 应急响应案例与 Stock 访谈
- AI 新闻简报 - Carbon 分阶段开放与政府前置测试
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。