
一句话总结:Clover-35B-A3B-Preview 是扩散智能 10 月 28 日开源的块扩散语言模型,35B 总参数、3B 激活、Apache 2.0、128K 上下文,用 Qwen3.6-35B-A3B 的权重初始化再做扩散训练,SWE-bench Verified 拿到 73.6,比它的自回归底座高约 8 分;意义不在又多一个开源模型,而在于它证明「换一种生成方式」这条路能在 35B 这档跑通。
过去两年想让模型更快只有两条路:把参数做小,或者把算力堆上去。扩散语言模型提供第三条——不逐 Token 生成,而是整块并行去噪、反复修正。这个方向在论文里存在五年,一直卡在两件事上:规模上不去,上了规模速度优势又保不住。
Clover 用一个现成的自回归底座加架构改造,把两头都占了。但它同时也是一个「增益归因说不清」的模型,这点后面单独讲。
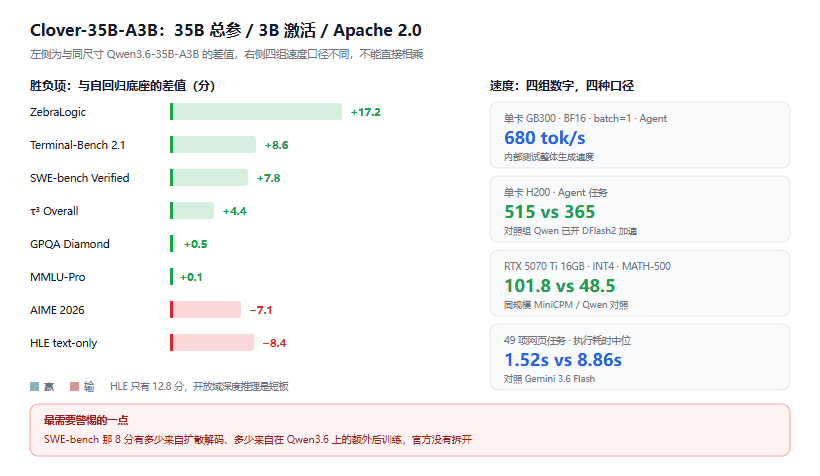
图 1:左为分项胜负(绿赢红输),右为四种硬件配置下的实测速度
规格:一份能让企业放心的参数表
| 项目 | 数值 |
|---|---|
| 架构 | MoE 块扩散,GDN + 全注意力混合骨干 |
| 总参数 / 激活参数 | 35B / 约 3B |
| 专家配置 | 256 个路由专家,每 token 激活 top-8 + 1 个共享专家 |
| 层数 | 40 层 |
| 上下文窗口 | 128K(输入输出合计) |
| 模态 | 纯文本,支持思考模式 enable_thinking |
| 底座 | Qwen3.6-35B-A3B 微调 |
| 许可证 | Apache 2.0 |
| 推理后端 | SGLang(官方推荐)、llama.cpp、Transformers |
| 权重体积 | BF16 约 69GB;INT4 后 16GB 显存可跑 |
Apache 2.0 这条值得单独说。在这之前想自己跑扩散语言模型基本没有可选项:LLaDA 系列开源但尺寸小,Mercury 只给 API 不给权重,Dream 7B 停在 7B。Clover 是第一个「35B 能和真实编程模型对打、又能下载到本地」的开源 dLLM。
生成方式差在哪:不是快,是「整块显影」
自回归是写完第一个字才能算第二个字。扩散是先摆一排占位符,所有位置同时开工,几轮之后整句一起定下来。像洗照片,整张一起显影,不是一格一格涂。
Clover 用块扩散,默认块大小 32 token。解码逻辑值得看清楚,因为它决定了这套东西的实际行为:
- 当前块从全掩码开始
- 置信度超过阈值(默认 0.95)的位置并行填上
- 一个位置都不达标时,把置信度最高的那个先填了,保证块永远有进展
- 填完的块并入前缀,开始下一块
这个「低置信度也要填一个」的设计很关键。扩散解码最怕死循环:模型在一整块上反复不确定,永远推不下去。用强制推进换确定性,是很工程化的取舍。
放到 Agent 场景里,这套机制的收益会被放大。Agent 是一轮一轮跑的,想一步、做一步、看结果、再想,每轮延迟都会叠加到整条链路上,这个循环怎么写成代码我另写过一篇。单轮延迟减半,十轮下来整条链路也减半。
架构改了什么:给自回归模型换骨骼
Clover 不是从零训的,它用 Qwen3.6-35B-A3B 的权重初始化,再套上块级扩散的训练目标。团队之前做过 DiffuLLaMA,专门研究「怎么把训好的自回归模型转成扩散模型」,Clover 是这条线推到 35B 的结果。模型卡里明确给 Qwen 做了上游致谢。
底座的门控 Delta 网络(GDN)本来是为因果生成设计的,只往回看。要让一个块里的 token 在半成品状态下互相看见,得动结构。四处改造:
双向化 GDN。 已生成的历史通过递归状态压成长程记忆,不随长度线性膨胀;当前块内用双向 Softmax 注意力做细粒度交互,前缀仍保持因果。
记忆读出独立成路。 这是我认为最巧的一处。历史记忆没有硬塞进注意力,而是把它的读出做成一个独立信息单元,跟块内 token 放进同一次 Softmax 里一起竞争。什么时候该依赖历史、什么时候该看当前块,交给模型自己学,而不是人为设权重。
可学习的块大小校准。 块越大越并行,但块内 token 一多,历史的分量会被稀释,所以加一个可学习项专门补偿这种稀释。
零初始化右卷积分支。 预训练时学的是因果卷积,只朝一个方向看。给右侧单独开一条零初始化分支,让模型从原有行为出发逐步学会用右侧信息,不从零开始学,收敛更稳。
一句话概括:长历史用紧凑状态存,当前块保留细粒度交互。 任何想做并行生成的团队都会撞上同一个问题,这套解法值得抄。
速度:四个数字,四种口径,别混着用
这部分最容易被误读,因为官方给了四组数字,硬件和精度都不一样:
| 场景 | Clover | 对照组 |
|---|---|---|
| 单卡 GB300,BF16,batch=1,Agent 场景 | 680 tok/s | — |
| 单卡 H200,Agent 任务 | 515 tok/s | 365 tok/s(Qwen 开 DFlash2) |
| RTX 5070 Ti 16GB,INT4,MATH-500 | 101.8 tok/s | 48.5 tok/s(同规模 MiniCPM/Qwen) |
| 49 项 WebMCP 任务,执行耗时中位 | 1.52 秒 | 8.86 秒(Gemini 3.6 Flash) |
第二行最能说明问题。对照组不是裸跑,是已经开了投机解码加速的 Qwen,同一张 H200 上 365 tok/s,Clover 515。差距是在对方也用上加速之后拉开的,这个对比比 680 那个数字有意义得多。
第三行是端侧玩家最该看的一行。16GB 显存的 5070 Ti 加 INT4 量化就能吃满,101.8 对 48.5,两倍多。这意味着扩散模型不是只能跑在数据中心。
第四行换成端到端耗时后,倍数从 2 倍跳到 5.8 倍。原因不难想:Agent 任务的耗时不止生成,还有工具调用、页面加载、重试。生成快省下来的是「思考时间」,而在一堆外部 I/O 里,思考时间恰恰是最容易漏算的那部分。
我对这些数字的判断:速度优势是真的,倍数要按任务折算。 扩散的收益高度依赖输出被约束的程度——结构化提取、代码改写、格式生成收益大;写故事、开放对话需要更多去噪步数,优势会被吃掉。团队自己的技术博客也承认这一点。
三个官方实测,比跑分更能说明范式差别
跑分是抽象的,这三个案例能看出「并行生成」到底解决什么问题:
找最近的 Wendy's。 从 CMU 出发查最近的店开车多久。坑在于地图站搜索不带位置信号,直接搜店名会跳到缅因州。Clover 识别出结果偏了,逐步加城市、街区、邮编重查,页面卡住后两次重置重填,28 步 169.9 秒找到 2.0 公里外那家。Qwen3.6 Flash 用满 30 步、578.3 秒,停在一个 347 公里外的门店,任务判负。
建私有项目拉人。 一条指令要连续完成创建项目、设可见性、找成员、发邀请。Clover 13 步 169.9 秒,Qwen3.6 Flash 21 步 392.3 秒。
无人机调度报文。 一份复合报文同时含禁飞区解除、航点修改、任务分配、半径调整、紧急调度五项。Clover 0.97 秒五项结果同时给出且全对;Qwen 3.78 秒,还把 UAV5 的测绘任务解析成了医疗任务。
把 49 项网页任务汇总成一张表,差距看得更清楚(Clover 之外的数据来自官方复测):
| 配置 | 综合得分 | 尝试成功率 | 中位执行时间 |
|---|---|---|---|
| Clover-35B-A3B(单独运行) | 98.4 | 98.6% | 1.52 秒 |
| Jev + Mercury 2.5 | 92.2 | 95.9% | 3.21 秒 |
| GPT-5.6 Luna | 88.1 | 99.3% | 5.74 秒 |
| Gemini 3.6 Flash(官方数据) | 85.1 | 100% | 7.22 秒 |
| Gemini 3.6 Flash(服务器复测) | 82.5 | 97.3% | 8.86 秒 |
第三个案例最说明问题:五项任务本来就互不依赖,自回归只能一项一项排队吐,扩散可以一次全给。 这不是速度快慢,是任务结构和生成结构对上了。
它其实输了哪些项
发布稿不会强调,但官方对照表里都写着:
| 评测 | Clover | Qwen3.5 AR | 差值 |
|---|---|---|---|
| AIME 2026 (avg@8) | 83.3 | 90.4 | -7.1 |
| HLE text-only | 12.8 | 21.2 | -8.4 |
| MATH-500 | 96.2 | 96.2 | 持平 |
| GPQA Diamond | 83.8 | 83.3 | +0.5 |
| MMLU-Pro | 84.8 | 84.7 | 持平 |
| ZebraLogic | 95.8 | 78.6 | +17.2 |
数学和硬知识都输了。AIME 差 7 分,HLE 只有 12.8 分(两个 Qwen 都在 21 上下),说明它在开放域的深度推理上还没跟上。反过来 ZebraLogic 这种纯逻辑约束题高了 17 分,很符合「在约束下填满结构」的强项。
我的判断是这不是实现问题,是范式的固有代价。扩散擅长「在约束下填满一个结构」,不擅长「在没有约束时探索一个答案」。选型按这个特性对号入座就行,不用指望它全面替代。
最该警惕的一点:增益到底来自哪
这是我认为整件事里最需要冷静的地方。
Clover 是在 Qwen3.6-35B-A3B 上改的,团队做了扩散训练,但很可能也做了额外的后训练。SWE-bench 从 65.8 涨到 73.6 这 8 分,有多少来自「扩散解码」这个机制本身,有多少来自「在 Qwen3.6 之上又训了一轮」?
官方没有拆开。 社区已经在问这个问题,发布材料里没有答案。
这个区别很重要。如果是前者,说明扩散范式真的有红利,所有人都该跟进;如果是后者,那它只是一个「在 Qwen 上多训了一轮、顺便换了生成方式」的模型,别人拿 Qwen 多训一轮也能涨。两种情况的产业含义完全不同。
加上所有评测都是官方自报、第三方复现还没跟上,我的建议是把它当「方向信号」,不是「选型结论」。
想上手:三个工程细节先知道
优先用 SGLang,别用 Transformers 做评测。 官方明确说了,Transformers 实现和 SGLang 内核之间有小的数值差异,同参数会生成不同文本。跑评测的人不注意这点,结论会漂。
防复读是内置的,别关。 默认 presence_penalty 0.9、repetition_penalty 1.05,还有从 8192 token 开始渐强收尾的长度惩罚。超长生成容易变复读机是扩散模型的已知问题,这些默认值已经调好了。
块内专家收敛默认开着。 moe_block_coreset 默认 top_p 0.9,去噪时每个块收敛到覆盖 90% 聚合路由质量的专家子集,减少块内专家跳动。调低能省算力,但有质量代价。
最小可跑代码:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "DiffuSpace/Clover-35B-A3B-Preview"
tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id, trust_remote_code=True,
    dtype=torch.bfloat16, device_map="cuda:0",
).eval()

messages = [{"role": "user", "content": "解释一下块扩散"}]
prompt = tok.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True,
    enable_thinking=True,
)
inputs = tok(prompt, add_special_tokens=False, return_tensors="pt").to("cuda:0")
out = model.generate(**inputs, max_new_tokens=4096,
                     block_size=32, threshold=0.95, do_sample=False)
print(tok.decode(out[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True))
环境要求 Transformers 5.19.0 以上、PyTorch 2.10 以上。llama.cpp 那边支持自推测解码,但后端代码还没进仓库,想用本地部署得等。
配套的决策模型:一个更实用的副产品
同一天团队预告了基于 Clover 的决策模型,还没放权重。思路值得抄:同一份材料下的多个问题放进同一次去噪里并行生成,每次最多 8 个。
在 500 组、2420 道关联题上的内部验证:联合模式单题正确率 95.0%、整组全对率 80.4%;同一模型独立作答是 89.8% 和 62.4%;对照的 TypeSafe Jev 是 63.6% 和 15.8%。
差距主要出在整组全对率上。关联判断最怕前后打架:审一份合同,「通知是否及时」和「保证金是否应保留」有规则依赖,分开问两次模型可能给出互相矛盾的答案。如果你有一批互相有约束的判断要模型做,别拆成多次调用,这条经验现在就能用,不用等模型发布。
常见问题
能替代 Qwen 或 GPT 吗?
现在不能。Agent 编程和工具调用上确实强,数学、硬知识、开放域对话有明确差距。现实用法是在 Agent 流水线里替换那个高频、结构化、对延迟敏感的工具调用环节。
680 tok/s 是单条请求的延迟吗?
不是。680 是 GB300 上 BF16、batch=1、内部 Agent 数据的生成速度。单条请求的体感要看 TTFT 和去噪步数,自己压测才作数。
本地跑得动吗?
BF16 要 69GB 显存,得单张 90GB 卡。消费级走 INT4:约 16GB 显存,5070 Ti 这档能跑到 101.8 tok/s。别只算权重,递归状态和块缓存也要留余量,显存账怎么估可以照那篇的方法套。
用 Qwen 的权重初始化算抄吗?
不算。DiffuLLaMA 那篇论文专门研究这个路径,是公开做法。模型卡里也明确致谢了上游。关键是后续的扩散训练和结构改造属于新工作。
扩散会取代自回归吗?
我不信。更可能的格局是分流:结构化、低延迟、批量任务走扩散,开放推理和长程规划还是自回归。历史上没有哪种生成范式全面替代另一种。
结语
Clover 的价值不在 73.6 这个分数,在于它把扩散语言模型从「论文里跑得快」推进到了「能下载、能服务、能干活」。35B 这个尺寸选得也准,正是自托管 Agent 的甜点区,和 Qwen、MiniCPM、Gemma 4 撞在同一个配置上,对比终于能同台。
但 Preview、全自测、增益归因不清,这三条都得记着。我的建议就一句:拿你自己最高频的那个 Agent 任务,用同一套提示词和工具,Clover 跟现在的模型各跑 20 次,比耗时也比成功率。 速度这件事,只有在自己的账本上才看得见。
参考资料
- 扩散智能官方发布博客 - 架构说明、四组速度数据与三个实测案例
- Hugging Face 模型页 - 权重、模型卡与解码参数默认值
- GitHub 仓库 - SGLang 实现与 llama.cpp 移植
- InfoQ 报道 - 双向 GDN 改造与评测口径说明
- 智东西报道 - 六项 Agent 评测与决策模型联合模式数据
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。