
一句话总结:Agent 在 demo 里能跑,上线后每天都会有人问「刚才那单为什么失败」——要回答这个问题,得在写业务逻辑之前就把三样东西埋进去:结构化的工具调用日志、按任务记账的 Token 消耗、以及能把失败归到四类原因上的分类标记。
最小 Agent 循环那篇写的是「怎么让 Agent 跑起来」。这篇写「跑起来之后怎么办」,这部分才决定它能不能真的用。
我见过的 Agent 项目,死在能力上的少,死在排查不动的多。任务失败了,日志里只有一句 Exception: timeout,你不知道是模型选错了工具、参数给错了,还是那个 API 真挂了。于是只能复现,而复现往往跑不出来。
三样东西,越早埋越好
| 要埋的 | 解决什么问题 | 埋的成本 |
|---|---|---|
| 工具调用日志 | 每一步做了什么、耗时多少、成功没 | 一个装饰器,20 行 |
| token 账 | 一次任务花了多少钱、花在哪个环节 | 在 LLM 调用处记一行 |
| 失败归因标记 | 失败是模型的问题还是环境的问题 | 一个分类函数 |
三样里最容易被跳过的是第三样,也恰恰是最有用的。前两样是「记录」,第三样是「判断」。
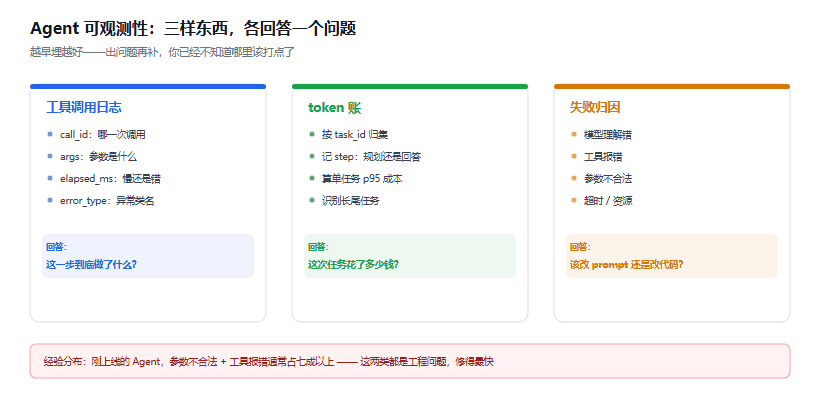
图 1:一条请求链路上,三个维度各自记录什么、回答什么问题
工具调用日志:一个装饰器就够
不要等到出问题再补日志,那时候你已经不知道哪里该打点了。给每个工具函数套一层:
# trace.py
import functools, json, time, uuid
from datetime import datetime, timezone

def traCED(tool_name: str, log_path: str = "agent_trace.jsonl"):
    """给工具函数加调用日志,成功失败都记,异常照常抛出"""
    def deco(fn):
        @functools.wraps(fn)
        def wrapper(*args, **kwargs):
            call_id = uuid.uuid4().hex[:8]
            t0 = time.perf_counter()
            rec = {
                "ts": datetime.now(timezone.utc).isoformat(timespec="milliseconds"),
                "call_id": call_id,
                "tool": tool_name,
                "args": kwargs if kwargs else {"_positional": list(args)},
            }
            try:
                out = fn(*args, **kwargs)
                rec["status"] = "ok"
                rec["result_chars"] = len(str(out))
                return out
            except Exception as e:
                rec["status"] = "error"
                rec["error_type"] = type(e).__name__
                rec["error_msg"] = str(e)[:300]
                raise
            finally:
                rec["elapsed_ms"] = round((time.perf_counter() - t0) * 1000, 1)
                with open(log_path, "a", encoding="utf-8") as f:
                    f.write(json.dumps(rec, ensure_ascii=False) + "\n")
        return wrapper
    return deco
用法:
@traced("search_docs")
def search_docs(query: str, top_k: int = 5):
    ...
四个字段必须有,缺一个后面都难受:
call_id:一次任务里可能调同一个工具五次,没有唯一 ID 就没法把「第几次调用失败」对上。
args:失败复盘时第一眼要看的就是参数。别只记 args 长度,要记内容(注意脱敏,下面讲)。
elapsed_ms:光有成功失败不够,慢和失败是两种病。
error_type:异常类名比异常消息稳定得多。TimeoutError 一眼就知道方向,而 str(e) 可能是一长串 HTML。
写 JSONL 而不是数据库,原因是它追加写、不锁、崩溃不丢。量大了再换 ClickHouse 之类的。
token 账:按任务记账,不按请求
大部分团队记 token 是这么记的:每次 LLM 调用打印一下 usage。这不够用。
因为一次 Agent 任务可能调 10 次模型,你要回答的问题是「这个任务花了多少」,不是「第 7 次调用花了多少」。
做法是给每个任务一个 task_id,所有模型调用带上它:
import json, uuid

class Meter:
    def __init__(self, log_path="token_usage.jsonl"):
        self.log_path = log_path
        self.task_id = uuid.uuid4().hex[:8]

    def record(self, step: str, model: str, usage):
        rec = {
            "task_id": self.task_id,
            "step": step,                       # plan / tool_call / answer ...
            "model": model,
            "in": usage.prompt_tokens,
            "out": usage.completion_tokens,
        }
        with open(self.log_path, "a", encoding="utf-8") as f:
            f.write(json.dumps(rec) + "\n")
step 这个字段是我加的私货,很有用。它让你能回答「钱花在规划上还是花在回答上」。经验值是:规划阶段通常只占总 token 的 10% 到 15%,但如果它占了 40%,说明你的 prompt 在重复喂上下文。
有了这份账,两个数就能算出来:
- 单任务平均成本 = 总花费 ÷ 任务数
- 单任务成本 p95 = 排序后取 95 分位
第二个数比第一个重要。Agent 的成本分布是长尾的,平均值会被正常任务稀释,而账单是被少数「跑了 30 轮还没收敛」的任务拉起来的。
失败归因:把异常分到四类
这一步是真正的分水岭。同样一句「任务失败了」,四种原因的处理方式完全不同:
| 类型 | 典型表现 | 该怎么修 |
|---|---|---|
| 模型理解错 | 选错工具、参数格式错、循环重复同一动作 | 改 prompt、加 few-shot、换模型 |
| 工具报错 | 第三方 API 4xx/5xx、鉴权失败、配额耗尽 | 加重试、加降级、换供应商 |
| 参数不合法 | 缺必填字段、类型不对、值越界 | 加 schema 校验(Pydantic) |
| 超时 / 资源 | 单步超时、总时长超限、上下文爆了 | 调超时、分片、截断策略 |
代码不长:
def classify(err: Exception, elapsed_ms: float, timeout_ms: int = 30000) -> str:
    if isinstance(err, TimeoutError) or elapsed_ms >= timeout_ms:
        return "timeout"
    if isinstance(err, (ValueError, TypeError, KeyError)):
        return "bad_args"
    name = type(err).__name__.lower()
    if any(k in name for k in ("http", "connection", "auth", "rateliMIT")):
        return "tool_error"
return "model_error" # 兜底:多半是模型选错工具或给错参数这个分类不完美,但只要开始分类,排查效率立刻变。因为「80% 的失败是参数不合法」和「80% 的失败是模型选错工具」对应两套完全不同的改法,而在一开始你根本不知道是哪种。
我的经验分布:刚上线的 Agent,bad_args 和 tool_error 加起来通常占七成以上。这两个都不是模型能力问题,都是工程问题,修起来最快。
一条日志长什么样
把三个维度串起来,一次失败排查的记录大概是这样:
{"ts":"2026-10-29T02:11:03.412Z","call_id":"a7f3c1d2","tool":"search_docs","args":{"query":"退款政策","top_k":5},"status":"ok","elapsed_ms":412.8}
{"ts":"2026-10-29T02:11:04.001Z","call_id":"b2e9a4f7","tool":"create_ticket","args":{"order_id":"A1029","reason":null},"status":"error","error_type":"ValIDAtionError","error_msg":"reason is required","elapsed_ms":3.1}
{"task_id":"9c2e77aa","step":"tool_call","model":"qwen3.6","in":3421,"out":188}
三行就能还原:检索成功了、建工单的参数 reason 是 null 被校验拦下、这一步花了 3421 输入 token。
归因结果是 bad_args,处理方式是给模型的工具 schema 里把 reason 标成必填并加一句描述。十分钟能修完,而如果没埋日志,你可能要花半天复现。
五个坑,按命中率排
坑 1:日志里记了明文参数。 工具参数里常有用户手机号、身份证、API Key。JSONL 落了盘就删不掉,先做脱敏再写:手机号保留后四位,token 类字段整体替换成 ***。
坑 2:只记成功路径。 大部分人的日志写在 try 里面,异常一抛就什么都没记。finally 里写日志是必须的。
坑 3:没有 task_id。 单次调用日志堆在一起,永远拼不回完整任务。这个字段要在任务开始时就生成,一路透传。
坑 4:把模型输出当参数直接透传。 模型给的参数一定要过一遍 schema 校验(工具边界的安全问题我在编码智能体投毒那篇里拆过)。不校验的话,bad_args 会以「奇怪的线上报错」形式出现在业务代码里,而不是在工具边界被拦住。
坑 5:日志只写不读。 埋了没人看等于没埋。至少每周跑一次归因统计,看四类的比例变化。比例变了说明最近改的东西有副作用。
边界与下一步
这套东西解决的是「单次任务为什么失败」。它解决不了「整体成功率是不是在下降」——那需要另一层聚合:按天统计各归因类型的占比、按工具统计失败率、按模型版本对比。
另外别过度埋点。三样里 token 账和失败归因是必选,工具调用日志记到「参数 + 耗时 + 结果长度」就够了,别把整个返回值写进去,那是存储的无底洞。
下一篇换方向,把站里逆向那条线串成一张路线图。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。