
一句话总结:英伟达 10 月 28 日开源的 Nemotron 3.5 Transcribe 是 34B 总参、4.3B 激活的语音模型,一个 checkpoint 同时做 40 语言转录、31 语言互译、13 语言说话人归因和音频问答,靠自然语言 prompt 控制输出格式;更值得抄的是它的适配路径——改 prompt 能把医疗语音的 WER 从 30.8% 降到 23.8%,再花 14 个 GPU 小时微调能降到 11.8%。
做语音转写的老问题是工具链太长:转录用一个模型,说话人分离用一个模型,翻译再换一个,拼起来还要自己做时间戳对齐。每换一个环节,错误就多一层。
Nemotron 3.5 Transcribe 把这几件事收进了一个 checkpoint,而且用 prompt 切换任务。这不算新概念,但它把「开放权重 + 说话人分离 + 长音频」凑齐了,这在之前没有。
规格:几个数字值得单独看
| 项目 | 数值 |
|---|---|
| 总参数 / 激活参数 | 34B / 约 4.3B(3.5B 语言模型 + 800M 音频编码器) |
| 架构 | Transformer 语音编码器 + 说话人编码器 → 混合 Mamba-2/Transformer MoE |
| 底座 | Nemotron 3.5 Lightning 30B-A3B |
| 上下文 | 64K |
| 语言能力 | 转录 40 种、互译 31 种、说话人归因 13 种 |
| 音频长度 | 单段最长 1 小时 |
| 说话人 | 最多 8 位,带词级时间戳 |
| 许可 | OpenMDW-1.1(可商用,条款需自己看) |
| 硬件 | 单张 NVIDIA GPU,从 Jetson AGX Thor、DGX Spark 到 Blackwell |
两个细节容易忽略:
它不是流式模型。 定位明确写着「面向录音,不面向实时流」。想做实时字幕得自己切窗,效果会打折。
音频问答只在英语上训过。 40 种语言转录不代表 40 种语言都能问答,说话人归因也只有 13 种。买之前先确认你的语种在哪个能力覆盖范围里。
榜单:开源第一,但不是全面第一
英伟达自报的成绩:Hugging Face Open ASR 英文榜 5.33% 平均 WER,开源模型第一;多语种 4.62%;长音频 10.98%。
第三方那边有个更有意思的数:Artificial Analysis 测出 2.81% AA-WER,跟 Mistral 的 Voxtral Small(2.77%)几乎打平,但激活参数是 4B 对 24B。
说话人分离上它确实领先:David AI 21 语言榜 18.26% 的 DER,14 个系统里最低,比英伟达自家的 Nemotron 3 Diarization(18.38%)还好一点。
还有一个指标我认为比 WER 更能说明问题:删除率 8.32%,而参评系统的中位数是 31%。
这个数字为什么重要?因为很多 ASR 系统降低 WER 的办法是「少写」——不确定的词就不输出,错误率好看了,但漏掉了真实内容。删除率 8.32% 说明它是真在转写,不是靠回避换分数。做会议记录、庭审记录这类场景,漏字比错字严重得多。
适配三步:先改 prompt,再微调
这是整篇里我最想让你记住的部分。
英伟达在印度医疗语音(Eka Care 案例)上做了个三级对比:
| 做法 | WER | 相对基线 |
|---|---|---|
| 基线 | 30.8% | — |
| 改 prompt | 23.8% | 降 7 个点 |
| 用 NeMo Speech 微调 | 11.8% | 降 19 个点 |
只看留出说话人(训练时没见过的人)这一项:从 22.44% 降到 12.17%,相对下降 45.8%。
三条工程结论:
第一,prompt 是免费的,先试它。 这个模型是「可提示」的——不用改配置,直接用自然语言告诉它要什么:
Transcribe this recording and label EACh speaker(转写并标说话人)Translate this audio into English(翻成英语)Transcribe without disfluencies(去掉口头语,要干净文本)- 附上领域术语表:
Use these terms only when supported by the audio: 阿托伐他汀, 氯吡格雷...
最后那条的写法很关键。要加「只在音频支持时使用」这句限制,否则模型会把术语表硬塞进不相关的位置,反而制造错误。
第二,微调的性价比比想象中高。 14 个 GPU 小时(单张 GB300)就完成了一轮领域适配,换来 45.8% 的相对改善。代价是通用英语的 WER 从 1.54% 微升到 1.69%——用一点点通用能力换大幅的领域提升,这个交换在垂直场景里几乎总是划算的。
第三,顺序不能反。 先微调再试 prompt,你会以为微调收益很大,实际上是 prompt 那 7 个点被吃掉了。
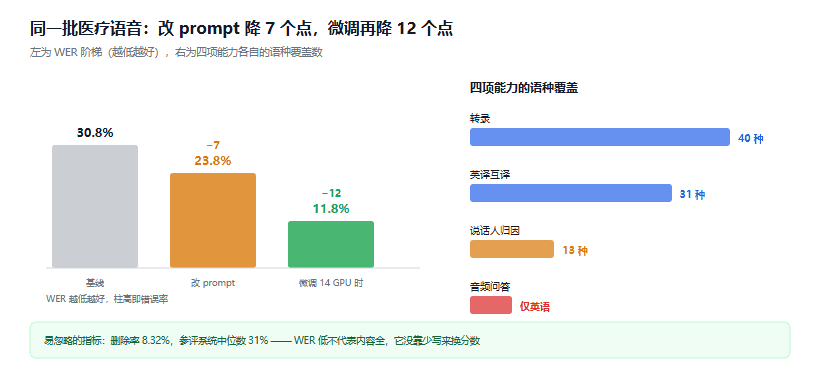
图 1:同一批医疗语音上,改 prompt 与微调的收益拆分,右侧是三个能力覆盖范围
长音频怎么切
模型单段上限 1 小时,但实际用的时候很少有正好一小时的音频。这里有几个能直接用的做法。
按静音切,不按固定时长切。 固定 30 秒切会把一句话劈成两半,两段都转不准。用能量或 VAD 找静音点切:
# 依赖:pip install pydub
from pydub import AudioSegment
from pydub.silence import split_on_silence

audio = AudioSegment.from_file("meeting.mp3").set_channels(1).set_frame_rate(16000)

chunks = split_on_silence(
    audio,
    min_silence_len=600,     # 静音超过 600ms 才切
    silence_thresh=-40,      # dBFS,环境噪声大就调高
    keep_silence=300,        # 每段前后留 300ms,防止咬字被切掉
)

# 合并过短的片段,避免把一句话拆成三段
merged, buf = [], AudioSegment.silent(0)
for c in chunks:
    buf += c
    if len(buf) >= 20000:        # 攒够 20 秒再输出
        merged.append(buf)
        buf = AudioSegment.silent(0)
if len(buf) > 0:
    merged.append(buf)

for i, seg in enumerate(merged):
seg.export(f"chunk_{i:03d}.wav", format="wav")两个参数的经验值:min_silence_len 设太小会把换气当停顿,切得稀碎;silence_thresh 设太严格(比如 -50)在嘈杂环境里永远等不到静音,最后整段超长。
说话人分离要跨段做。 这是最容易被忽略的一点:分段转写后,每段里的「说话人 1」是独立编号的,拼起来就成了「说话人 1、说话人 1、说话人 2、说话人 1」全乱。
两条路:一是把整段 1 小时音频一次性喂进去(模型支持),让它自己标;二是分段处理时,把上一段末尾的说话人信息作为提示带进下一段。第一条路省事,但显存和上下文要求高。
时间戳要加偏移量。 每段的词级时间戳是相对于该段起点的,合并时必须加上段偏移,否则整份转写的时间轴全错。
部署现状,别踩空
官方给的路径是两条:
vLLM + NeMo Speech 插件,OpenAI 兼容的 chat 端点。 这是生产路径,适合批量和并发。具体的启动参数跟着官方模型卡走,我不在这里猜命令。
NeMo-Speech.cpp 本地跑。 面向 DGX Spark、Jetson AGX Thor 这类设备。注意这条路的成熟度和发布节奏,官方材料里对它的表述有「计划」和「可用」两种说法,下载前先看仓库状态。
吞吐的官方数字:单张 RTX PRO 6000 Blackwell + NVFP4,100 小时音频 3 分钟内处理完。但这个数字的测法是 30 秒片段、高并发——它衡量的是批处理吞吐,不是「一段 1 小时录音多久出结果」。拿它算交互式场景的延迟会严重低估。
五个坑,按命中率排
坑 1:把删除率当成 WER 的附属指标。 WER 低不代表内容全。选型时两个数一起看,尤其做存档类转写。这个模型删除率 8.32%,是中位数的四分之一,这是它的隐藏优势。
坑 2:术语表不加限制语。 只给词表不写「仅在音频支持时使用」,模型会硬套术语,把发音相近的普通词改成专业词。这个错很隐蔽,错得很像对的。
坑 3:分段后不处理说话人编号。 每段的「说话人 1」是局部的,直接拼接会得到一份自相矛盾的记录。
坑 4:拿 100 小时/3 分钟算交互延迟。 那是高并发批处理的数字。单段长音频的端到端时间要看实际排队和编码耗时,自己测一遍才准。
坑 5:假设所有能力在 40 种语言上都可用。 转录 40 种、翻译 31 种、说话人 13 种、音频问答只有英语。语种越往小语种走,实际表现和榜单差距越大,官方也建议拿自己的录音先验。
边界与下一步
这篇解决的是「怎么用起来」,不涉及模型训练。如果要做垂直领域适配,NeMo Speech 的微调 recipe 是官方给的,14 GPU 小时起步这个量级说明它不要求大规模算力。
要提醒的是:我这边没有可用的 NVIDIA GPU 环境(本机那张 2060 的局限就是这么来的),上面的部署流程没有实际跑通,代码只到音频切分那一层(那段是通用的,逻辑可直接用)。模型加载和服务化的具体命令以官方模型卡为准。
Granary v2 那个数据集也值得单独看:463,062 小时、48 语言、16 个源语料库,每种录音给三种文本形式(逐字含口头语、归一化含符号、去口头语的干净版)。要训自己的 ASR,这个数据集的结构比它的规模更有参考价值。
下一篇换个方向,把站里逆向那条线串成一张路线图。
参考资料
- Hugging Face 模型卡 - 参数、架构、许可与部署方式
- 英伟达官方博客 - 榜单数据、Granary v2 与 Eka Care 医疗案例
- Unite.AI 报道 - 数据集规模与微调效果细节
- Artificial Analysis - 开源语音模型的准确率与激活参数对比
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。