
一句话总结:Clover-35B-A3B 有三条本地推理路径(Transformers、SGLang、llama.cpp),成熟度和性能差很多;它的推理栈在 KV cache、块大小、去噪阈值、防复读参数四处和自回归模型不一样,照搬自回归的部署经验一定会踩坑。
想本地跑一个能接进编码工具的模型,35B 总参、3B 激活这个规格是当前的甜点区:够用、够省、单卡能吃下。
Clover 的问题不在模型,在推理栈。它是块扩散模型,不是自回归模型,很多默认假设不成立。这篇按「先跑起来、再跑对、然后跑快」的顺序写,命令和参数都摊开。
前置条件
| 项目 | 要求 |
|---|---|
| 显存 | BF16 约 69GB(单张 90GB 卡);INT4 约 16GB |
| Transformers | 5.19.0 以上 |
| PyTorch | 2.10 以上 |
| 磁盘 | BF16 权重下载约 69GB,留 80GB 余量 |
| 系统环境变量 | 需要 trust_remote_code=True,模型带自定义建模代码 |
先说清楚:我这台机器是 RTX 2060 6GB,跑不了 69GB 的 BF16 权重,下面的端到端流程没有实测跑通。 代码和参数来自官方模型卡与发布博客,显存账是按权重体积算的。你如果有 90GB 卡或 A100/H100,照着能跑。
三条路径,成熟度差很多
| 路径 | 成熟度 | 适用 | 注意 |
|---|---|---|---|
| Transformers | 完整可用 | 验证、单请求、写代码调试 | 官方明说和 SGLang 有数值差异 |
| SGLang | 官方推荐 | 服务化、压测、批量 | 需要官方的实现分支,按仓库 README 装 |
| llama.cpp | 部分可用 | 消费级卡、INT4 | 后端代码还没进仓库,自推测解码待完善 |
这个排序很关键。官方推荐 SGLang,也明确说了 Transformers 和 SGLang 内核之间有小的数值差异,同参数会生成不同文本。 所以:调试用 Transformers,评测和上线用 SGLang,别混着比结果。
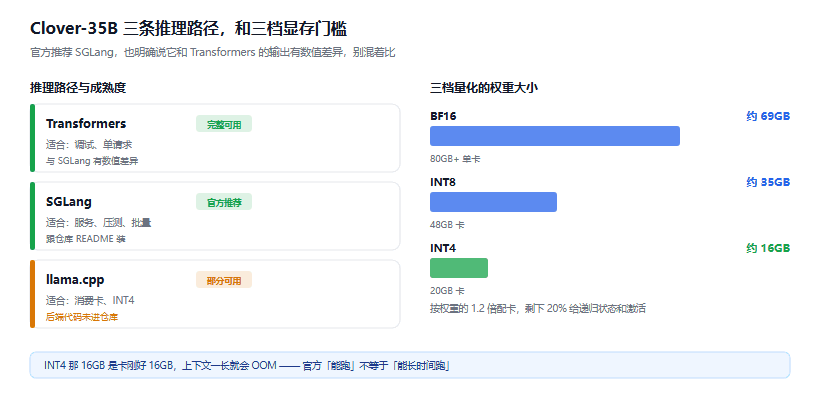
图 1:三条路径的成熟度对比,以及三档量化对应的硬件门槛
第一步:用 Transformers 先跑通
这是最快确认「模型能不能用」的方式。官方给的最小示例:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "DiffuSpace/Clover-35B-A3B-Preview"

tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    trust_remote_code=True,
    dtype=torch.bfloat16,      # 老版本 transformers 用 torch_dtype
    device_map="cuda:0",
).eval()

messages = [{"role": "user", "content": "用三句话解释块扩散"}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
    enable_thinking=True,       # 思考模式开关
)

inputs = tokenizer(prompt, add_special_tokens=False, return_tensors="pt").to("cuda:0")

with torch.inference_mode():
    output = model.generate(
        **inputs,
        max_new_tokens=4096,
        block_size=32,          # 每块 32 token,默认值
        threshold=0.95,         # 置信度阈值,默认值
        do_sample=False,
    )

text = tokenizer.decode(output[0][inputs["input_ids"].shape[1]:],
                        skip_special_tokens=True)
print(text)
四个参数值得单独解释,因为它们不是自回归模型里的东西:
block_size=32 是每轮并行去噪的 token 数。调大能提高并行度,但块内 token 一多,历史信息的权重会被稀释,模型靠「块大小校准」补偿,补偿能力有上限。官方默认 32,别一上来就往上调。
threshold=0.95 是块内位置被填上的置信度门槛。设高(0.99)会更保守、多轮去噪、慢但质量好;设低(0.8)会更快,但填错的概率上升。这是这套体系里最直接的「质量-速度」旋钮。
enable_thinking=True 打开思考模式。Clover 支持,但注意思考 token 也算在 max_new_tokens 里,预算给少了会被截断。
max_new_tokens 别随手开到 24576。扩散模型超长生成容易变复读机,官方为此内置了从 8192 token 开始渐强的长度惩罚,但惩罚是软约束,不是硬截断。
第二步:包一层 OpenAI 兼容接口
SGLang 的官方实现在仓库里,具体安装命令跟着 README 走(我这边没法验证,不猜具体参数)。如果你想马上让 Cline、Continue 这类工具接上,用 Transformers 包一层最快:
# serve.py
import torch, uvicorn
from fastAPI import FastAPI
from pydantic import BaseModel
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Diffuspace/Clover-35B-A3B-Preview"

tok = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID, trust_remote_code=True,
    dtype=torch.bfloat16, device_map="cuda:0",
).eval()

app = FastAPI()

class Msg(BaseModel):
    role: str
    content: str

class Req(BaseModel):
    model: str = MODEL_ID
    messages: list[Msg]
    max_tokens: int = 4096
    temperature: float = 0.0

@app.post("/v1/chat/completions")
def chat(req: Req):
    prompt = tok.apply_chat_template(
        [m.model_dump() for m in req.messages],
        tokenize=False, add_generation_prompt=True, enable_thinking=True,
    )
    inputs = tok(prompt, add_special_tokens=False, return_tensors="pt").to("cuda:0")
    with torch.inference_mode():
        out = model.generate(
            **inputs,
            max_new_tokens=req.max_tokens,
            block_size=32,
            threshold=0.95,
            do_sample=req.temperature > 0,
            temperature=max(req.temperature, 1e-5),
        )
    text = tok.decode(out[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
    return {
        "id": "chatcmpl-clover",
        "object": "chat.completion",
        "model": req.model,
        "choices": [{
            "index": 0,
            "message": {"role": "assistant", "content": text},
            "finish_reason": "stop",
        }],
    }

if __name__ == "__main__":
    uvicorn.run(app, host="127.0.0.1", port=8000)
起来之后,任何支持自定义 base_uRL 的客户端都能接:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"写一个二分查找"}],"max_tokens":2048}'
这段是单请求串行的,没有 batching,吞吐会很差。只适合验证和单人用,不适合多用户服务。 要并发就必须上 SGLang。
第三步:显存怎么算
| 精度 | 权重大小 | 最低显存 | 典型卡 |
|---|---|---|---|
| BF16 | 约 69GB | 80GB+ | H100 / A100 80G / GB300 |
| INT8 | 约 35GB | 48GB | A6000 / L40S |
| INT4 | 约 16GB | 20GB | RTX 5070 Ti 16GB(官方实测 101.8 tok/s) |
别只算权重。 扩散模型有三块额外开销:
- 递归状态(历史压缩后的记忆),随上下文长度增长
- 当前块的激活值,块越大越高
- 框架本身的显存碎片
按权重的 1.2 倍估比较稳。INT4 那档官方说 16GB 能跑,是因为 5070 Ti 正好 16GB,实际留给递归状态和激活的空间很小,上下文一长就会 OOM。MoE 那篇的显存估法可以套过来用,只是把 KV cache 换成递归状态。
五个坑,按命中率排
坑 1:用 Transformers 的结果去评价性能。 官方明确说 Transformers 和 SGLang 输出有数值差异。你在 Transformers 上测出的 tok/s 不能代表服务化性能,测出的质量也不能直接和别人的 SGLang 结果比。
坑 2:忘了 trust_remote_code=True。 模型带自定义建模代码,不加这个参数会直接报错说找不到模型类。这个错很常见,报错信息又不够直白。
坑 3:把 max_new_tokens 开到很大。 扩散模型的超长生成会退化成复读。默认的 presence_penalty=0.9、repetition_penalty=1.05 是官方调好的,别为了「更自由」去关掉。
坑 4:只按权重体积配卡。 69GB 权重配 80GB 卡,剩下 11GB 装不下长上下文的递归状态。要么缩上下文,要么上 96GB 以上的卡。
坑 5:拿 block_size 当加速旋钮。 调大确实并行度更高,但块内历史权重被稀释,质量会掉。真想加速,先调 threshold(0.95 → 0.9 收益更直接),再考虑块大小。
边界与下一步
这篇只解决「能不能跑起来」。能跑起来之后下一个问题是:它到底比现有方案快多少、贵多少?
官方给的 680 tok/s 是 GB300 上 BF16 batch=1 的数字,你的卡、你的 batch、你的输入长度都会让这个数字变。下一篇写怎么自己压测,包括 TTFT 怎么测、并发怎么扫、以及为什么「官方 tok/s」几乎总是偏乐观。
模型本身的能力边界,我在那篇深度解读里拆过:Agent 编程强,数学和硬知识弱,全自测没第三方复现。部署之前先想清楚你要它干什么。
另外提醒一句:Clover 的 llama.cpp 后端代码目前还没进仓库,只有移植说明。想在消费级卡上跑 INT4,现在最稳的路径还是等官方把 llama.cpp 那条路补完,或者用 Transformers 加量化加载,别指望 Ollama pull 就能跑。
参考资料
- Hugging Face 模型卡 - 加载方式、解码参数默认值与硬件要求
- 官方发布博客 - SGLang 推荐、速度实测与量化数据
- GitHub 仓库 - SGLang 实现与 llama.cpp 移植现状
- AICoder 报道 - BF16 权重体积与部署条件
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。