
一句话总结:prompt 缓存的价格差是 10 倍(Mistral 缓存输入 $0.07 对输入 $0.70),但它的生效条件很硬——从第一个 Token 开始完全一致才能复用;大多数人的 prompt 把动态内容放在前面、静态内容放在后面,正好把缓存全打掉。改结构比换模型省钱。
Agent 类应用的 token 消耗,七成以上是重复的:系统提示、工具定义、知识库片段、历史对话,每次调用都要重发一遍。
厂商为此做了前缀缓存(prefix caching):如果这次请求的前缀和上次完全一致,已经算过的 KV 直接复用,不用重新 prefill。价格上体现得很直白——Mistral Large 4 的缓存输入是 $0.07,普通输入 $0.70,差 10 倍。
听起来是白捡的钱。但实际跑起来,很多人发现账单没降。原因通常不在厂商,在 prompt 的拼接顺序。
缓存的唯一硬条件:前缀逐 token 一致
这张图值得记住:
请求 A:[系统提示 2000 token][文档 8000 token][问题 "退款政策"]
请求 B:[系统提示 2000 token][文档 8000 token][问题 "发票怎么开"]
                       ↑ 到这里为止完全一致,这 10000 token 命中缓存
请求 A:[系统提示 2000 token][文档 A][问题 X]
请求 B:[系统提示 2000 token][文档 B][问题 X]
↑ 文档不同,从这之后全部失效规则是:从第一个 token 开始,连续相同的最长部分才能命中。 中间只要有一个字符不同,它后面的一切都不算缓存。
这解释了为什么「加了缓存但没省钱」:很多实现把时间戳、用户名、随机 ID 放在系统提示开头,第一句就分叉了,后面一万 token 全部重算。
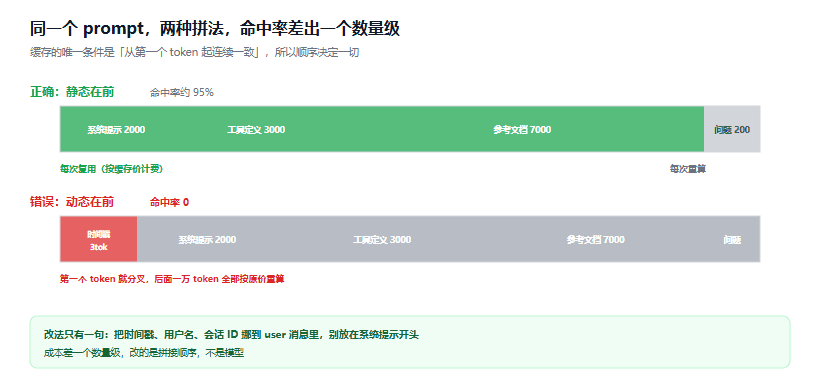
图 1:左边是静态在前、命中整段前缀;右边是动态在前,从第一个变量起全部失效
正确结构:静态在前,动态在后
一条规则能解决大部分问题:越稳定的内容越靠前,越易变的内容越靠后。
def build_messages(user_question, doc_text, session_Meta):
    # ✅ 正确:完全静态的部分放最前面
    system = (
        "你是一个企业知识库助手。回答要求:\n"
        "1. 只依据给定文档回答,不要编造\n"
        "2. 引用原文时标注段落编号\n"
        "3. 无法回答时明确说「文档中未提及」\n"
        "...(2000 token 的固定规则,一字不变)"
    )

    # 文档是半静态的:同一份文档会被连续问很多次,所以紧跟系统提示
    doc_block = f"【参考文档】\n{doc_text}"

    # ❌ 错误示范:把会话变量插到最前面
    # system = f"当前时间 {now},用户 {user_name},会话 {session_id}\n" + system

    return [
        {"role": "system", "content": system + "\n\n" + doc_block},
        {"role": "user", "content": user_question},   # 只有这部分每次都变
    ]
对比一下把时间戳放开头会怎样:
# 每次请求的第一个 token 就不同 → 缓存命中率 0
system = f"[{datetime.now().isoformat()}] 你是企业知识库助手..."
如果确实需要把时间和用户信息传给模型,两个办法:放到 user 消息里(反正那部分本来就不缓存),或者把动态字段挪到静态内容的后面。
显式缓存标记:Anthropic 那套更可控
各家实现不同,用法差别不小:
| 厂商 | 方式 | 计费 |
|---|---|---|
| OpenAI | 自动,前缀超过阈值即缓存 | 缓存命中部分按折扣价 |
| DeepSeek | 自动,按 64 token 块对齐 | 命中/未命中分别计价 |
| Anthropic | 需要显式标注 cache_control | 写入 1.25 倍,读取 0.1 倍 |
| Mistral | 自动 | 缓存输入 $0.07 vs 输入 $0.70 |
Anthropic 的显式标记要多说一句,因为它有「写入费」:
messages = [{
    "role": "system",
    "content": [{
        "type": "text",
        "text": LONG_STATIC_PROMPT,
        "cache_control": {"type": "ephemeral"}   # 打在这个块的末尾
    }]
}]
第一次请求要为写入付 1.25 倍,之后每次读取只要 0.1 倍。这意味着一份缓存要被读 3 次以上才划算——如果某个 prompt 只调用一两次,标 cache_control 反而更贵。
这个细节很多人不知道,以为打了标记就一定省。
命中率怎么监控
不监控就等于没做。三家返回的字段名不一样,但要看的都是「缓存命中的 token 数」:
def report_usage(usage, provider: str) -> dict:
    if provider == "openai":
        cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0)
        total = usage.prompt_tokens
    elif provider == "deepseek":
        cached = usage.prompt_cache_hit_tokens
        total = usage.prompt_tokens
    elif provider == "anthropic":
        cached = usage.cache_read_input_tokens
        total = (usage.input_tokens
                 + usage.cache_read_input_tokens
                 + usage.cache_creation_input_tokens)
    else:
        return {}

    return {
        "prompt_tokens": total,
        "cached_tokens": cached,
        "hit_rate": round(cached / total, 3) if total else 0.0,
    }
判断标准很直接:
- hit_rate 低于 30%:结构有问题,静态内容可能被动态内容隔开了
- hit_rate 在 70% 到 90%:正常,剩下的部分是每次都变的问题和上下文
- hit_rate 突然掉到 0:有人在系统提示里插了时间戳、随机 ID 或者用户昵称
第二种情况里那 10% 到 30% 是省不掉的,别追求 100%。
一笔具体的账
假设一个客服 Agent:系统提示 + 工具定义 + 知识片段共 12000 token,用户问题平均 200 token,每天 20000 次调用。
| 场景 | 每次输入 token | 有效单价 | 每日输入成本(按 $0.70/M) |
|---|---|---|---|
| 无缓存 | 12200 | $0.70/M | 约 $170.8 |
| 全部命中前缀 | 12200(其中 12000 命中) | 12000×$0.07 + 200×$0.70 | 约 $17.1 |
每天的差距在 150 美元量级,一个月四千多。这不是优化,这是结构性差异。
(这个计算只算输入,不含输出。输出的 token 不走缓存。)
五个坑,按命中率排
坑 1:动态内容放开头。 时间戳、用户名、会话 ID、随机 seed 放在系统提示第一行。这是最常见也最致命的一种,命中率直接归零。
坑 2:工具定义每次重新序列化。 工具 schema 用字典生成,每次遍历顺序变、字段顺序变,导致前缀不同。工具定义要固定序列化(排序后输出)。
坑 3:多轮对话把历史全塞在前面。 聊到第五轮,历史已经变长,前缀跟着变。正确做法是让历史自然增长(只追加不修改),这样前四轮的部分仍然命中;一旦你对历史做摘要、删除或重排,缓存全废。
坑 4:给短 prompt 打 cache_control。 只调用一两次的 prompt 打标记,写入费 1.25 倍,净亏。缓存要算「读取次数」,不是「能打就打」。
坑 5:不同租户共享缓存导致串味。 如果你的系统提示里嵌了租户特定配置,不同租户的前缀不同,各自独立命中,这是对的;但如果为了省缓存把所有租户的系统提示做成完全一样、把租户信息塞进用户消息,要确认模型不会把 A 租户的上下文用到 B 租户的回答里。安全边界优先于省钱。
边界
这篇讲的是「减少重复计算」,不是「减少 token 用量」。真要压 token,得从 prompt 精简、上下文裁剪、RAG 召回质量上下手,那是另一套工程。监控命中率的思路和Agent 可观测性那篇里的 token 账是一回事,可以合起来做。
另外,缓存的有效期各家不同(从几分钟到几小时不等),过期就得重新写入。高频调用的服务影响不大,低频的批处理任务可能每次都在写缓存、吃不到读的便宜,这种场景要先算「调用频率 × 缓存有效期」够不够覆盖写入成本,用压测那篇的方法量一下真实调用频率再定。
参考资料
- Anthropic 文档 - prompt caching 与 cache_control 用法
- OpenAI 文档 - 自动前缀缓存与 cached_tokens 字段
- DeepSeek 文档 - 上下文硬盘缓存与计价方式
- Mistral 定价页 - 缓存输入与普通输入价差
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。