
一句话总结:Agent 跑飞是必然会发生的,区别只在于你有没有在下单之前设闸——用轮数、Token、金额、墙钟时间四种预算做一次性拦截,超限时优雅退出返回部分结果而不是抛异常给用户,再加一个原子写的检查点让任务能续跑,以及在预算过半时自动降级模型。
先说一个真实场景:一个文档处理 Agent,正常任务 8 到 12 轮完成,某天遇到一份格式不一致的文件,它在「读取失败 → 重试 → 换个方式读 → 又失败」的循环里转了 47 轮,烧掉 38 万 token,末了什么都没交付。
这不是模型笨,是没有闸门。Agent 是个循环,任何没有上限的循环都会在某次输入上失控。
四道闸门,缺一道漏一道
| 闸门 | 拦什么 | 典型值 |
|---|---|---|
| 轮数 | 循环转不停 | 15–30 轮 |
| token 总量 | 上下文无限膨胀 | 20 万–50 万 |
| 金额 | 账单失控 | $0.2–$1 每任务 |
| 墙钟时间 | 卡在慢接口上 | 3–10 分钟 |
四个都要,因为它们拦的是不同的病:
- 只限轮数,遇到超长文档的合法任务会被误杀
- 只限金额,遇到便宜模型跑 100 轮也发现不了
- 只限时间,遇到高速模型烧 token 很快但时间没到
- 三个都设了不限 token,可能上下文已经爆了还在重试
代码不长,一个类解决:
import time
from dataclasses import dataclass, field


class BudgetExceeded(Exception):
    def __init__(self, kind: str, used, liMIT):
        self.kind, self.used, self.limit = kind, used, limit
        super().__init__(f"{kind} 超限:{used} > {limit}")


@dataclass
class Budget:
    max_rounds: int = 20
    max_tokens: int = 200_000
    max_cost_usd: float = 0.50
    max_seconds: float = 300.0

    price_in: float = 0.70 / 1_000_000     # 按你的模型改
    price_out: float = 2.10 / 1_000_000

    rounds: int = 0
    tokens_in: int = 0
    tokens_out: int = 0
    cost: float = 0.0
    started: float = field(default_factory=time.monotonic)

    def tick(self, tin: int, tout: int):
        """每完成一次模型调用就记一次"""
        self.rounds += 1
        self.tokens_in += tin
        self.tokens_out += tout
        self.cost += tin * self.price_in + tout * self.price_out
        self._check()

    def _check(self):
        if self.rounds > self.max_rounds:
            raise BudgetExceeded("rounds", self.rounds, self.max_rounds)
        total = self.tokens_in + self.tokens_out
        if total > self.max_tokens:
            raise BudgetExceeded("tokens", total, self.max_tokens)
        if self.cost > self.max_cost_usd:
            raise BudgetExceeded("cost", round(self.cost, 4), self.max_cost_usd)
        elapsed = time.monotonic() - self.started
        if elapsed > self.max_seconds:
            raise BudgetExceeded("time", round(elapsed, 1), self.max_seconds)

    def used_ratio(self) -> float:
        """已用比例,取四项里最紧的那个"""
        return max(
            self.rounds / self.max_rounds,
            (self.tokens_in + self.tokens_out) / self.max_tokens,
            self.cost / self.max_cost_usd,
            (time.monotonic() - self.started) / self.max_seconds,
        )
used_ratio() 这个方法是给降级用的,后面讲。
超限之后:返回部分结果,别抛给用户
最容易写错的地方在这里。很多实现让 BudgetExceeded 一路冒泡,用户最终看到一句「预算超限」,前面 15 轮的产出全丢了。
正确的处理是把超限当成一种正常结束状态:
def run_agent(task: str, budget: Budget | None = None):
    budget = budget or Budget()
    transcript, findings = [], []

    try:
        while True:
            step = call_model(task, transcript)          # 你的模型调用
            budget.tick(step.usage.prompt_tokens, step.usage.completion_tokens)
            transcript.append(step.message)

            if step.is_final:
                return {"status": "ok", "answer": step.message, "rounds": budget.rounds}

            if step.tool_call:
                result = run_tool(step.tool_call)
                findings.append(result)
                transcript.append({"role": "tool", "content": result})

    except BudgetExceeded as e:
        # 关键:把已经做出来的东西还回去
        return {
            "status": "partial",
            "reason": str(e),
            "progress": {
                "rounds": budget.rounds,
                "cost_usd": round(budget.cost, 4),
                "findings": findings,
                "last_message": transcript[-1] if transcript else None,
            },
        }
status: partial 这个状态值的价值在于:调用方可以决定是重试、换模型、还是把半成品交给人工。 比一句异常有用得多。
配套的策略一般是三档:
ok:正常返回partial:有进展但没完成,附上进度和已花费failed:第一轮就失败,没有可交付内容
检查点:让任务能续跑
超限退出之后,如果用户重试要从头开始,那这个护栏就变成了「花两次钱做同一件事」。检查点解决这个问题。
import json, os

def save_checkpoint(path: str, state: dict):
    tmp = f"{path}.tmp"
    with open(tmp, "w", encoding="utf-8") as f:
        json.dump(state, f, ensure_ascii=False)
    os.replace(tmp, path)          # 原子替换,断电也不会写坏


def load_checkpoint(path: str) -> dict | None:
    if not os.path.exists(path):
        return None
    with open(path, encoding="utf-8") as f:
        return json.load(f)
两个细节决定它管不管用:
用 os.replace 而不是直接覆盖写。 直接写如果中途崩溃,文件会变成半截 JSON,续跑时解析失败,比没有检查点更糟。
保存「可续跑的中间状态」,不是完整日志。 需要存的是:已完成到第几步、已收集到的事实、当前待办。不需要存每一次对话的原文——那是日志该干的事。
在主循环里每完成一轮就更新一次,代价很小(一个几百字节的文件)。
分级降级:预算过半就换打法
护栏的目的不是「撞墙就停」,是「在有限预算里尽量交付」。所以预算用掉一半时应该主动改变策略:
CHEAP_MODEL = "small-flash"
STRONG_MODEL = "large"

def pick_strategy(budget: Budget):
    if budget.used_ratio() < 0.5:
        return {"model": STRONG_MODEL, "thinking": True}
    if budget.used_ratio() < 0.8:
        # 过半:关思考、换便宜模型,保住轮数
        return {"model": CHEAP_MODEL, "thinking": False}
    # 接近上限:只要结论,不要过程
return {"model": CHEAP_MODEL, "thinking": False, "answer_only": True}三档逻辑对应三种成本结构:
- 前一半预算花在「想清楚」
- 中间 30% 花在「执行」
- 剩下 20% 只够「总结已有发现」
这个设计比硬性截断有效得多。实测里,同样预算下 partial 变成 ok 的比例明显提高,因为大部分任务卡在收尾那一步,而不是核心推理。
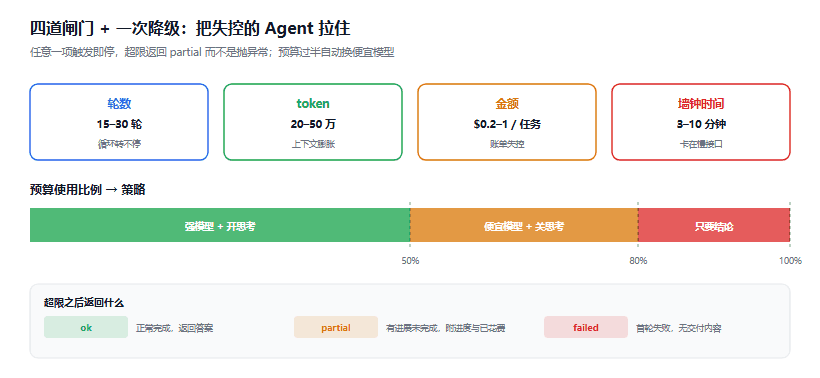
图 1:四项预算任意一项触发即停,过半后策略降级
五个坑,按命中率排
坑 1:只限轮数。 上面那个 47 轮的例子,限 20 轮确实能拦住,但如果任务是 15 轮内合法完成、却因为上下文膨胀烧了 50 万 token,限轮数一点用都没有。
坑 2:超限抛异常不做兜底。 用户看到报错,前面白做。必须返回 partial 和已经拿到的成果。
坑 3:检查点写非原子。 崩溃时留下半截 JSON,下次启动直接解析失败。用临时文件 + os.replace。
坑 4:单价写死。 模型换价格、换模型、用缓存(缓存输入便宜 10 倍),预算算出来的数就不准了。单价要跟着配置走,最好从配置中心读。
坑 5:只做单任务预算,不做全局熔断。 单任务 $0.5 看着不多,一万个任务同时跑就是 $5000。要有一层全局配额:每小时/每天的总花费上限,超了直接拒绝新任务,而不是让所有任务一起超支。
边界
这套是「防止单次任务失控」,不是「成本优化」。真要降本,得看 prompt 缓存和上下文裁剪。
另外预算值的设定要有数据支撑。拍脑袋定 $0.5,可能把 20% 的合法任务误杀。先按 可观测性那篇的方法记两周的 token 账,看 p95 单任务成本,再定预算——上限一般设在 p95 的 2 到 3 倍。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。