
一句话总结:DeepSeek Harness 团队 10 月 31 日公开的 Super-agent 架构核心不是"让 AI 自主干活",是承认人的注意力有上限:一个人同时只能跟进 3 到 5 个会话。所以它把会话管理交给系统,用 Router 统一接消息、两级过滤筛任务、多个 Worker 并行执行。这篇用 141 行标准库代码实现同一套结构,实测 20 条混进来的消息只有 6 条值得开工。
一、先看清它解决的问题
官方在文里说了一句很实在的话:随着模型能力提升,AI 完成单个任务越来越不需要人管,但人管理多任务的注意力没有同步增长。多任务的上限,从"模型行不行"变成了"人盯不盯得过来"。
这句话解释了为什么需要这层架构。
过去我们用 Agent 是这样的:开一个对话,给一个任务,等它做完,看结果,再给下一个。串行的,人是瓶颈。
Super-agent 的改法是把这条路拆成两段。Router 持续在跑,负责接所有渠道进来的消息并分派;Worker 各自维护独立上下文,并行干活,需要时还能再调子 Agent。
中间那一步最关键:什么消息值得开一个 Worker。
二、Router 和 Worker 各管什么
按官方描述,Router 是全局协调节点,收群聊、GitHub、邮件等多个渠道的消息,然后分派。Worker 是执行单元,每个维护自己的上下文,可以做问题复现、代码审查、功能开发这些具体工作。
这里面有个容易忽略的设计:Worker 的上下文是独立的。这意味着两个 Worker 同时干活时,不会因为共用一段上下文互相污染。代价是它们之间要交换信息只能靠 Router 或者共享的黑板。
我的理解是,这套结构本质上把"一个 Agent 干所有事"换成了"一堆 Agent 各干一件"。这样单个 Worker 的上下文更短、更可控,出错影响面也更小。
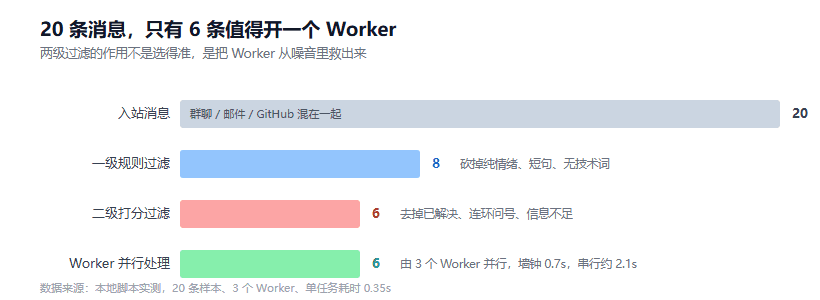
图 1:实测的过滤比例,20 条消息进来,二级过滤留下 6 条
三、一级过滤:用规则砍掉八成
Router 面对的第一个问题是量。群聊里的消息大部分跟工作无关,如果每条都送给模型判断,光是判断的成本就受不了。
所以第一层必须是最便宜的:规则。零成本、零延迟、可以随便砍。
NOISE_TOKENS = ("哈哈", "收到", "好的", "+1", "赞同", "???", "😂")
TECH_TOKENS = ("报错", "异常", "崩溃", "超时", "内存", "接口", "部署",
               "登录", "支付", "数据", "查询", "导出", "500", "403")

def filter_l1(msg):
    t = msg.text.strip()
    if len(t) < 8:
        return False
    if any(n in t for n in NOISE_TOKENS):
        return False
    if not any(k in t for k in TECH_TOKENS):
        return False
    return True
三条规则,对应三类噪音:太短的("收到")、纯情绪("哈哈")、没有技术词的("今天午饭吃啥")。
这一层的设计原则是宁可错杀。因为过不了这一关的消息,后面还有二级过滤;但过了这一关的噪音,会直接消耗模型调用。
实测 20 条里砍掉 12 条,留下 8 条。
四、二级过滤:打分,决定值不值得开工
第二层才用到判断力。真实项目里这里是 LLM 调用,我为了能离线复现,用规则打分模拟同一件事。
def score_l2(msg):
    t = msg.text
    s = sum(10 for k in TECH_TOKENS if k in t)
    if msg.source == "GitHub":
        s += 15
    if any(w in t for w in ("复现", "步骤", "日志", "版本")):
        s += 20
    if "已解决" in t or "解决了" in t:
        s -= 40
    if t.count("?") + t.count("?") >= 2:
        s -= 10
    return s
四类信号:命中技术词的密度、来源可信度、有没有可操作信息、以及两条负向信号。
负向那两条是我加的,也是我认为最该加的。一条是"已解决",这类消息看着像任务,实际是收尾通知,开个 Worker 纯属浪费。另一条是连环问号,??? 这种通常表达的是情绪,不是要你查什么。
阈值定在 20。这个数没有理论依据,是拿样本试出来的:太低会把情绪消息放进来,太高会漏掉真实的轻量问题。
五、Worker 并行,以及我踩的那个坑
Worker 用线程池,从队列里取任务,各自跑。
第一版我写成了这样:
def worker(wid, q, results, lock):
    while True:
        try:
            msg, sc = q.get(timeout=2)
        except queue.Empty:
            return
        ...
用超时来退出。逻辑上说得通:队列空了等 2 秒,没活就退出。
跑出来结果很难看:
并行 3 个 Worker:墙钟 2.71s,串行需要约 2.1s并行比串行还慢。 原因很简单,6 个任务 3 个 Worker,两轮干完只要 0.7 秒,剩下每个 Worker 各自空转等 2 秒超时才退出,总时间被这个等待拖到 2.7 秒。
改成哨兵退出就好了:
def worker(wid, q, results, lock):
    while True:
        item = q.get()
        if item is None:          # 主线程放完任务后投放结束信号
            q.task_done()
            return
        msg, sc = item
        ...
主线程在所有任务投完之后,往队列里放 N 个 None,一个 Worker 一个。谁先空下来谁就拿到 None 退出,不空转。
改完:
并行 3 个 Worker:墙钟 0.7s,串行需要约 2.1s这才是 3 倍加速,符合 6 个任务分 3 个 Worker 两轮的理论值。
这个坑我写进坑清单了,因为它极容易犯,而且犯了之后性能问题表现成"框架不行",不会想到是退出机制。
六、完整跑一遍
入站 20 条 -> 一级过滤 8 条 -> 二级过滤 6 条
[W1] 处理完成 (0.35s) GitHub: 导出功能在 10 万行数据下超时,复现步骤:选全
[W3] 处理完成 (0.35s) GitHub: 查询接口在并发 200 时异常退出,堆栈见附件
[W2] 处理完成 (0.35s) 群聊: 登录接口报 500,用户反馈集中在安卓端,有日志
[W1] 处理完成 (0.35s) GitHub: 登录态在多标签页下丢失,版本 v2.8.0
[W3] 处理完成 (0.35s) 邮件: 支付回调偶发丢单,附版本号 v2.8.1 和三条
[W2] 处理完成 (0.35s) GitHub: 数据同步任务在跨时区场景下重复执行

并行 3 个 Worker:墙钟 0.7s,串行需要约 2.1s
六条通过的消息,三条来自 GitHub,一条邮件,一条群聊。被砍掉的有:已经解决的、纯情绪、连环问号、以及"内存占用是不是有点高???"这种只有情绪没有信息的。
末尾那条值得单独说。它带技术词"内存",长度也够,过了一级过滤。但二级打分只有 10 分,被问号扣到 0,没进队列。如果我是一个真在值班的人,可能会回一句"具体多少"。系统的选择是不管,这个取舍我认为是对的:宁可漏掉一个模糊的抱怨,也别为它开一个 Worker。
七、坑清单
按影响排序。
1. 用超时退出,并行变串行。 上面那个,实测 2.71s 对 0.7s,差近 4 倍。所有基于队列的 Worker 池都有这个坑。
2. 过滤阈值拍脑袋定,没拿样本试。 我第一次把阈值定在 40,实测只剩 2 条通过,真实的 bug 报告全被漏了。阈值必须用你自己的消息样本反推,不能抄。
3. 一级过滤只按关键词,漏掉变体表述。 技术词表是硬编码的,用户说"打不开""进不去""一直转圈",一个都命中不了。真实项目要定期把漏掉的说法补进词表,这件事只能靠人工迭代。
4. Worker 之间共享上下文。 官方设计是各自独立,实现时如果图省事用一个全局 messages 列表,两个任务会互相污染,表现是 A 的输出里出现 B 的内容。这类 bug 极难查。
5. 不做结果回收。 Worker 干完活没人收,等于白干。要给每个任务一个 task_id,结果落到统一的表里,再由 Router 决定推给谁。
八、边界
这套东西只解决了调度,没解决质量。
Worker 干得好不好,取决于它用的模型和给的上下文,这部分这篇没碰。多 Agent 的协作协议、冲突裁决、失败重试,也都不在最小实现里。
还有一条官方自己提的:AI 在没人 @ 的情况下也能识别群聊里的潜在缺陷,主动后台复现。这个能力听着好,实际风险不小,误判一次就是无谓的后台任务消耗。我倾向于先把"被人叫到才动"做稳,再放开主动。
站里之前写过主动型 Agent,那篇解决的是"什么时候该打扰人",这篇解决的是"谁来接活"。两篇合起来是一套完整的调度层。
参考资料
- 环球网 - DeepSeek 发布 Super-agent 架构,Router 与 Worker 双层设计
- DeepSeek Harness - Super-agent 设计探索原文
- Python 官方文档 - queue 与 threading 模块
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。