
一句话总结:Vercel Labs 开源的 agent-desktop 走了一条和主流不同的路,不让 Agent 看截图,而是读操作系统的原生无障碍树。我实测了同一屏内容,截图约 1,365 token,提炼出的 16 个无障碍节点约 260 token,差 5.2 倍。但省 token 只是副产品,真正值钱的是确定性:树里的元素有 ID、有角色、有位置,点就是点,不会因为换了个主题就认错按钮。
一、截图路线的三个坑
让人工智能操作图形界面,最直觉的做法是:截一张图,让模型看图找按钮,算出坐标,点击。这套东西叫视觉循环,2024 年之后被大量产品采用。
它有三个绕不过去的问题。
成本。 一张 1280×800 的截图,按常见的图像 token 估算规则是 1,300 多 token。一个操作循环走 10 步,每步都要重新截图,就是一万多 token。如果界面没变,这些 token 花得毫无意义。
稳定性。 模型认按钮靠的是视觉特征。换了主题色、系统字体变大、弹了个通知遮挡、窗口没最大化,识别就出错。这类错误不会报异常,它会点错地方。
精度。 "点击右上角那个齿轮"这件事,人能一次做对,模型要靠像素坐标估。有的界面两个图标挨得很近,模型给坐标偏差 20 像素,点到隔壁去了。
我认为这三条里,稳定性是最要命的。成本高你能接受,点错地方你接受不了。
二、agent-desktop 换了个入口
Vercel Labs 开源的 agent-desktop 1.0.2,采用 Apache-2.0,是一个 Rust 写的命令行工具加 C 库。它的做法是让 Agent 通过操作系统的原生无障碍树操作应用,覆盖 macOS、Windows、Linux。
无障碍树这个概念本来是给读屏软件用的。每个操作系统都维护一棵树,描述当前界面上有哪些控件、它们是什么类型、叫什么名字、在什么位置、当前是什么状态。浏览器里的 HTML 有对应的 ARIA 属性,桌面应用有各自的 UIA、AX、AT-SPI 实现。
Agent 读这棵树,拿到的不是像素,是结构化的节点列表。要点击某个按钮,直接按名字或 ID 定位,不需要猜坐标。
官方强调的三个好处:不依赖视觉循环、确定性程序控制、token 开销显著更低。
三、我实测了那个差距
口径先说清楚:图像 token 按像素数除以 750 估算,这个系数在几个主流厂商的文档里都能对上量级;树结构我拿不到真正的 UIA 树(本机 PowerShell 加载 UIAutomationClient 被安全策略拦了),改用同一页面的 HTML 里可交互元素提取出扁平节点列表来近似。
结论是这个量级差得明显,但绝对值要打折看。
img_tokens = round(w * h / 750)            # 截图路线
tree_text = json.dumps(tree, ensure_ascii=False, separators=(",", ":"))
tree_tokens = round(len(tree_text) / 4)    # 树路线,按字符数估
实测一个 1280×800 的页面:
截图:1280x800 = 1,024,000 像素
  按像素/750 估算:约 1,365 token

无障碍树:提取到 16 个节点
  序列化后 1,038 字符
  按字符/4 估算:约 260 token

比值:截图是树结构的 5.2 倍
16 个节点对应那个页面的可交互元素。也就是说,同样一屏信息,读结构比读像素便宜五分之四。
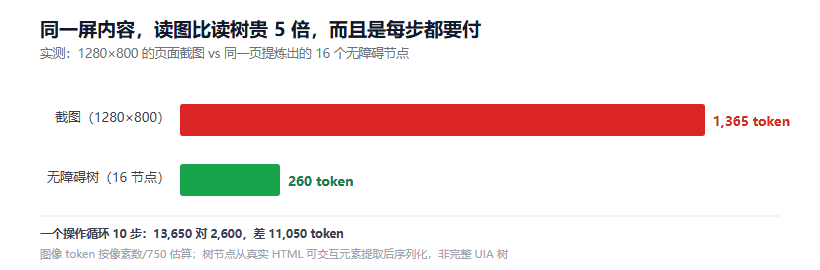
图 1:单步差距 5 倍,一个 10 步的循环就是 13,650 对 2,600
这个页面本身很简单。换成后台管理界面、IDE、财务软件这类控件密密麻麻的场景,节点数会涨到几百,但截图 token 只跟分辨率有关,还是 1,300 多。界面越复杂,树路线的相对优势越大。
四、省 token 是副产品,确定性才是主菜
这点我想强调,因为大部分讨论都停在成本上。
用树路线,一次点击是这样的:找到 role 为 button、name 为"提交"的节点,拿到它的中心坐标,点。整个过程里没有任何"猜测"。
用截图路线,同样一次点击是:看这张图,找到看起来像提交按钮的区域,估计中心坐标在大概哪。每一步都在猜。
区别在失败模式上。树路线找不到节点会明确报错"没有这个元素",你能立刻知道界面变了。截图路线找不到会给你一个"看起来最像"的坐标,然后点下去,可能点到别的地方,也可能什么都没发生。
一个是报错,一个是错着继续跑。 做自动化的人都知道,后者难查一百倍。
五、树路线也不是万能的
得说清它的天花板。
一,树里没有的东西它看不见。 颜色、图标样式、布局是否错乱、有没有渲染异常,这些都在视觉层,无障碍树里没有。要判断"这个页面看起来对不对",还是得看图。
二,跨平台差异大。 Windows 的 UIA、macOS 的 AX、Linux 的 AT-SPI 是三套东西,节点的角色命名、属性、层级结构都不一样。写一次跑三平台,中间的适配工作量不小。
三,应用质量参差不齐。 无障碍支持做得好的应用(系统自带的那批、大多数原生应用),树描述得很完整;做得差的,尤其是不少 Electron 应用和自绘界面的软件,树里全是无名的 Panel,找不到任何有用的东西。
第三条我认为最现实。你没法要求所有目标应用都有良好的无障碍支持,这直接决定了这套方案在什么场景能落地。
六、什么时候用哪条
我的判断标准是看目标应用的无障碍支持质量。
先用树试。 写十行代码枚举一下目标窗口的节点,如果能看到有名字、有角色的按钮和输入框,就走树路线。这一步花十分钟,能省掉后面一堆坑。
树不可用时退到截图。 Electron 应用、游戏、自绘界面属于这一类。这种场景下截图是唯一选择,成本只能接受。
混合是常态。 用树定位元素,用截图做视觉验证(比如确认操作之后页面确实变了)。两个信息源互补,比单用任何一个都稳。
七、坑清单
1. 只按名字找节点,遇到重名就错。 一个界面上三个"确定"按钮很常见。要带上层级路径或者父节点 ID 一起定位。
2. 树是快照,操作后不刷新。 点完一个按钮,界面变了,你手里的节点列表就过期了。每次操作后必须重新取树,不能复用。
3. 隐藏元素也在树里。 有些应用会把不可见的控件保留在树中(只是标记为不可见)。不检查可见性状态就点,会点到看不见的地方。这类元素通常点不动,但报错信息很误导。
4. 树太深,一次取全量会爆。 复杂应用的完整树可能有上万个节点,序列化后几十万字符。要按层级懒加载,只取当前屏幕附近的几层。
5. 权限问题在 macOS 上特别明显。 读无障碍树需要用户手动授予辅助功能权限,没授权时接口静默返回空树,不报错。这个坑会让人以为是代码写错了。
八、边界
我这篇的实测用的是 HTML 提取的近似结构,不是真正的 UIA 树,节点数偏少,token 数偏低。真机上读到的 UIA 树会更大、更啰嗦,实际比值会比 5.2 倍小一些。这个差距我标注为存疑,有条件的话应该在真机上重测。
另外 agent-desktop 本身我没跑起来,只读了它的设计说明和开源仓库的描述。它是一个 Rust 的 CLI 加 C 库,用法应该是给编码 Agent 提供一组命令来查询和操作界面元素,具体接口我没验证。
站里之前写过 Frida 动态注入,那是从进程内部看一个程序;这篇是从操作系统层面看一个程序的界面。两个视角解决的是不同问题,一个是"它内部怎么跑",一个是"它表面长什么样"。
参考资料
- Communeify - 11 月 1 日 AI 日报,含 agent-desktop 1.0.2 发布说明
- Vercel Labs - agent-desktop 开源仓库
- Microsoft 文档 - UI Automation 树结构概述
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。