
一句话总结:为了赶欧盟 AI Act 十二月的期限,Anthropic 把文本水印回填到 Claude Mythos 5、Opus 4.7、Opus 4.6、Sonnet 4.6 四个模型上。它在客户邮件里自己写明:Opus 4.6 和 Sonnet 4.6 这两个,只有在 temperature、top_p、top_k 三个采样参数保持默认时才带水印。而 Opus 4.6 恰好是它自家认为写得最好的模型。
一、先看清楚这次动了什么
10 月底 Anthropic 给 API 客户发了一封邮件,说要把文本水印扩到四个模型上。理由是欧盟 AI Act 十二月生效,要求供应商对 AI 生成内容做标识。
在这之前,2026 年 8 月 2 日之后发布的模型出厂就带水印,客户关不掉。Opus 5.5 这些新模型已经在了。这次补的是历史遗留,Mythos 5、Opus 4.7、Opus 4.6、Sonnet 4.6。
技术上它用的是 Google DeepMind 的 SynthID 文本方法的变体。原理是在选词时微调随机性,让输出带一个统计上可检测的模式。
官方给的四条说明都是"不"字句:不加字符也不加 token、不影响定价、不改请求响应格式、几乎不影响输出速度。还额外强调了一句——水印里不含用户、组织或对话的任何信息。
有关隐私这条,对企业的意义比前几条都大。它意味着水印不是溯源工具,只能回答"这段是 AI 写的吗",回答不了"是谁让 AI 写的"。
二、漏洞是官方自己说出来的
这部分最值得注意的地方不是漏洞本身,是它出现的位置:Anthropic 在发给客户的邮件里主动写明。
在 Opus 4.6 和 Sonnet 4.6 上,水印只在 temperature、top_p、top_k 三个参数保持默认值时才生效。改动其中任意一个,水印就不嵌入了。邮件里还附了一句提醒:如果你依赖水印来满足自己的合规要求,请把这三个参数保持默认。
同样这封邮件,对 Mythos 5 和 Opus 4.7 就没加这个限定。这个差别暗示那两个模型的水印不受采样参数影响,但 Anthropic 没有解释技术上的原因。
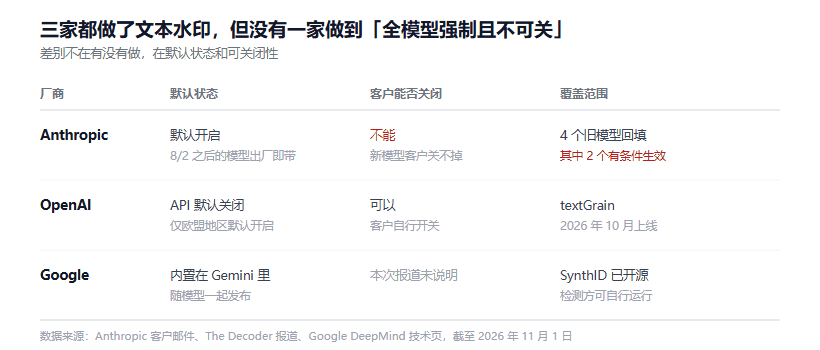
图 1:三家主流厂商的文本水印策略对比。差别不在有没有做,在默认状态和可关闭性
三、为什么偏偏是这两个模型
如果只是技术遗留,这件事不值得单独拎出来。问题在于 Opus 4.6 的位置很特殊。
按 Anthropic 自己的说法,Opus 4.6 到目前仍是它最强的写作模型,甚至在写作这一项上超过 Opus 5.5。也就是说,最可能被拿去生成大量正式文本的那个模型,正好是水印可以被一行配置改掉的两个之一。
而且改动采样参数不是为了绕水印,是为了调效果。写创意文案要调 temperature,要收紧输出分布要调 top_p。这些是很常规的调参动作,顺手就把水印弄没了,很多人根本不会意识到。
我认为这才是这个漏洞的真实风险形态。它不是有人故意绕过,是正常调参顺手擦掉的。 前者是作弊,后者是事故,后者更常见也更难发现。
四、对合规工作流的实际冲击
如果你所在的公司正在搭"AI 内容合规检测"这条流水线,这次的事情暴露一个前提错误。
很多团队的假设是:只要用的是 Claude,输出的文本就一定带水印,检测不到水印就说明不是 AI 写的。
这个假设在两个旧模型上不成立。当调用方为了效果调过参数,输出就不带水印,检测结果为阴性。但这不代表内容不是 AI 生成的。假阴性会让整套审计结论失真。
Anthropic 目前提供的解法是:一个检测 API 还在私密预览阶段,加上一段文字提醒客户保持默认参数。没做技术修复。
这个处理方式我能理解,改旧模型的推理路径风险不小。但它把责任转移给了使用方:合规能不能成立,取决于你有没有读那封邮件。
五、三家的策略差在哪
把三个厂商并排看,能看出这不是技术路线之争,是产品策略之争。
Anthropic 的思路是默认强制。八月之后的新模型关不掉,旧模型回填。代价是两个旧模型上有条件生效。
OpenAI 的 textGrain 十月上线,API 客户默认关闭,全球只有欧盟地区的 ChatGPT 和 Codex 用户默认开启。这个设计明显是在合规成本和用户体验之间找平衡,但同样意味着离开欧盟,默认状态下你是检测不到水印的。
Google 选了另一条路:把 SynthID 文本版开源,内置到 Gemini 里。开源的好处是检测方可以自己跑,不必依赖厂商的 API;坏处是规则公开,理论上更容易被针对性处理。
三种做法各有各的算盘,共同点是:没有一家做到"全模型、全参数、默认强制、客户不可关"。 这条线目前没人跨过去。
六、一个我认为被低估的质疑
技术作者 John Gruber 提了一个角度,我觉得比"能不能绕"更值得讨论。
他的意思是:水印的做法是按密钥去选词,而不是按语义最合适去选词。可同义词的语义并不完全等价,为了嵌水印而选一个次优的词,精度必然下降,只是降多少的问题。
Anthropic 说的是"不改变意义、质量和可读性"。这个表述和"精度不下降"不是一回事。质量是主观感受,精度是可以量化的。目前没有看到第三方对带水印输出做质量对比,这一项我标存疑。
还有一层来自法律行业的担忧:客户明确禁止用 AI 的律所,如果交付物被检测出 AI 水印,麻烦不小。反过来,一份文档里叠了多个厂商的水印,检测结果可能互相干扰。这些场景现在都还没有明确规则。
FAQ
水印会影响我拿到的文本质量吗?
官方说法是不影响意义、质量和可读性,也不加 token。第三方独立对比还没看到,我持保留态度,这项目前只能算厂商自述。
我能关掉水印吗?
新模型(八月二日之后发布的,包括 Opus 5.5)关不掉。四个回填的旧模型里,Mythos 5 和 Opus 4.7 没有说明可关;Opus 4.6 和 Sonnet 4.6 在非默认采样参数下不生效。
水印能查出是谁写的吗?
不能。官方明确说不含用户、组织、对话信息。它只标识"AI 生成",不做溯源。
怎么检测一段文本有没有水印?
Anthropic 的检测 API 还在私密预览。Google 的 SynthID 文本版是开源的,可以自己跑,但它检的是 Google 自家的水印规则。
这对企业合规意味着什么?
不要把"检测不到水印"等同于"不是 AI 生成"。要拿到可靠结论,得固定调用参数并留日志,用日志证明输出条件,而不是靠检测结果反推。
结语
这次的事情有个挺好的样本价值:它展示了合规落地时的典型形态——规则到位了,技术实现打了折,责任落到了使用方读不读邮件上。
欧盟十二月的期限快到了,接下来会有一批类似的"先合规再说"的动作。判断一家厂商是不是真做扎实了,看一个指标就够:它敢不敢公布漏洞。
Anthropic 这次主动写进客户邮件,这一点我认为是加分项。但把参数条件写在邮件里而不是修掉,说明它自己也清楚,这不是技术问题,是取舍问题。
参考资料
- AI in Context - 水印漏洞的技术条件与官方邮件内容
- The Value Engineering - 企业合规工作流受到的影响分析
- Pondero - 11 月 1 日 AI 安全与工具动态汇总
- Google DeepMind - SynthID 文本水印技术说明
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。