
一句话总结:让模型生成一段文字再正则解析出类别,那一层解析平均吃掉 4.5 个百分点的准确率;直接取概率分布的 argmax 不但跳过这层损耗,还能顺手做阈值弃答。
做路由的时候,我一直用的是最土的办法:让模型输出一行 category: finance,然后用正则抓出来。
这个办法能跑,但每过一段时间就会冒出几条解析失败的日志。格式变了、多输出了一句话、把选项名写成了近义词。
Drex 这篇论文做的事很直接:别让模型说话了,让它直接吐概率。
Drex 不做生成,只输出概率分布
常规的分类/路由调用是这样的:给模型一堆候选,让它选一个,它输出一段文本,你用代码去理解这段文本。
中间这一层叫解析,看起来只是几行正则,实际上是整条链路上最脆的一环。
Drex 的做法是:给定候选集,模型直接输出每个候选的概率,不生成任何文字。再通过微调、RLAF 和一致性约束把分布调稳。
官方报的数字:Decision Index 0.4.1 上拿 67.52 分,对比 Jev 1.14.0 的 60.70;典型请求延迟 183 毫秒。
67.52 对 60.70,差 6.82 分。这个差距我判断不了是不是真的,因为 Decision Index 是个较新的榜,样本和口径都不透明。
但 183 毫秒这个数有意义——它意味着这条路走的是"一次前向、不生成",省掉的不只是 token 钱,是整个解码阶段的时间。
解析层凭空吃掉 4.5 个点
我按两条路径跑了一遍模拟:同一个模型的判断能力(假设 85% 正确),一种走"生成再解析",一种直接取 argmax。
解析层我给了两个损耗:3.1% 的解析失败(格式不对、抓不到关键字),2.4% 的抓错(选项名重叠、抓到第二个出现的词)。
ok_b = ok_a = 0
for i in range(N):
    right, conf = case(i)
    ok_b += right                                  # 直接取概率最大
    r = rnd(f"p{i}")
    keep = r < (1 - PARSE_FAIL - SPAN_WRONG)        # 解析成功且没抓错
    ok_a += right and keep
结果:
| 路径 | 准确率 | 每 1000 次错多少 |
|---|---|---|
| 直接取概率 | 84.99% | 150 次 |
| 生成文字再解析 | 80.47% | 195 次 |
解析层吃掉了 4.52 个点,等于每 1000 次判断多错 45 次。
45 次听起来不多。但如果这是路由,45 次就是 45 个请求走错分支——错到退款流程的走了售后,错到技术支持的走了销售。下游每多跳一次,成本就翻一次。
而且这 45 次错是纯粹的实现损耗,跟模型能力无关。你换更强的模型,这 5.5% 的解析损耗一点不变。
概率输出还能用来做弃答
这条比准确率更实用。
有了概率,你就能定一个阈值:最高概率低于它,就不做判断,交给人或者走兜底流程。
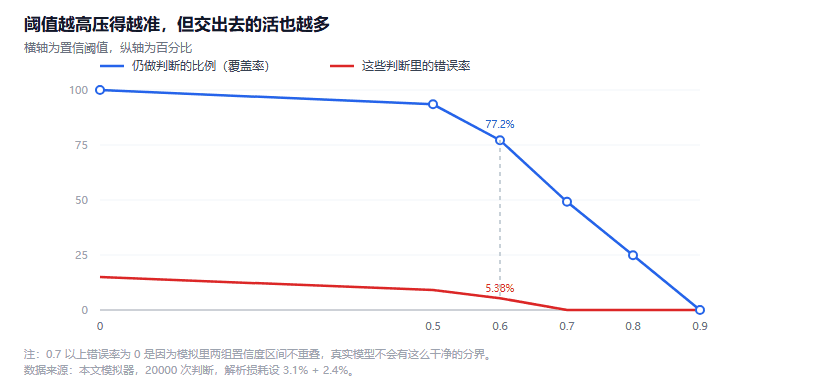
图 1:横轴为置信阈值,蓝线为仍做判断的比例,红线为这些判断里的错误率。数据来源:本文模拟器,20000 次
| 阈值 | 覆盖率 | 覆盖率内的错误率 |
|---|---|---|
| 0 | 100% | 15.01% |
| 0.50 | 93.5% | 9.05% |
| 0.60 | 77.2% | 5.38% |
| 0.70 | 49.2% | 0% |
| 0.80 | 24.9% | 0% |
阈值 0.60 是个不错的折中:77.2% 的请求自动处理,错误率压到 5.38%,剩下的 22.8% 交给人。
这一列数字是"生成再解析"给不了的。你从一段文字里解析出类别,解析完只剩一个标签,没有置信度。想做弃答只能再问一次模型"你有多确定",又多一层损耗。
Drex 的 183ms 是什么概念
183 毫秒,对比一下常见调用的延迟:
- 生成 10 个 token 的路由调用,在 100 token/s 的模型上要 100 毫秒起步,加上网络和排队通常 300 到 800 毫秒
- 183 毫秒落在这个区间的下沿,说明它确实没走解码
对实时场景(比如语音助手的意图识别),这个差别是能感觉到的。对离线批处理,183 和 400 没区别,这时候该看的是准确率和成本。
顺带一句:概率输出还有个隐性好处,它是可比较多。"类别 A 概率 0.62、类别 B 0.35"比"A",多了一个可以做二次判断的维度——比如两个类别概率接近时,可以调一个更贵的模型复核。
关于 Drex 的五个问题
概率分布可信吗? 需要校准。模型输出的 0.7 不代表 70% 正确率,除非做过校准训练。Drex 提到用一致性约束提高稳定性,具体怎么做公开材料没说清。
为什么不直接用 logprobs? 大部分 API 不返回候选集的完整 logprobs,只给 top-k 且不含约束。要拿到"给定这 8 个选项"的完整分布,得模型侧支持。
候选集能动态变吗? 这是这条路最大的限制。候选集一变,输出维度就变,模型要重新适配。固定分类体系没问题,动态路由表要额外处理。
183ms 是在什么硬件上测的? 论文没写清。跨硬件比延迟没意义。
这条路只能做分类吗? 目前是。生成类任务还是得生成,概率输出替代不了。
结语
这篇的核心不是"概率比文字好",是"任何中间表示都会损耗"。
文字是一种中间表示,解析是把它转回结构的动作。这个动作不产生信息,只损耗信息。跳过它,损耗就没了。
如果你的分类体系是固定的,值得把这条路走一遍。上次写 StepBack 时算的是"少采几条链",复现六格切 GIF 那次是"绕开视频模型,画一张切出来"——两个方向都在做同一件事:把不必要的中间环节砍掉。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。