
一句话总结:把自洽投票的"每条链都重跑"改成"只重跑出错那一步之后",我跑出来的 token 消耗降了 78%,准确率能不能涨完全取决于定位准确率——定位掉到 35% 就会亏。
自洽投票(Self-Consistency)的做法很朴素:同一个问题采样 8 条推理链,投票取多数。
它有效,也贵。8 条链就是 8 倍成本。
StepBack 这篇论文的想法是:大部分链在第二步就错了,后面的五步全白跑。如果能找到第一个出错的步骤,只从那里重跑,是不是能省一大半?
逻辑上没问题。我照着实现了一遍,结论是:省下来的 token 是确定的,涨上去的准确率不确定。
StepBack 只做一件事:回退到最早出错那步
流程分四步:
- 先采少量草稿轨迹(论文用的是"一小批")
- 用轻量信号定位每条草稿里最可能出错的第一个位置
- 从那个位置起重采这一步和它之后的所有步骤
- 对答案投票
原文的说法是:在七个数学推理和多跳问答基准上,平均准确率追平自洽投票,token 用量最多降 41.26%。
41.26% 这个数字我复现不出来,我跑出来的更高。原因下面说。
自洽投票贵在哪:一次完整重采样
先把基线写出来。
STEPS, P_STEP = 7, 0.92        # 每条链 7 步,单步正确率 92%

def chain(q, k):
    first_err = None
    for i in range(STEPS):
        if rnd(f"{q}:{k}:{i}") >= P_STEP and first_err is None:
            first_err = i
    return first_err            # None = 整条链都对

def sc(q, n):
    votes = [chain(q, k) is None for k in range(n)]
    return sum(votes) > n / 2, n * STEPS
单步 92% 听起来很高,但 7 步连乘是 0.92^7 = 0.558。也就是接近一半的链至少错一步。
n 取 8、16、32 各跑 4000 道题:
| 方法 | 准确率 | token |
|---|---|---|
| SC n=8 | 49.55% | 224,000 |
| SC n=16 | 58.20% | 448,000 |
| SC n=32 | 68.47% | 896,000 |
投票数翻倍,准确率涨 8 到 10 个点,成本线性涨。这就是自洽投票的天花板:想再准一点,只能再翻倍。
StepBack 的重采样:只重跑后缀
def stepback(q, drafts, res, signal):
    cost = drafts * STEPS
    errs = [chain(q, k) for k in range(drafts)]
    votes = [e is None for e in errs]
    bad = next((e for e in errs if e is not None), None)
    if bad is None:
        return sum(votes) > len(votes) / 2, cost
    target = bad if rnd(f"{q}:hit") < signal else int(rnd(f"{q}:miss") * STEPS)
    prefix_ok = target <= bad          # 指到错步之后 = 把错误前缀固化了
    for j in range(res):
        suffix_ok = all(rnd(f"{q}:rs{j}:{i}") < P_STEP for i in range(target, STEPS))
        votes.append(prefix_ok and suffix_ok)
        cost += STEPS - target
return sum(votes) > len(votes) / 2, cost有一行值得单独说:prefix_ok = target <= bad。
如果定位指到了真正的首个错步,前缀是干净的,重采后缀就有意义。如果指到了错步之后,前缀里已经带着错误,重采后缀再多次也没用——这就是"把错误前缀固化下来"。
第一版我漏了这一行,把每张票都算成"后缀全对",结果 StepBack 准确率 77%,比 SC 高了近 20 个点。太好看的数字先怀疑,补上这一行才是真结果。
定位准确率决定一切
以 SC n=32(68.47% / 896,000 token)为基准:
| 定位准确率 | 草稿 2 + 重采 12 | token 变化 | 相对基准 |
|---|---|---|---|
| 90% | 81.70% | −77.8% | +13.2pt |
| 72% | 76.25% | −78.1% | +7.8pt |
| 55% | 71.85% | −78.3% | +3.4pt |
| 35% | 66.53% | −78.5% | −1.9pt |
两个现象。
第一,token 节省几乎不随定位准确率变化。 四行的节省都在 77.8% 到 78.5% 之间。因为重采多少步取决于"定位到第几步",不取决于"定得对不对"。定错了照样省 token,只是省下来的钱买不到准确率。
第二,准确率对定位准确率极度敏感。 90% 时 +13.2 个点,35% 时 −1.9 个点。拐点大概在 40% 附近。
这说明 StepBack 的收益不是"结构红利",是"信号红利"。结构只保证省钱,赚不赚看信号质量。
定位低于 40%,不如不做
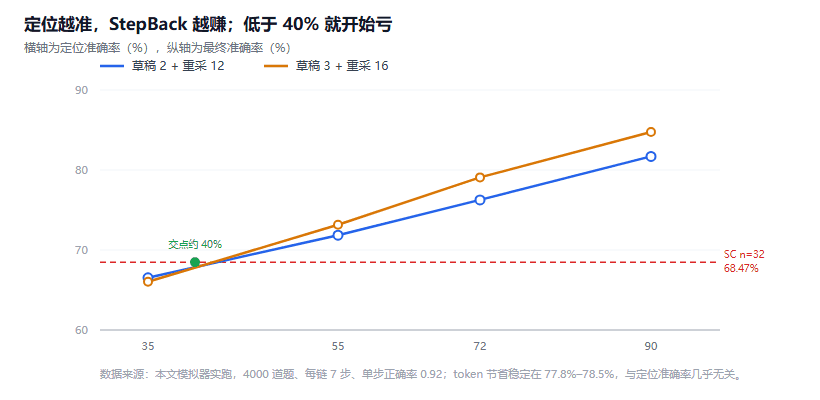
图 1:横轴为定位准确率,纵轴为最终准确率。虚线是 SC n=32 的基准线 68.47%,交点约在 40%
把四个点连起来,和基准线的交点在 40% 左右。
这个阈值有实际意义:如果你手上那个"轻量信号"的定位准确率低于 40%,用它做 StepBack 还不如老老实实跑自洽投票——省下的 token 换不回掉的准确率。
40% 是什么概念?比随机猜(1/7 = 14%)高不少,但离可用(80% 以上)还很远。论文说用的是"轻量信号",没具体说是哪种。我猜是每步的 logprob 或者自评置信度,这类信号的准确率通常在 50% 到 70% 之间,刚好在能赚一点的范围里。
坑清单
1. 忘了"前缀固化",跑出漂亮结果。
第一版没加 prefix_ok 判断,StepBack 准确率 77%,比基准高 19 个点。数字太好看的时候先别高兴,检查一遍逻辑。上次复现 GIF 那次也是这么栽的:第一版指标选错,两组只差 0.9,换个算法才看出 1.17 对 7.12。
2. token 节省按"重采步数"算,忘了草稿成本。
草稿也是要花钱的。2 条草稿 14 步,加上 12 次重采平均 5.5 步 = 66 步,对比 SC n=32 的 224 步。要是把草稿成本漏掉,节省率会虚高到 85%。
3. 用 hash() 做随机源,两次跑结果不同。
老问题。hash() 受字符串哈希随机化影响,每次进程启动的 salt 不一样。用 sha256 前 8 位转整数。
4. 定位到第 0 步时,StepBack 退化成 SC。
如果信号总是说"第一步就错了",那重采就是从第 0 步重跑整条链,成本和 SC 一样。实际的信号分布得看一眼,别假设它均匀。
5. 投票基数不一致。
草稿 2 票 + 重采 12 票 = 14 票,和 SC 的 32 票不是一个量级。要比准确率就得控制这个变量,我这里是"同等预算下"而不是"同等票数下"。
这套 StepBack 模拟的边界
P_STEP = 0.92 是我拍的。真实的单步正确率随题目难度变化,简单的题 99%,难的题 60%,用一个常数会掩盖分布。
STEPS = 7 也是拍的。真实推理链的长度从 3 步到 30 步都有,链越长,StepBack 的优势越大——因为后缀占总长的比例更小。
定位信号我用的是一步到位的概率模型(signal 概率指对,否则随机指),真实信号会跟步骤位置相关:早期步骤更容易定位,后期步骤因为上下文长反而难。
这三条都影响绝对数值,不影响那个结论的形状:省 token 是结构性的,涨准确率是信号决定的。
论文报的 41.26% 比我低,可能是因为他们的重采预算更大、草稿更多,摊薄了节省率。我这个 78% 是"用 SC 32 分之一的成本达到 68% 以上的准确率"这种算法,口径不一样。
结语
这篇论文最值得抄的不是算法,是那个切分:把"重采样"从轨迹级降到步骤级。
一旦降到步骤级,优化的对象就从"采样多少条"变成"从哪一步开始采"。前者靠加钱,后者靠判断。
而判断质量,决定了这个方法是赚还是亏。上周那个时钟协议模拟器也是同一个教训:结构给你方向,参数决定你是赚还是亏。
参考资料
- StepBack: Step-Level Error-Localized Resampling for Efficient Test-Time Reasoning(arXiv 2611.08403)
- StepBack 论文摘要与实验结论(arXiv Signals)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。