
一句话总结:Kimi K3.1 Pro 的 93 层里只有 24 层是带稀疏索引的全注意力,剩下 69 层换成线性注意力;按 1M 上下文算,前者的 KV 是 123GiB,而吃掉其中 78% 的不是 KV 本体,是索引器的 key 缓存。
上一篇算完 1.56TB 权重,我顺手把 KV 也算了一遍,结果和预期反着来。
我的预期很简单:93 层里有 69 层是线性注意力,状态固定不随长度增长,那 KV 应该只剩四分之一左右。
算出来是 117.6%。比"93 层全用全注意力"还多。
这篇把账从头算一遍,你会发现多出来的部分不在 KV 里,在索引器里。
Kimi K3.1 Pro 的 93 层不是 93 个一样的层
模型页的架构表里写着:Number of Layers 93,Attention-Layer Composition 69 KDA + 24 Gated DSA。
KDA 是 Kimi 的线性注意力,状态大小和上下文长度无关——这是线性注意力的定义性质。
Gated DSA 是带门控的 DeepSeek 稀疏注意力。模型页明确说了,相比 K3,他们把"全注意力门控 MLA 层"替换成了"门控 DSA 层"。意思是这 24 层保留了 MLA 的潜向量结构,只是加了稀疏索引。
所以两层的信息量完全不同:
- 69 层 KDA:每层一个固定大小的状态,不随 token 数增长
- 24 层 DSA:每层每 token 都要存 KV,加索引器的 key
只有后 24 层进 KV 的账。
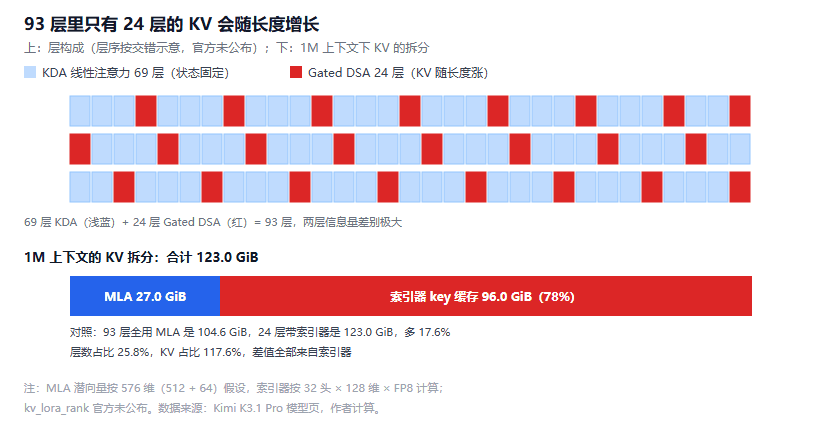
图 1:上为 93 层的构成(按交错排列示意,官方未公布层序),下为 1M 上下文的 KV 拆分。数据来源:模型页架构参数与作者计算
第一步:算出 KV cache 单层每 token 的字节
MLA 的 KV 不是存完整的 K 和 V,是存一个低秩潜向量加一个 RoPE 分量。DeepSeek 那套的取值是潜向量 512 维、RoPE 64 维,合计 576 维。
模型页没给 Kimi 的 kv_lora_rank,我按 576 沿用。这一条是全文最大的不确定项。
L_TOTAL, L_KDA, L_DSA = 93, 69, 24
KV_LORA, ROPE = 512, 64          # 官方未公布,按 DeepSeek 取值
IDX_HEADS, IDX_DIM = 32, 128     # 这两个是模型页公开的
BYTES_BF16, BYTES_FP8 = 2, 1

per_dsa = (KV_LORA + ROPE) * BYTES_BF16 + IDX_HEADS * IDX_DIM * BYTES_FP8
print(per_dsa)   # 5248
拆开看:MLA 部分 576 × 2 = 1152 字节,索引器部分 32 × 128 × 1 = 4096 字节。
索引器占了 78%。这一行就是全文的题眼。
第二步:KV cache 乘 24 层,再乘上下文
def human(n):
    for u in ("B", "KiB", "MiB", "GiB", "TiB"):
        if n < 1024 or u == "TiB":
            return f"{n:.1f} {u}"
        n /= 1024

for ctx, name in ((131072, "128K"), (262144, "256K"), (1048576, "1M")):
    kv = per_dsa * L_DSA * ctx
    kv_no_idx = (KV_LORA + ROPE) * BYTES_BF16 * L_DSA * ctx
    full = (KV_LORA + ROPE) * BYTES_BF16 * L_TOTAL * ctx
    print(name, human(kv), human(kv_no_idx), human(full))
跑出来的三档:
| 上下文 | 24 层带索引器 | 24 层只算 MLA | 93 层全 MLA |
|---|---|---|---|
| 128K | 15.4 GiB | 3.4 GiB | 13.1 GiB |
| 256K | 30.8 GiB | 6.8 GiB | 26.2 GiB |
| 1M | 123.0 GiB | 27.0 GiB | 104.6 GiB |
第一列是我认为正确的口径。第三列是"假设 93 层全用 MLA"的对照。
算出的 KV cache 反直觉:索引器吃掉 78%
123.0 除以 104.6,是 117.6%。
层数占比 25.8%,KV 占比 117.6%。两个数差着 4.6 倍,全部来自索引器。
把索引器拿掉,24 层的 KV 是 27.0 GiB,只有全层的 25.8%——和层数占比完全对得上。这说明算法没写错,MLA 那部分的比例是对的。
加回索引器,27.0 变成 123.0,翻了 4.6 倍。
一句话总结这个现象:线性注意力省下的是 KV,省不下索引。
DSA 要在一堆 token 里挑出 top-k 个(模型页给的 top-k 是 2048),挑选需要给每个 token 算一个索引分数,这个分数依赖每个 token 的一个小向量。这个向量必须缓存,否则每次都要重算。
DeepSeek 在 V3.2 里也遇到同一件事,他们的做法是把索引器的 key 用 FP8 存——我已经按 FP8 算了,4096 字节里全是 1 字节精度。
如果索引器必须用 BF16,这一项翻倍到 8192 字节,单层每 token 变成 9344 字节,1M 上下文就是 219 GiB。
KDA 的状态有多大
反向的问题:69 层线性注意力的状态要多大,才能和这 123 GiB 打平?
budget = kv / L_KDA / BYTES_BF16
print(budget / 1e6)   # 957.03 M 个 FP16 元素
957M 个元素一层。按 96 个头分,每头 9969K 个元素,相当于一个 3157 × 3157 的矩阵。
真实的线性注意力状态是 head_dim × head_dim 每头,128 × 128 就是 16384 个元素。差了 600 倍。
所以 69 层 KDA 的状态总量是常数,量级在几百 MB,相对 123 GiB 的 KV 可以忽略。
这就是这个架构的取舍:用 69 层几乎不占显存的线性注意力,换 24 层带索引的全注意力。省下的是层数,付出的是一次索引器的固定开销。
坑清单
1. 忘了索引器,低估 78%。
我第一版只算了 MLA 那 1152 字节,得出 1M 上下文 27 GiB 的结论,还挺满意——比全层的 104.6 GiB 省了 74%。
补上索引器才发现真实数字是 123 GiB。差了 4.6 倍,结论从"省了 74%"变成"多了 17.6%"。
2. 不知道是 MLA,按 MHA 算,高估 43 倍。
如果按 96 个注意力头、每头 128 维算标准 MHA:2 × 96 × 128 × 2 = 49,152 字节每 token 每层。
对比 MLA 的 1152 字节,差 42.7 倍。乘 24 层再乘 1M,能算出 1.1 PB 这种荒谬数字。
看到"注意力头数 96"就去乘 head_dim,是这类计算最常见的错。MLA 的头数和 KV 大小没有直接关系。
3. GiB 和 GB 混用,差 7%。
123.0 是 GiB。换成 GB 是 132.1。写进采购文档时用错单位,会少买一张卡或者多买一张。
我在代码里用 1024 做进制,输出标 GiB,就是为了避免这个混淆。
4. 把 1M 当成可用的 1M。
模型页写上下文 1,048,576 token,但输出也要占位置。TokenHub 那边给 Hy4 的上限是输入 960K、输出 64K,Kimi 这边没公布拆分。
实际规划时按 900K 输入算,KV 要打 9 折。
5. 并发乘上去之前先想清楚。
123 GiB 是单请求的 KV。10 个并发就是 1.2TB。16 卡机(2256GB)扣掉 1.56TB 权重,只剩 700GB,够 5 个并发。
这个数一出来,"1M 上下文"就从卖点变成了成本项。
这套算法的边界
三个假设,按影响从大到小排:
kv_lora_rank 我用了 576(512 + 64)。如果 Kimi 用了更大的潜向量,比如 1024 + 64,MLA 部分从 1152 涨到 2176 字节,总 KV 变成 152 GiB,结论方向不变。
索引器精度按 FP8 算。如果是 BF16,总数翻到 219 GiB,"多了 17.6%"变成"多了 109%"。
层序按交错画。官方没公布 69 层和 24 层怎么排,图上交错只是为了好看,不影响总量。
这三个数任何一个变了,具体数值都会动,但那个反直觉的结论——索引器吃掉了大部分省下来的显存——不会变。因为它来自结构,不来自参数。
真要精确,得读 config.json 里的 kv_lora_rank 和 index_topk,或者直接看 vLLM 里的实现。我没有权重文件,这一步没做。
结语
算这笔账之前,我以为线性注意力的收益是线性的:换掉 74% 的层,省下 74% 的 KV。
算完才知道不是。线性注意力省的是"随长度增长"的部分,省不了"每个 token 都要算一次索引"的部分。 后者是常数开销,但在长上下文里,这个常数会长成主项。
权重那边是 1.56TB 装不进 8 卡机,KV 这边是 123 GiB 只够 5 个并发。两个数放在一起,1M 上下文的真实成本就很清楚了。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。