
一句话总结:研究者训练了一个 9B 的用户模拟器 MIMESIS,把它冻住当训练环境,其余流程一个字不改,agent 在九个没见过的用户模型上的均分从 26.10 涨到 29.54,九个全部提升。
训练 agent 有一个绕不开的问题:陪练是谁。
你用真人陪练,贵、慢、不可复现;你用大模型陪练,便宜、快、但那个"用户"永远礼貌、永远配合、永远把需求说清楚。
真实用户不这样。真实用户说一半、改主意、前后矛盾、答非所问。
MIMESIS 这篇论文做的就是把陪练换成一个更不像 AI 的 AI,然后看学生能不能变强。
MIMESIS 要解决的是「拿什么当用户」
多轮 agent 的 RL 训练,标准做法是找一个强模型扮演用户。GPT-5.5 当用户,agent 跟它对话,按任务完成度给奖励。
问题在于,强模型扮演的用户有个系统性偏差:它太懂事了。你说"帮我订个位子",它会补齐时间、人数、地点;真实用户可能只回一句"随便"。
用这种陪练训出来的 agent,到了真实场景会崩——不是因为它笨,是因为它没见过"不配合"的输入。
MIMESIS 的思路是把"用户"当成一个独立的建模对象:单独训一个模型专门演用户,训到连判别器都分不出来。
用户模拟器:风格像不等于难识破
这里有个反直觉的发现,论文用两套基准测出来。
一套叫风格打分(满分 5 分),评的是"这段对话读起来像不像真人"。Claude-Opus-5 拿了 3.92,是所有被测模型里最高的。
另一套测"能不能被识破",用 Turing 距离衡量,越低越难识破。MIMESIS-9B 是 38.7,全场最低。
两个排名不一致。
也就是说:一个对话"风格很到位",不代表它真的难以被识破。风格打分看的是局部措辞得不得体,识破检测看的是整体的对话气质——什么时候该反问、什么时候该沉默、什么时候该说"我也不知道"。
这个区分很重要。它意味着用"人评像不像"来筛模拟器是不够的,得用对抗检测。
把用户模拟器冻住,当训练环境
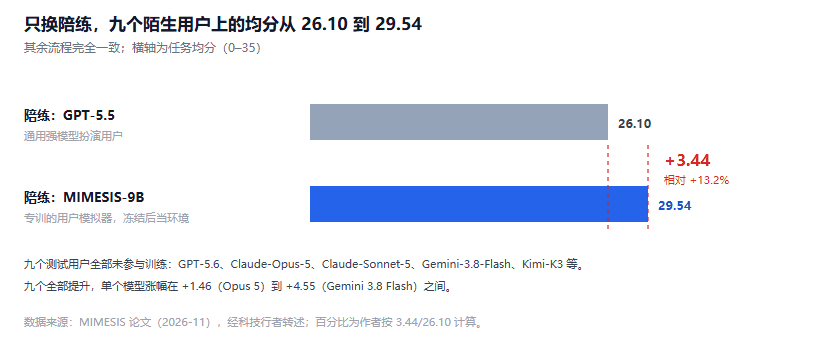
图 1:其他流程完全一致,只替换陪练模型;右侧为九个未参与训练的陌生用户模型上的均分。数据来源:MIMESIS 论文,涨幅区间取自文中报告的最小与最大值
训练分两步。
第一步,把 MIMESIS 训好,然后冻结。冻结的意思是它的权重不再更新——它变成一个固定的环境,就像游戏里的关卡,不会因为玩家变强而变弱。
第二步,用一个叫 UserRL 的多轮强化学习框架,让 agent 和这个冻结的模拟器反复对话,按任务完成情况拿奖励。
冻结这一步是关键。如果模拟器也跟着学,它会不自觉地适应 agent 的策略,难度就塌了。这是所有 self-play 类方法的通病,MIMESIS 用"冻住对手"绕开了。
UserRL 换掉一个变量,9 个陌生用户全提升
测评设计得很干净:用九个完全没出现在训练过程里的用户模拟器测 agent。
九个里包括 GPT-5.6、Claude-Opus-5、Claude-Sonnet-5、Gemini-3.8-Flash、Kimi-K3,还有几个开源模拟器。
结果:训练时把 GPT-5.5 换成 MIMESIS-9B,其他流程一模一样,九个陌生用户上的均分从 26.10 涨到 29.54。
涨幅 3.44 分,相对提升 13.2%。
更关键的是"九个全部提升,没有一个例外"。涨幅最小的是 Claude-Opus-5 那组,+1.46;最大的是 Gemini-3.8-Flash 那组,+4.55。
九个全涨这件事,说明改进不是"碰巧匹配了某一个测试环境",是泛化。如果只有三四个涨,那就可能是在某个特定风格上过拟合了。
这个思路和上周写的时钟协议模拟器是一回事:把变量收到只剩一个,结论才敢下。变量一多,涨了也说不清是谁的功劳。
涨幅最小的那组,反而是最强的模型
+1.46 那组是 Opus 5。
这个细节值得想一想。为什么换成更真实的陪练,在 Opus 5 身上收益最小?
一个解释是:Opus 5 本身更像人,所以"陪练更像人"这件事对它边际收益低。另一个解释是:agent 在 Opus 5 面前的基线本来就高,天花板近。
论文没给这个归因。我只能说这两种解释都成立,也都没被排除。
反过来看 Gemini-3.8-Flash 的 +4.55:它是九个里最"不像人"的那个,所以换陪练的收益最大。这个方向是自洽的。
关于 MIMESIS 的五个问题
9B 的模拟器够用吗? 从结果看够用。它的 Turing 距离比 Claude-Opus-5 还低,说明"像人"这件事不一定要靠参数量堆。
为什么不用真人? 成本和可复现性。RL 需要百万次交互,真人做不到;而且真人会疲劳、会学习、会不一致,训练信号会漂。
这个方法能直接搬到生产吗? 训练侧可以,推理侧不行。MIMESIS 是训练环境的一部分,不是产品组件。
会不会训出"专门讨好模拟器"的 agent? 这是这类方法最大的风险。论文用九个陌生模拟器测泛化,就是在防这个。九个全涨说明这一步没塌。
26.10 到 29.54 是什么量级? 绝对值不高。这两个数字说明的是方向——同样的流程,换陪练能带来两位数百分比的相对提升。
结语
这篇论文的方法没有多新,价值在那个对照实验的设计:只换一个变量,在九个没见过的环境上测。
大部分 agent 论文的改进是复合的——改模型、改奖励、改数据、改流程,一起上,最后涨了 5 个点,说不清是哪一项的功劳。这篇把变量收窄到"陪练是谁",结论就很硬。
对我们做产品的人,这条结论可以直接用:评估 agent 的时候,别只用一种用户画像。PLE 那个基准的设计也是同一个逻辑,85 个任务摊到四个学科,就是为了让分数别停在单一场景的虚高上。 你用的那个模拟用户越礼貌,你测出来的分数越虚高。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。