
一句话总结:在一个 1000 题的题库里抽 100 题估总分,重复两万次,均匀抽样的误差有 5% 的概率超过 11.05 个点;而按难度分层抽样能把这个数压到 6.95,代价是要知道每道题属于哪一档。
很多榜单标注着"抽样自 XXX 基准"。
这句话背后的意思是:你看到的分数不是全量跑出来的,是从一个更大的题库里抽了一部分算的。抽多少?没写。抽得准不准?也没写。
我按最朴素的设定跑了一遍:1000 题的题库,抽 100 题,重复两万次,看估计值离真值多远。
结果比我预想的差。
为什么 100 道题的分数不可信
先造一个题库:五档难度,占比 50%、25%、15%、7%、3%,对应的通过率 95%、80%、50%、25%、10%。
真实总分 = 0.5×0.95 + 0.25×0.80 + 0.15×0.50 + 0.07×0.25 + 0.03×0.10 = 77.05%。
然后模拟"抽 100 题估分"两万次,记录每次的估计值和真值的绝对差。
| 指标 | 均匀抽样 |
|---|---|
| 平均误差 | 5.23 个点 |
| 中位数 | 5.05 |
| p75 | 7.05 |
| p95 | 11.05 |
| p99 | 14.05 |
| 最大 | 20.05 |
p95 是 11.05 个点。意思是:你每做 20 次评测,就有一次估出来的分数偏了 11 个点以上。
最大偏差 20.05 个点——真实 77 分,估成 57 或者 97 都有可能。
抽样误差的理论下限:8.2 个点
这个误差不是程序写错了,是抽样的数学性质。
100 道题、77% 正确率,二项分布的标准差是:
sd = √(0.7705 × (1 − 0.7705) / 100) = 0.0421 = 4.21 个点95% 置信区间的半宽 = 1.96 × 4.21 = 8.24 个点。
我跑出来的 p95 是 11.05,比 8.24 高,多出来的部分来自"题目难度分布不均"——均匀抽样偶尔会抽到太多难题或太多简单题,这一层额外的方差叠在二项噪声上。
所以 8.24 是地板。只要你还抽 100 题,误差就压不到 8 个点以下。
BestRand 压的不是平均值,是误差的尾巴
顺手看了另一篇论文,BestRand,做的就是这件事。
它的定位很明确:随机抽样虽然无偏,但"偶尔遇到大幅估计误差"这个尾巴太厚,不利于评测。所以设计了一种低成本采样方式专门压误差尾部。
作者在 70 多个文本、多模态和 Agent 基准上报告:高误差风险下降 50.2%,平均误差下降 16.4%,构建成本是对比方法的 51.3%。
我按最直观的思路试了一个版本:按难度分层抽样。
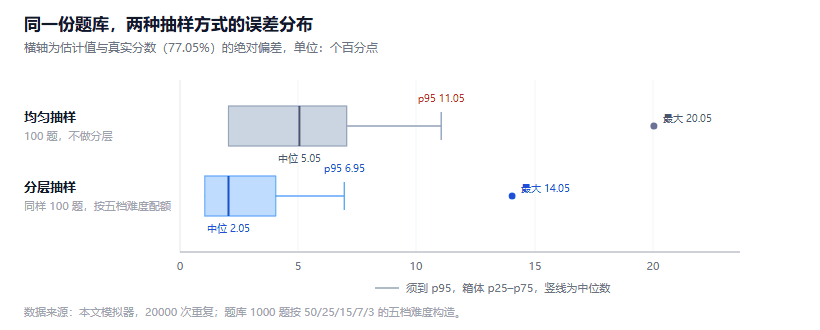
图 1:箱体为 p25–p75,中间竖线为中位数,须到 p95,散点为超出部分的最大值。数据来源:本文模拟器,20000 次重复
def stratified():
    picks = []
    for b in range(5):                      # 五档难度
        k = max(2, round(N_SAMPLE * W[b]))  # 按占比分配,每档至少 2 题
        pool = BUCKET[b]
        picks += [pool[int(rnd(f"s{b}{i}") * len(pool))] for i in range(k)]
    return picks
关键是 max(2, ...):最难的那一档只占 3%,100 题按比例只分到 3 题,如果题库再小一点就会分到 0 题——那这一档的难度信息就完全丢失了。"每档至少 2 题"是保底。
我复现的抽样误差:p95 从 11.05 降到 6.95
| 指标 | 均匀抽样 | 分层抽样 | 变化 |
|---|---|---|---|
| 平均误差 | 5.23 | 2.80 | −46.5% |
| p75 | 7.05 | 4.05 | −42.6% |
| p95 | 11.05 | 6.95 | −37.1% |
| p99 | 14.05 | 9.05 | −35.6% |
| 最大 | 20.05 | 14.05 | −29.9% |
分层之后,p95 是 6.95,比理论地板 8.24 还低。
这是因为地板公式假设的是"纯随机",分层把难度这一层方差消掉了,剩下的方差比纯二项还小。
这也说明一件事:均匀抽样的 11.05 里,有接近 3 个点是"本可以消掉的"。
论文报的降幅是 50.2%(高风险误差),比我的 37.1% 高。差异大概率在基线:我用的分层已经很有效了,他们对比的可能是不分层的简单随机抽样加更多基准的异质性。口径不同,数值不能直接比。
排行榜上的 0.3 分差,抽样误差是多少
这是这篇文章想说的重点。
按前面的公式,抽 n 题估分的标准差是:
sd = √(0.77 × 0.23 / n)反解一下,要分辨多大的差距,需要多少题:
| 想分辨的差距 | 95% 置信需要 | 68% 置信需要 |
|---|---|---|
| 3 个点 | 约 1,510 题 | 约 391 题 |
| 1 个点 | 约 13,589 题 | 约 3,521 题 |
| 0.5 个点 | 约 54,355 题 | 约 14,084 题 |
| 0.3 个点 | 约 150,986 题 | 约 39,121 题 |
算法:两个模型各自独立评测,差值的标准差是单次标准差的 √2 倍。要在 95% 置信下认为差距真实存在,需要 d > 1.96 × √2 × s = 2.77s,反解出 n;68% 那一列把 2.77 换成 1.41。
所以:在一个 100 题的评测上,0.3 分的差距对应的信噪比是 0.07 个标准差。 这不是"略弱",是"完全测不出来"。
看到"我们比上一代提升 0.3 分"这种说法,先看它跑了多少题。500 题以下,这个结论基本都是噪声。
坑清单
1. 每档按比例分配,小档会被分到 0 题。
5 档里最难的占 3%,100 题分 3 题;如果抽样量降到 50 题,按比例只分 1.5 题,取整就可能是 0 或 2。0 题意味着这一档完全没有代表性,估计会系统性地偏乐观。
必须加保底。
2. 分层要求你知道每道题属于哪一档。
这是分层抽样真正的成本。难度标签哪来的?人工标注、历史通过率、还是模型预测?前两个准确但贵,第三个便宜但会带偏差——用 A 模型的通过率给题目分档,再用这个分档去估 B 模型的分数,B 的表现会被 A 的难度判断带偏。
3. 用同一个随机种子跑多次,误差恒等于 0。
我第一版把随机源写成了 rnd(f"{tag}:{b}:{i}"),其中 i 是题号。结果同一个题号在任何一次试验里的结果都一样——等于每次抽到的都是同一批题,误差当然是 0。
修法是让随机源带上试验编号。
4. 把"绝对误差"当"偏差"看。
我算的是绝对误差(|估计 − 真值|),不是偏差(估计 − 真值)。前者永远是正的,后者有正有负。如果你的抽样有系统性偏向(比如题库里难题偏多但你没分层),偏差会明显不为零,而绝对误差看不出来。
两个都要看。
5. 忽略题目之间的相关性。
我的模拟假设每道题独立。真实基准里同一篇文档会出好几道题,同一类推理会重复出现。相关性会让有效样本量小于实际样本量,误差比公式算的更大。
这是你这辈子都消不掉的一层。
结语
这篇的结论很朴素:100 道题测不出 1 个点的差距,这是数学,不是工程。
BestRand 这类方法能压掉一部分误差,但压不到地板以下。想真正分辨小差距,只有两个办法:加题量,或者接受"这个差距测不出来"。
对写评测内容的人来说,这条尤其重要。看到新模型的分数,先问三件事:全量还是抽样、抽了多少、题目怎么选的。三个都答不上来,那个分数就当参考,别当结论。
顺带说,StepBack 那篇里我按同样的思路算过采样预算:省 token 和涨准确率是两件事,别混着看。
上一批写 PLE 时,我特意标了它 85 个任务、29 个公开——按这篇的算法,85 个任务估总分的误差在 10 个点以上,所以那个 50.6% 只能当量级看,不能当精确值比。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。