
一句话总结:Modelers.cn 上架了一个 7B、Apache 2.0、名字里带 1M 的社区模型,但模型卡只有元数据;按 Qwen2.5-7B 的结构算,1M 上下文的 KV 要 56 GiB,是 Q4 权重的 14.3 倍。
华为的昇腾模型平台上新了一个模型,名字叫 COCO-7B-Instruct-1M。
7B、Apache 2.0、名字里写着 1M——三个条件凑齐,对想找"小而长"模型的人来说很诱人。
我去看了模型卡。里面只有元数据。
这件事本身不稀奇,社区微调模型的卡片大多很简陋。但它给了一个很好的例子:怎么在十分钟内判断一份模型宣称值不值得信。
一张只有元数据的模型卡
卡片上有的东西:参数量约 7B、许可证 Apache 2.0、托管平台、下载命令。
没有的东西:训练数据、训练方法、评测结果、使用示例、基座模型的明确说明。
基座是推断出来的——从名字看,大概率是 Qwen2.5-7B-Instruct-1M 的社区微调。但卡片没写。这个"大概率"来自命名惯例,不是声明。
连 "COCO" 这三个字母代表什么,卡片也没解释。
这种卡片在 Hugging Face 上一天能见到几十个。它不违法、不违反协议,Apache 2.0 就是允许你打包分发。但它意味着所有验证成本都转移到你身上。
1M 上下文的 KV 账:56 GiB
名字里那个 1M 是最需要验证的部分。
按 Qwen2.5-7B 的结构算:28 层、4 个 KV 头、head_dim 128、FP16 存 KV。每 token 的 KV 是:
2(K 和 V)× 28 层 × 4 头 × 128 维 × 2 字节 = 57,344 字节 = 56 KiB1M 上下文就是 56 KiB × 1,048,576 = 56 GiB。
Q4 权重是 3.9 GiB。KV 是权重的 14.3 倍。
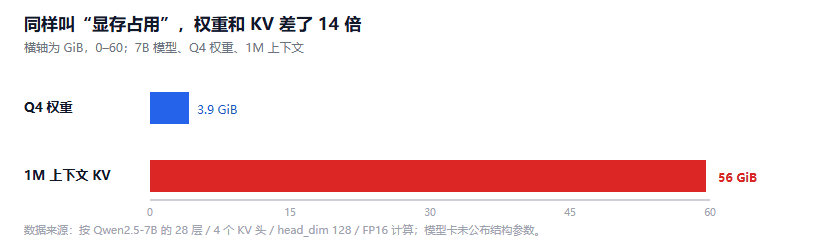
图 1:7B 模型在 Q4 权重与 1M 上下文 KV 的显存占比。数据来源:按 Qwen2.5-7B 公开结构参数计算
这个比例说明什么:"支持 1M 上下文"和"能用 1M 上下文"是两件事。
模型结构上能处理 1M 个 token,不代表你的卡装得下这 1M 个 token 的 KV。
24G 卡的 KV 账:能开 367K token
按不同显存档位算,扣掉权重之后还剩多少给 KV:
| 显存 | 扣掉 Q4 权重 | 能开的上下文 |
|---|---|---|
| 24 GiB | 20.1 GiB | 约 367K token |
| 48 GiB | 44.1 GiB | 约 805K token |
| 80 GiB | 76.1 GiB | 约 1.39M token |
80G 卡上 1M 是成立的。24G 卡上只到 367K——够用,但和"1M"这个卖点差着一倍多。
这个账还建立在两个假设上:层数和 KV 头数按 Qwen2.5-7B 取,KV 用 FP16 存。如果换成 FP8 存 KV,全部数字减半;如果用了 GQA 更激进(比如 2 个 KV 头),再减半。
换句话说,56 GiB 是"标准配置"下的数。真实值可能低一半,也可能高一倍——取决于那个没写出来的 config。
昇腾平台上的「没有适配」
这个模型托管在 Modelers.cn,华为面向昇腾的模型平台。
按理说,上这个平台的模型应该有针对昇腾的适配:MindIE 推理配置、torch_npu 的用法、NPU 优化过的 kernel。
但卡片里一个都没有。
所以现状是:它在昇腾平台上可见,但不是昇腾优化版。 你在昇腾机器上跑它,走的是通用路径,享受不到平台的加速。
这两件事的差别很大。可见 = 能找到;适配 = 能跑好。
五步验证一份模型卡宣称
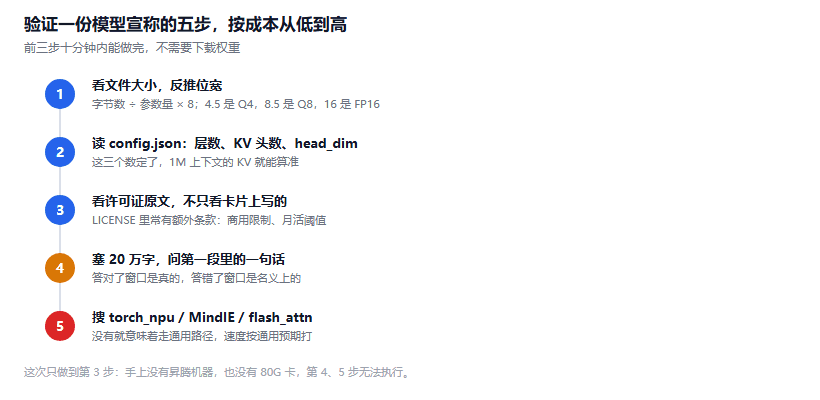
图 2:五步核对,按成本从低到高排序。前三步十分钟内就能做完,后两步要真跑
我把这次做的事整理成五步,按成本从低到高:
- 看文件大小。下载页通常显示总大小。用字节数除以标称参数,得到实际位宽。4.5 左右是 Q4,8.5 是 Q8,16 是 FP16。对不上就说明标称有问题。
- 看 config.json。层数、KV 头数、head_dim 都在里面。有了这三个数,KV 就能算准,1M 到底能不能开一目了然。
- 看许可证原文。卡片写 Apache 2.0 通常可信,但要看有没有附加条款。有些模型在 LICENSE 文件里加了"禁止商用"或者"月活超过 X 需要授权"。
- 跑一个长文测试。塞 20 万字进去,问它第 1 段里的一句话。答对了说明窗口是真的,答错了说明窗口是名义上的。
- 看有没有 kernel 适配。搜
torch_npu、MindIE、flash_attn这些关键词。没有就意味着走通用路径,速度按通用预期打。
前三步我做了,第四第五步没做——我手上没有昇腾机器,也没有 80G 卡。这两步的成本就在这里。
关于 COCO-7B 的五个问题
能商用吗? Apache 2.0 可以,允许修改和再分发。但基座模型如果是 Qwen2.5,原始许可证是 Apache 2.0,链条上没问题。
基座到底是哪个? 名字强烈暗示 Qwen2.5-7B-Instruct-1M,卡片没写。这是最大的不确定项。
7B 做 1M 上下文有意义吗? 有,但要看任务。Gemma 4 那篇算过同一笔账,E2B 的 128K KV 是权重的 5.9 倍——7B 这一档只会更极端。全文检索、长文档摘要这类任务,7B 的召回能力不如大模型。窗口够长不等于读得懂。
为什么放在昇腾平台? 国内开发者的可访问性和合规性考虑。这不代表它是昇腾专属。
值得试吗? 如果你的场景是 24G 卡 + 长文档(30 万字以内),值得。如果真需要 1M,先确认你有 80G 卡。
结语
这个模型本身可能不错,也可能一般。我判断不了,因为没有任何可验证的信息。
但它给了一个很好的练手对象:一份只写了"7B、Apache 2.0、1M"的卡片,你能推出多少东西。
能推出 KV 是权重的 14 倍,能推出 24G 卡到不了 1M,能推出它不是昇腾优化版。这三条都不用下载权重。
上次拆 safetensors 头部是同一个思路:文件里写着答案,只是没人去读。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。