
一句话总结:同一个 prompt,只要同批里塞进别的请求,GPU 的累加顺序就变,浮点结果最后几位就不同;BlockLock 用"只锁被保护请求的计算几何"把这件事修掉,代价是相对 vLLM 的批不变方案延迟降 53.5% 到 55%。
先说一个反直觉的事实:大模型推理不是确定性的。
同一句 prompt,同样的参数,跑两次可能给你不同的字。不是因为采样,temperature 设成 0 也一样。
原因藏在 GPU 的 GEMM 里。
同一个 prompt,batch 里换个邻居就变了
矩阵乘法的累加顺序会影响结果。这是浮点数的老问题:加法不满足结合律。
(a + b) + c 和 a + (b + c) 在实数上相等,在 float32 上可能差最后一位。
GPU 做批量矩阵乘的时候,怎么切分、按什么顺序累加,取决于这一批的形状——batch 里有几个请求、每个请求多长、pad 到多少。同一条请求单独跑,和它跟七个别人一起跑,走的累加路径不一样。
结果就是:输出会变。
这件事平时没人管,因为差的那几位通常翻不动 argmax。但在三种场景里是要命的:审计(要复现某次输出)、A/B 测试(要保证两次只差一个变量)、前缀缓存(缓存键算出来不一致就命中不了)。
BlockLock 只锁住被保护的那条请求
现有的两条路都有明显代价。
一条叫批不变 kernel(batch-invariant kernels):把每个算子的累加顺序都固定死。彻底,但要重写大量 kernel,性能也塌。
另一条是把 prefill 隔离出来,decode 用固定形状加 padding。缺点是放弃了共享 prefill 的计算,还要为 padding 白算。
BlockLock 走第三条:保留共享的批量 prefill,只固定被保护请求看到的那部分几何形状。
两种模式:
- BlockLock-Rows:用固定宽度的行,所有请求的批量 decode 照旧,只保证被保护那条的行形状不变
- BlockLock-Pack:终端锚定打包,塞一个隔离的 dummy 段,然后把被保护请求的 KV 状态提取出来,做 target-only decode
论文在五个稠密模型(Qwen3-8B/14B、Llama-3.1-8B-Instruct、Gemma-3-4B/12B-IT)和三种单卡(A6000、A100、H100)上测,报告"目标序列和 Top20 logit 逐位一致"。
我用 float32 复现 BlockLock 的误差:2.6e-6
拿不到 GPU,我用 numpy 复现了机制:4096 维的点积,按不同分块大小累加,模拟不同 tiling。
def logits(x, chunk):
    prod = (x[:, None] * W).astype(np.float32)
    parts = prod.reshape(K_DIM // chunk, chunk, N_CLASS).sum(axis=1, dtype=np.float32)
    acc = np.zeros(N_CLASS, dtype=np.float32)
    for row in parts:                      # 按分块顺序串行累加
        acc = (acc + row).astype(np.float32)
    return acc
chunk 就是"切多大一块",换成 GPU 上的说法就是 tile 形状。跑 3000 组输入,比较 chunk=4096 和 chunk=32 的结果:
| 指标 | 数值 |
|---|---|
| logit 绝对误差中位 | 2.62e-6 |
| 误差 p99 | 7.39e-6 |
| 误差最大 | 1.14e-5 |
| argmax 翻转率 | 0.00% |
误差是真实存在的,量级 10⁻⁶。但 600 组随机输入里,argmax 一次都没翻。
第一反应是"这个问题没那么严重"。往下算才发现不是。
要多小的间距才会翻转
翻转的条件很简单:两个候选的分数差距小于误差。
人工构造一对"近似并列"的候选,让它们的权重只差一个极小量,测翻转率:
| 两个候选的相对差距 | argmax 翻转率 |
|---|---|
| 1e-2 | 0.0% |
| 1e-4 | 0.2% |
| 1e-6 | 24.6% |
| 1e-8 | 45.0% |
差距到 1e-6 就开始翻,到 1e-8 已经是掷硬币。
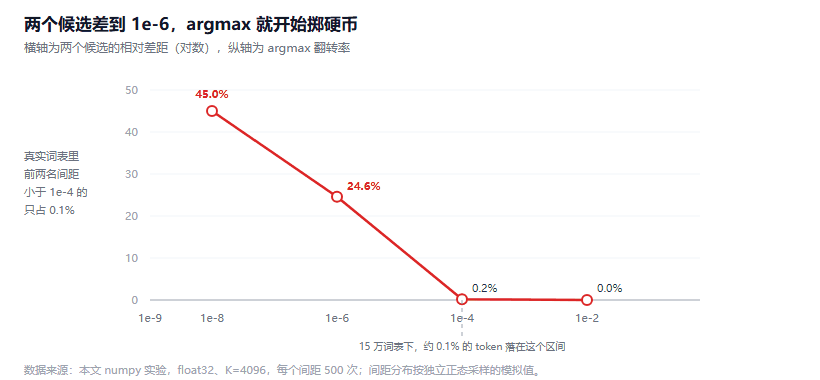
图 1:横轴为两个候选的相对差距(对数),纵轴为 argmax 翻转率。数据来源:本文 numpy 实验,每个间距 500 次
那么真实词表里,前两名差距小到什么程度的样本有多少?
按 15 万词表、分数近似独立正态采样:
| 词表规模 | 前两名间距中位 | 间距 < 1e-4 的占比 |
|---|---|---|
| 8 | 0.43 | 0.0000% |
| 1,000 | 0.21 | 0.2000% |
| 150,000 | 0.15 | 0.1000% |
1e-4 以下的占 0.1%。乘上该量级的翻转率 0.2%,单步翻转概率约 2×10⁻⁶。
逐位一致的代价:53.5% 的延迟
单步 2×10⁻⁶ 听着可以忽略。但一层里有多个 GEMM,一个 token 过 60 层,一条回答 200 个 token。
按 60 层算,每个 token 至少 60 次翻转机会:60 × 2e-6 = 1.2e-4。200 个 token 累积:1 − (1 − 1.2e-4)^200 ≈ 2.4%。
也就是说,每 40 条长回答里,大概有一条会出现至少一位不同。
而一位不同就够了——生成的 token 一变,后面所有的 KV 都跟着变,整条序列分叉。所以"差一位"和"完全不同"是一回事。
这就是 BlockLock 值得做的原因,也是它那个代价的由来:
| 对比对象 | 延迟 | 吞吐 |
|---|---|---|
| BlockLock-Rows vs vLLM Batch-Invariant | −53.5% ~ −55.0% | +115.2% ~ +122.2% |
注意这个对比的方向。 是"比 vLLM 的批不变方案快 53%",不是"比普通 vLLM 快 53%"。普通 vLLM 本来就不保证逐位一致,不在同一个比较维度里。
这个区别很关键,我看到不少转述把它写成"延迟降低 53%",读者会以为是白捡的。
坑清单
1. 把对比基线读错。
"相对 vLLM Batch-Invariant 延迟降 53.5%"和"延迟降 53.5%"是两回事。前者说明 BlockLock 比已有方案好,后者暗示比不开保护快——后者不可能,任何一致性保护都要付代价。
2. 以为 temperature=0 就是确定性的。
贪心解码只保证"给定同一组 logits 选最大的那个",不保证 logits 一样。logits 变了,argmax 就可能变。
3. 用 CPU 的 float32 结果推 GPU 的误差。
我在 numpy 上测出的 2.6e-6 是模拟值。真实 GPU 用 TF32、FP16、甚至 FP8 累加,误差量级完全不同,通常更大。这条数据只能说明机制,不能说明量级。
4. 忽略 padding 的影响。
batch 里最长的请求决定 pad 长度。同一个请求,跟一个 100 token 的邻居同批,和跟一个 8000 token 的邻居同批,pad 后的形状完全不同。这是最容易复现的一种不一致。
5. 只比最终文本,不比 logits。
两段文本一样不代表 logits 一样。论文特意报了"Top20 logit 逐位一致",比只看文本严得多。要做缓存键,必须比 logits。
结语
这件事的价值在于它划清了一条线:推理的可复现性不是免费的,它是一项要单独买的功能。
日常对话用不上,差一位没人发现。但审计、回归测试、缓存一致性这三类场景,必须有。BlockLock 的意义是把这个功能的价格从"重写 kernel"降到"多付一半延迟"。
上次拆 safetensors 头部是从文件里读答案,这次是从浮点数的行为里读答案。两者都不是黑魔法,是有人愿意去算。
我这次测出来的翻转率是 0,看起来像"问题不存在"。但把 margin 扫一遍就知道,问题在等一个足够小的间距。没测出来不等于没有,可能只是样本不够刁钻。
参考资料
- BlockLock: Reproducible LLM Inference with Fixed Batch Geometry(arXiv 2611.06977)
- BlockLock 实现比特级可复现的大语言模型推理(Global AI News)
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。