
一句话总结:Meta 无限期暂停了那条允许它抓取商业账户网站内容的条款,原定 11 月 20 日生效;让它停下来的不是站长的抗议,是挪威的禁令、巴西的裁决和英国的调查。
11 月 20 日这个日期,本来是 Meta 新服务条款的生效日。
过了这天,只要你有 Meta Business 账户,Meta 就有权抓取你网站上的内容,用于广告和商业产品。
现在这个日期取消了,无限期暂停。
对做内容站的人来说,这是好消息。但我读完整个经过,高兴不起来。
条款原定 11 月 20 日生效,现在无限期暂停
Meta 自己的措辞很短:这些更新现在暂停,不会在 2026 年 11 月 20 日生效。
注意"暂停"这个词。暂停不是撤回。公告里没有一个字说底层计划变了,Meta 说的是"花时间把它做对"——这是等一个安静月份的措辞。
所以这件事的结论应该是:时间表停了,意图没停。
三次妥协都没用,起作用的是法院
把时间线拉出来看,会看到一个很典型的模式。
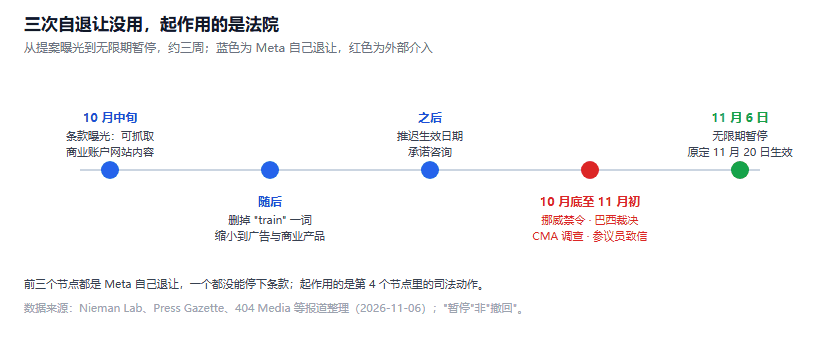
图 1:从提案曝光到暂停的五个节点。前三次是 Meta 自己退让,后三次是外部力量介入。数据来源:Nieman Lab、Press Gazette、404 Media 等报道整理
10 月中旬,提案被记者曝光。Meta 的反应是删掉条款里"train"这个词:原来明确写训练,改成了模糊表述。
然后是缩小范围:从"所有内容"缩到"广告和商业产品"。
然后是改日期、承诺咨询。
三次退让,一次都没让它停下来。
真正起作用的是三件事:
挪威法院批了初步禁令,起因是 10 家媒体联合起诉。巴西法院禁止未经授权使用新闻内容。英国竞争与市场管理局(CMA)对 Meta 是否对出版商和广告主施加剥削性条款开了正式调查。
再加上美国两位参议员 Schiff 和 Blackburn 联名致信扎克伯格要求撤回。
三个司法辖区 + 两位议员,这才让条款停下来。
这个顺序值得记住:舆论施压让 Meta 改措辞,法律行动才让它改行为。
为什么内容站高兴不起来
三个原因。
第一,暂停不等于撤回。 这次能暂停,是因为三地同时施压,时间点还撞在一起。下次换个时间、换个措辞、拆成几批慢慢来,未必还有这个阵仗。
第二,你个人做什么都改变不了。 条款是格式合同,你点了同意就生效,不接受就只能注销账户。单个站长没有议价能力,也没有起诉的预算。挪威那 10 家媒体能赢,是因为它们联合起来、有律师、有行业组织支持。
第三,也是最现实的一条:这类条款会继续出现。 数据是训练原料,只要原料还短缺,抓取的冲动就在。今天 Meta 退了一步,明天可能是另一家,换个说法——比如"用于改善服务质量"。
所以正确的姿势不是庆祝,是准备。
你的 robots 挡得住吗
上周我把自家站的 robots.txt 跑了一遍,12 个 AI 爬虫逐个测,结论是全放行——站里 10 条规则,没有一条针对 AI 爬虫,全走通配符。
当时的判断是"不单独声明等于放行"。现在再加上这一层:就算你在 robots 里明确禁止,也只对守规矩的爬虫有效。
robots.txt 是行业惯例,不是法律。它没有强制力。一个不遵守它的爬虫,你拿它没办法——除非你有证据去起诉,而起诉的前提是你能证明它抓了。
这就把问题推到下一节。
内容站现在该做的三件事
第一,把 robots.txt 写具体。
别只写 User-agent: *。把已知的 AI 爬虫逐个列出来,明确 Disallow。不是为了拦住所有人,是为了在争议发生时,你能证明"我明确表达过不同意"。
这在法律上叫"权利保留声明",是后续维权的基础。
第二,留日志。
访问日志至少保留 90 天,包含 UA、IP、请求路径、时间。真到了要举证的那天,"某年某月某日某 IP 用某个 UA 抓了 3000 页"是最硬的证据。
很多站默认不存或者只存 7 天,等想起来已经没了。
第三,把内容分层。
不是所有内容都值得保护。新闻、原创分析、数据表格,这些是资产;转载的、通稿、企业介绍,抓走也无所谓。
分层之后,robots 和相关声明可以写得更精确,也更能说明"我保护的是有价值的部分"——这个区分在法庭上比"全都别抓"更有说服力。
关于抓取条款的五个问题
暂停是永久的吗? 不是。Meta 说的是"暂停",没有撤回。它的原话是花时间做对,这个表述留了后路。
我的网站会被抓吗? 如果你有 Meta Business 账户并且同意过旧条款,旧条款仍然有效。新条款暂停只是不加码,不等于收回已有的授权。
robots.txt 有法律效力吗? 没有强制力,但它是"明确表达意愿"的证据。多起案件里,robots 声明被当作权利保留的依据。
普通站长能起诉吗? 单独很难,成本撑不住。可行的路径是加入行业组织、联合维权,或者等监管机构介入后作为受害方主张赔偿。
这件事对国内站有影响吗? 直接抓取的可能性低,但条款逻辑是一样的。国内的平台协议也常有类似的授权条款,签之前该看的还是得看。
结语
这次的结果对内容站是好消息,但它证明的是一件让人不太舒服的事:规则不是靠道理改的,是靠成本改的。
Meta 改措辞,是因为舆论成本;Meta 停手,是因为法律成本。前者便宜,后者贵。
对个体站长来说,能做的只有两件:把自己的意愿表达清楚(robots + 声明),把可能的证据留下来(日志)。剩下的,交给有预算的人去打。
顺带说,监管这条线今年动得很密。欧盟 AI 法和乌镇倡议同一周落地那次,我整理过内容站要准备的东西,和这次的抓取条款是两条线:一条管你怎么标注内容,一条管别人能不能拿走。
参考资料
- 参考资料
发表评论
◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。